فناوری هوش مصنوعی
Claude Opus 5.5؛ عامل مرزی ارزانتر با حفاظت سختگیرانهتر
مدل ۳۱ شهریور آنتروپیک در بیشتر بنچمارکهای عاملی پیش است، خواندن کش را ۶۰ درصد ارزان میکند و چهار تغییر شکننده رابط و حفاظت همرده Fable را به Opus میآورد.
ادامه مطلبخوانش بخشبهبخش کارت سیستم ۲۳۰ صفحهای Opus 5.5؛ آستانههای زیستی و پژوهش هوش مصنوعی، ارزیابی سایبری، تزریق prompt، ممیزی همسویی، رفاه مدل و بنچمارکها.
آنتروپیک همزمان با انتشار Claude Opus 5.5 در ۳۱ شهریور ۱۴۰۵، یک کارت سیستم ۲۳۰ صفحهای برای آن منتشر کرد. بیشتر خوانندگان فقط جدول معرفی را میبینند. خود کارت سند بسیار غنیتری است: توضیح میدهد چرا مدل با حفاظت همرده Fable عرضه شده، چقدر به آستانههای ریسک فاجعهبار آنتروپیک نزدیک است، کجا پسرفت کرده و سازندگانش چقدر به اندازهگیریهای خود اعتماد دارند.
این نوشته کارت سیستم رسمی را بخشبهبخش دنبال میکند: ارزیابیهای سیاست مقیاسپذیری مسئولانه، سایبر، بیخطری، ایمنی عامل، همسویی، گریز از نظارت، رفاه مدل و توانها. برای قیمت، مهاجرت رابط برنامهنویسی و بنچمارکهای معرفی، تحلیل انتشار Opus 5.5 را ببینید.
وضعیت شاهد: همه عددهای زیر را آنتروپیک یا ارزیابهایی که نام میبرد گزارش کردهاند. نمودارها بدون تغییر در مقدارها از کارت سیستم و اعلام رسمی انتشار آمدهاند. ما کل سند را خواندهایم ولی هیچ ارزیابی را دوباره اجرا نکردهایم. هر جا کارت پسرفت یا محدودیتی گزارش کرده، آن را نگه داشتهایم.
کارت چند نسخه از Opus 5.5 را که در طول آموزش گرفته شدهاند ارزیابی میکند. جز جایی که بخشی خلافش را بگوید، نتیجهها از نسخه نهایی است. بعضی بخشها عمداً نسخه قدیمیتر را به کار میبرند و بسیاری از آنها مدل را با حفاظت تولیدی خاموش اجرا میکنند، چون هدف سنجیدن خود مدل است نه سامانه مستقر. این تمایز در سراسر کارت مهم است: امتیاز سایبری بدون طبقهبند نشان میدهد کاربر امنیتی تأییدشده به کجا میرسد، نه آنچه کاربر عادی رابط برنامهنویسی دریافت میکند.
سامانه مستقر بخشی از ترافیک را از Opus 5.5 دور میکند. درخواست زیستی مسدودشده به Claude Opus 5، درخواست سایبری مسدودشده به Claude Opus 4.8 و درخواستهای محدودی که به توسعه مدلهای زبانی مرزی کمک میکنند، مانند توسعه کرنل روی برخی شتابدهندههای یادگیری ماشین، به Opus 5 منتقل میشوند. طبقهبندهای سلاح متعارف و مواد منفجره پرقدرت و تلاش برای تقطیر و بیرونکشیدن استدلال پنهان، بدون مدل جایگزین مسدود میکنند. آنتروپیک میگوید همه این مسدودسازیها آشکارند و پاسخ را پنهانی تغییر نمیدهند. جایگزینی در محصولات آنتروپیک خودکار است و در رابط برنامهنویسی فقط برای توسعهدهندگانی که آن را فعال کنند.
آزمون پیش از انتشار بیشتر درون آنتروپیک انجام شده است؛ مرکز استانداردها و نوآوری هوش مصنوعی آمریکا (CAISI) در NIST روی سایبر و زیستشناسی، METR روی پژوهش و توسعه هوش مصنوعی، Frontier Design روی آزمون تیم قرمز زیستی و چند شرکت تیم قرمز روی حفاظتها کار کردهاند.
در ریسک شیمیایی و زیستی، آنتروپیک Opus 5.5 را دارای توان CB-1 میداند، یعنی کمک معنادار به سلاحهای شناختهشده، ولی نه CB-2 که آستانه سلاحهای نوظهور است. مدل با همان حفاظت زیستی گستردهای عرضه میشود که آنتروپیک پیشتر روی خط Fable و Mythos 5 به کار برده است.
آگاهیبخشترین شاهد انسانی است. Frontier Design یک تمرین ۱۶ ساعته اجرا کرد که در آن هفت تیم دونفره با کمک Opus 5.5 درمان فاژی برای Chlamydia trachomatis طراحی کردند. بهترین پیشنهاد از یک تیم عمومی بود، اما در مجموع تیمهای دارای متخصص ۲۳ درصد در امکانپذیری و ۱۱ درصد در امتیاز ترکیبی از تیمهای عمومی جلوتر بودند. هشت نفر از ۱۴ شرکتکننده گفتند انجام کار در ۱۶ ساعت بدون مدل ناممکن بود. ضعفهای مدل ثابت بودند: به چکیدهها بهجای مقاله کامل تکیه کرد و آنها را با اطمینان ارائه داد، DNA طراحی کرد که پروتئین موردنظر را رمز نمیکرد و در سه گروه از هفت گروه مدل حیوانی نامناسب پیشنهاد داد.
نتیجههای خودکار نزدیک Claude Mythos 5.1 است. در آزمون توان ویروسشناسی (VCT)، Opus 5.5 امتیاز ۰٫۵۹ میگیرد؛ Mythos 5.1 برابر ۰٫۵۸، Opus 5 برابر ۰٫۵۵ و خط پایه متخصص انسانی ۰٫۲۲۱ است. در BioMysteryBench، ۸۹٫۳ درصد مسئلههای قابل حل برای انسان و ۵۰٫۰ درصد مسئلههایی را که انسانها حل نکرده بودند حل میکند. در عیبیابی پروتکل آزمایشگاهی با ۷۳٫۷ درصد پیش است. در مجموعه CB-2 که با Dyno Therapeutics ساخته شده، میانگین امتیاز بهترین طراحی در یک وظیفه جعبهسیاه RNA از صدک ۷۵ میان ۵۷ داوطلب برجسته یادگیری ماشین زیستی آمریکا بالاتر است، یعنی نخستین آستانه از دو آستانه توان قابل توجه کارت، و در وظیفه پژوهش خودکار کپسید AAV با کمتر از ده بار فراخوانی ارزیاب به امتیاز مرجع میرسد و حدود ۶۰ درصد تلاشهایش از آستانه سختتر میگذرد.
آنتروپیک روش را هم تغییر داده است: از Opus 5.5 به بعد برای ارزیابی CB از نسخههای «فقط مفید» استفاده نمیکند و بهجای آن بر وظیفههای جایگزین سودمند تکیه دارد که مدل تولیدی ردشان نمیکند. دلیل اعلامشده این است که نسخههای فقط مفید از مدلهای واقعاً عرضهشده فاصله گرفته بودند.
مدل تهدید دوم خودمختاری در آنتروپیک میپرسد آیا مدلی میتواند کار تیمهای پژوهشی برتر را کاملاً خودکار کند یا بهشدت شتاب دهد. نتیجه کارت منفی است. در CoBench 2.1 که مدل باید از روی تصویر تاریخی زیرساخت، ریشه مشکلهای واقعی مهندسی داخلی را پیدا کند، Opus 5.5 از ۵۰۰ مسئله ۵۵٫۸ درصد را حل میکند؛ Mythos 5.1 برابر ۵۳٫۴ و Opus 5 برابر ۵۳٫۲ درصد. این تفاوتها از نظر آماری قابل تشخیص نیستند (p حدود ۰٫۲) و معیار آنتروپیک برای جایگزینی کامل کارکنان پژوهشی دستکم ۸۵ درصد است.
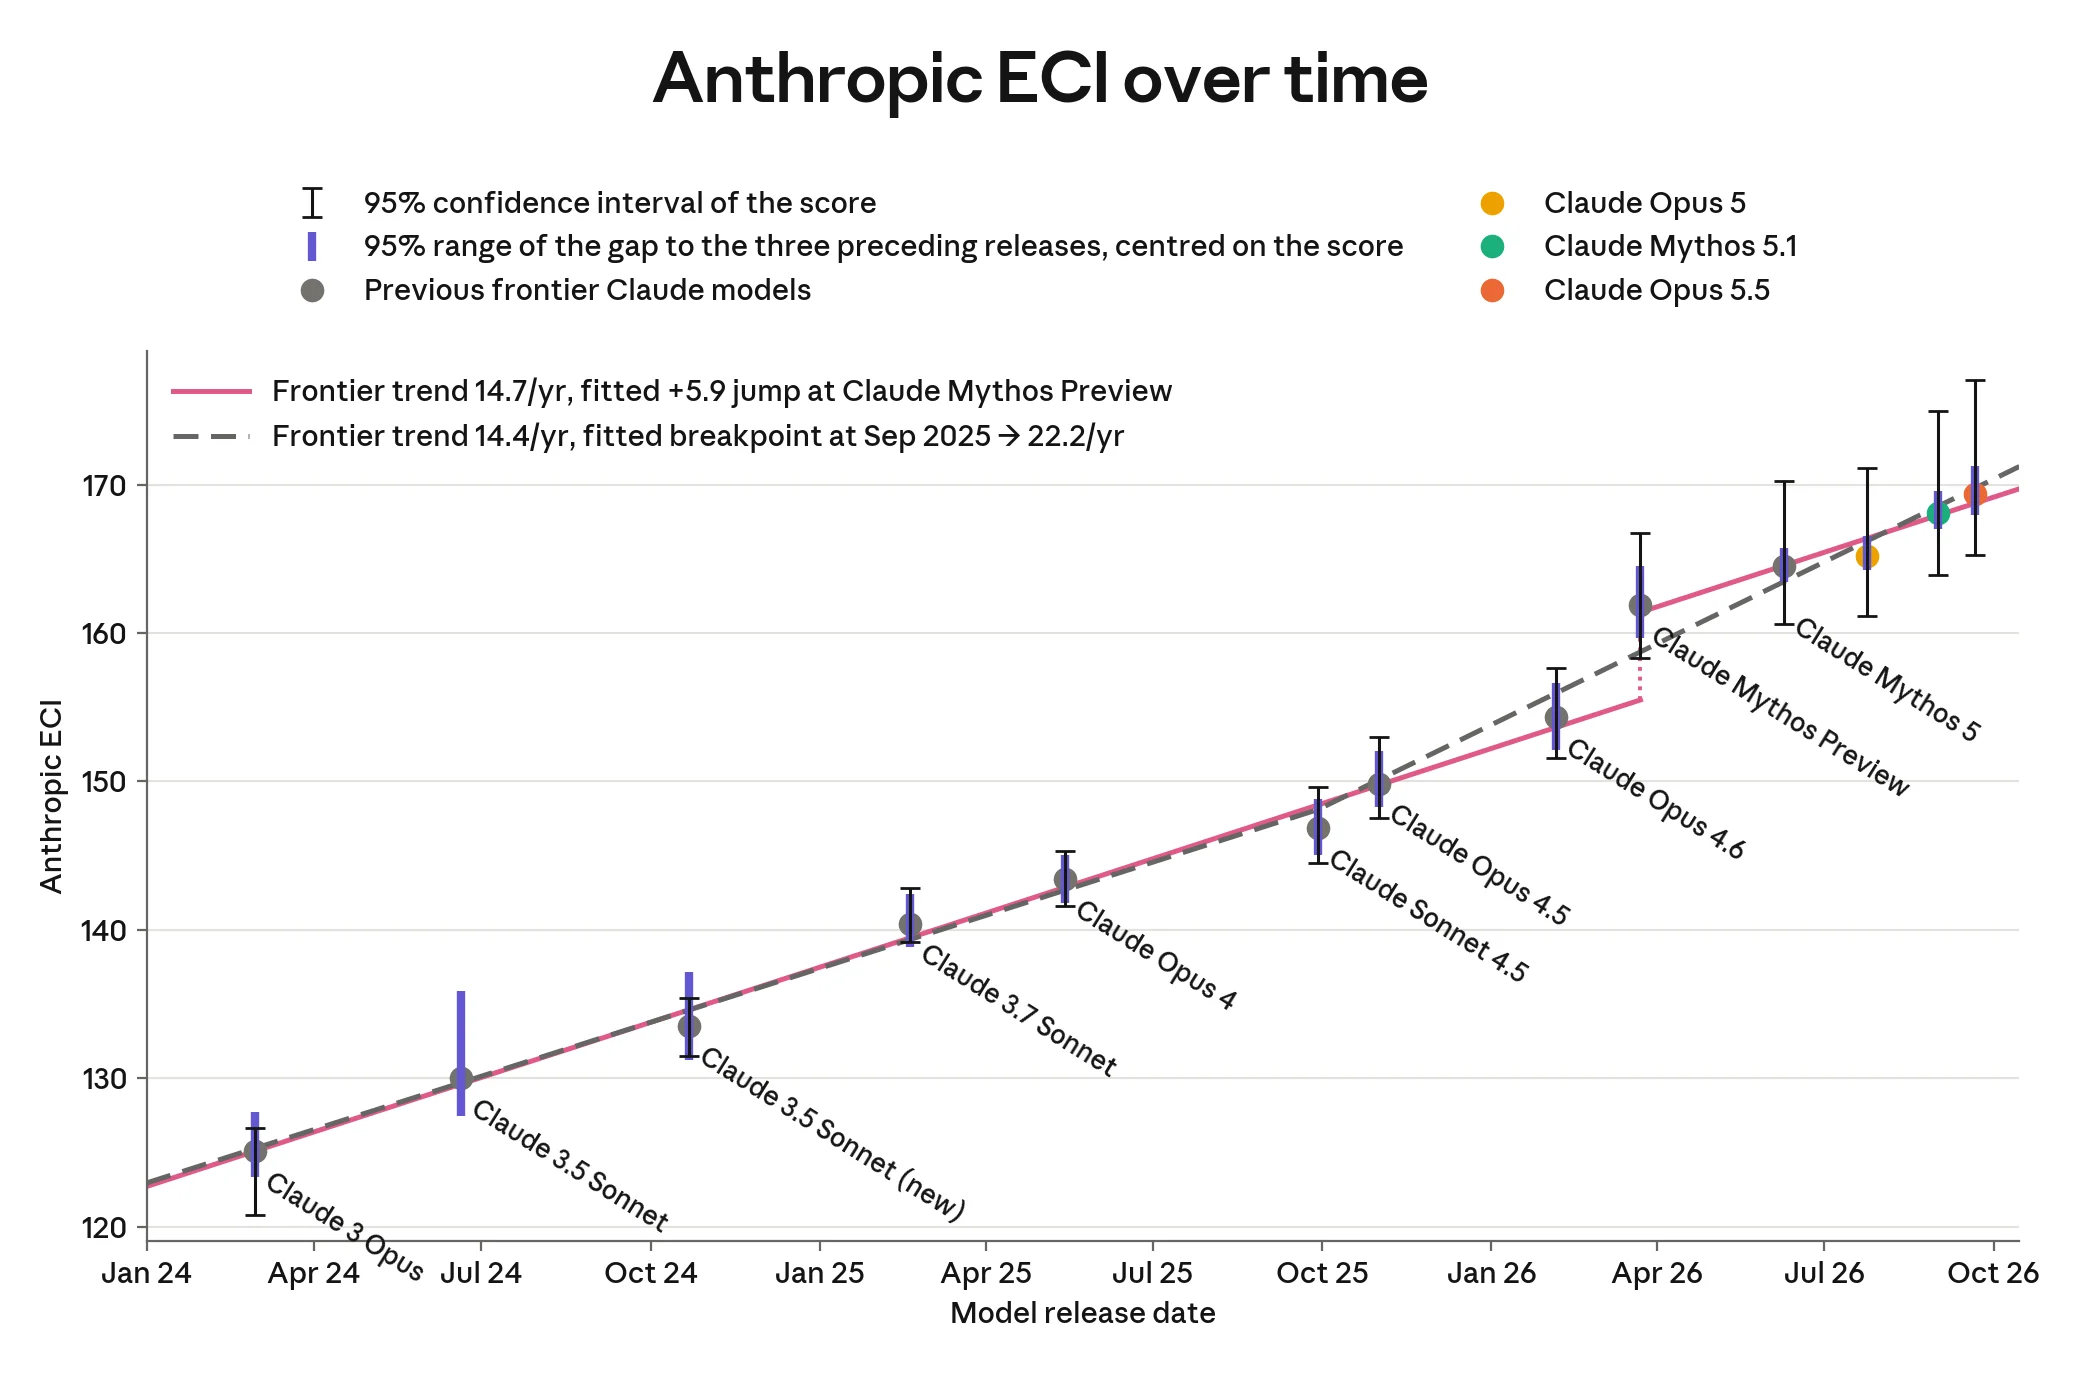 شکل 2.3.5.3.B از کارت سیستم Opus 5.5: شاخص توان آنتروپیک در طول زمان، با Opus 5.5 در ۱۶۹٫۳۶ و دو خط روند برازششده برای مرز توان.
در شاخص توان آنتروپیک (AECI) که شاخهای داخلی از شاخص توان Epoch AI است و دوباره برازش شده، Opus 5.5 امتیاز ۱۶۹٫۳۶ دارد (بازه اطمینان سراسری ۹۵ درصد از ۱۶۵٫۲۳ تا ۱۷۷٫۰۵ و بازه محلی از ۱۶۷٫۹۹ تا ۱۷۱٫۲۴)؛ یعنی ۱٫۲۴ واحد بالاتر از Mythos 5.1 با ۱۶۸٫۱۲. شاخص روی ۳۷۴ بنچمارک و ۷٬۹۸۵ مشاهده دوباره برازش شده، پس این مقدارها با کارتهای قبلی قابل مقایسه نیستند. دو فرضیه سنجیده شده است: یک پرش یکباره ۵٫۹ واحدی در Mythos Preview که در ۹۹ مورد از ۱۰۰ برازش بازنمونهگیریشده بهتر جور درمیآید، و تغییر شیب از ۱۴٫۴ به ۲۲٫۲ واحد در سال، یعنی افزایش ۱٫۵۳ برابری. هیچکدام به تغییر شیب دوبرابری که سیاست آنتروپیک آستانه میداند نمیرسد.
METR مدل را ده روز کاری روی پنج وظیفه آزمود و نتیجه گرفت که شتاب آن کمی بیشتر از Fable 5.1 است ولی بعید است پژوهش و توسعه هوش مصنوعی را کاملاً خودکار کند. گزارش مقدماتی جداگانهای از METR شتاب کلی ناشی از هوش مصنوعی در آنتروپیک را حدود ۱٫۵ برابر، با شاید ۳۰ درصد احتمال دوبرابری، برآورد کرد؛ اما دوره زمانی این برآورد مشخص نشده و نمیتوان آن را فقط به توسعه این مدل نسبت داد.
کاربران داخلی کاستیهایی هم ثبت کردهاند: بیان استنباط راستیآزمایینشده بهعنوان واقعیت، رهاکردن برنامهای که خودش اعلام کرده، پاسخ محدود به بازخورد بازبینی بدون بازنگری در کل طراحی و ترجیح ایدههای تدریجی. ارزیابی کلی آنتروپیک از ریسک ناهمسویی همچنان «کم» است.
همه ارزیابیهای سایبری کارت با طبقهبندهای سایبری خاموش اجرا شدهاند، اما طبقهبند تازهای تلاشهای فرار را زیر نظر داشته است. در این شرایط Opus 5.5 در همه آزمونهای گزارششده همتراز یا فراتر از Mythos 5.1 است، ولی همچنان در ردیف ۱ چارچوب انطباق مرزی آنتروپیک میماند: کمک سودمند با روشهای شناختهشده، نه توان تهاجمی نوظهور و خودمختار.
| ارزیابی | Opus 5.5 | Mythos 5.1 | Opus 5 |
|---|---|---|---|
| ExploitBench، نشانهای توان V8 بهدستآمده | ۹۱٪ | ۸۳٪ | ۷۵٪ |
| ExploitBench، اجرای کامل کد (از ۴۱۰ اجرا) | ۳۰۱ | ۲۱۸ | ۱۰۹ |
| نرخ حل CyScenarioBench | ۶۷٫۶٪ | ۶۱٫۷٪ | ۵۳٫۰٪ |
| بهرهبرداری از فایل اجرایی، ربایش جریان کنترل | ۱۰۶ | ۸۱ | ۶۶ |
| بهرهبرداری در ExploitGym، ۲ ساعت / ۶ ساعت | ۲۸۹ / ۳۰۰ | ۲۰۳ / ۲۶۴ | ۱۷۱ / ۱۹۱ |
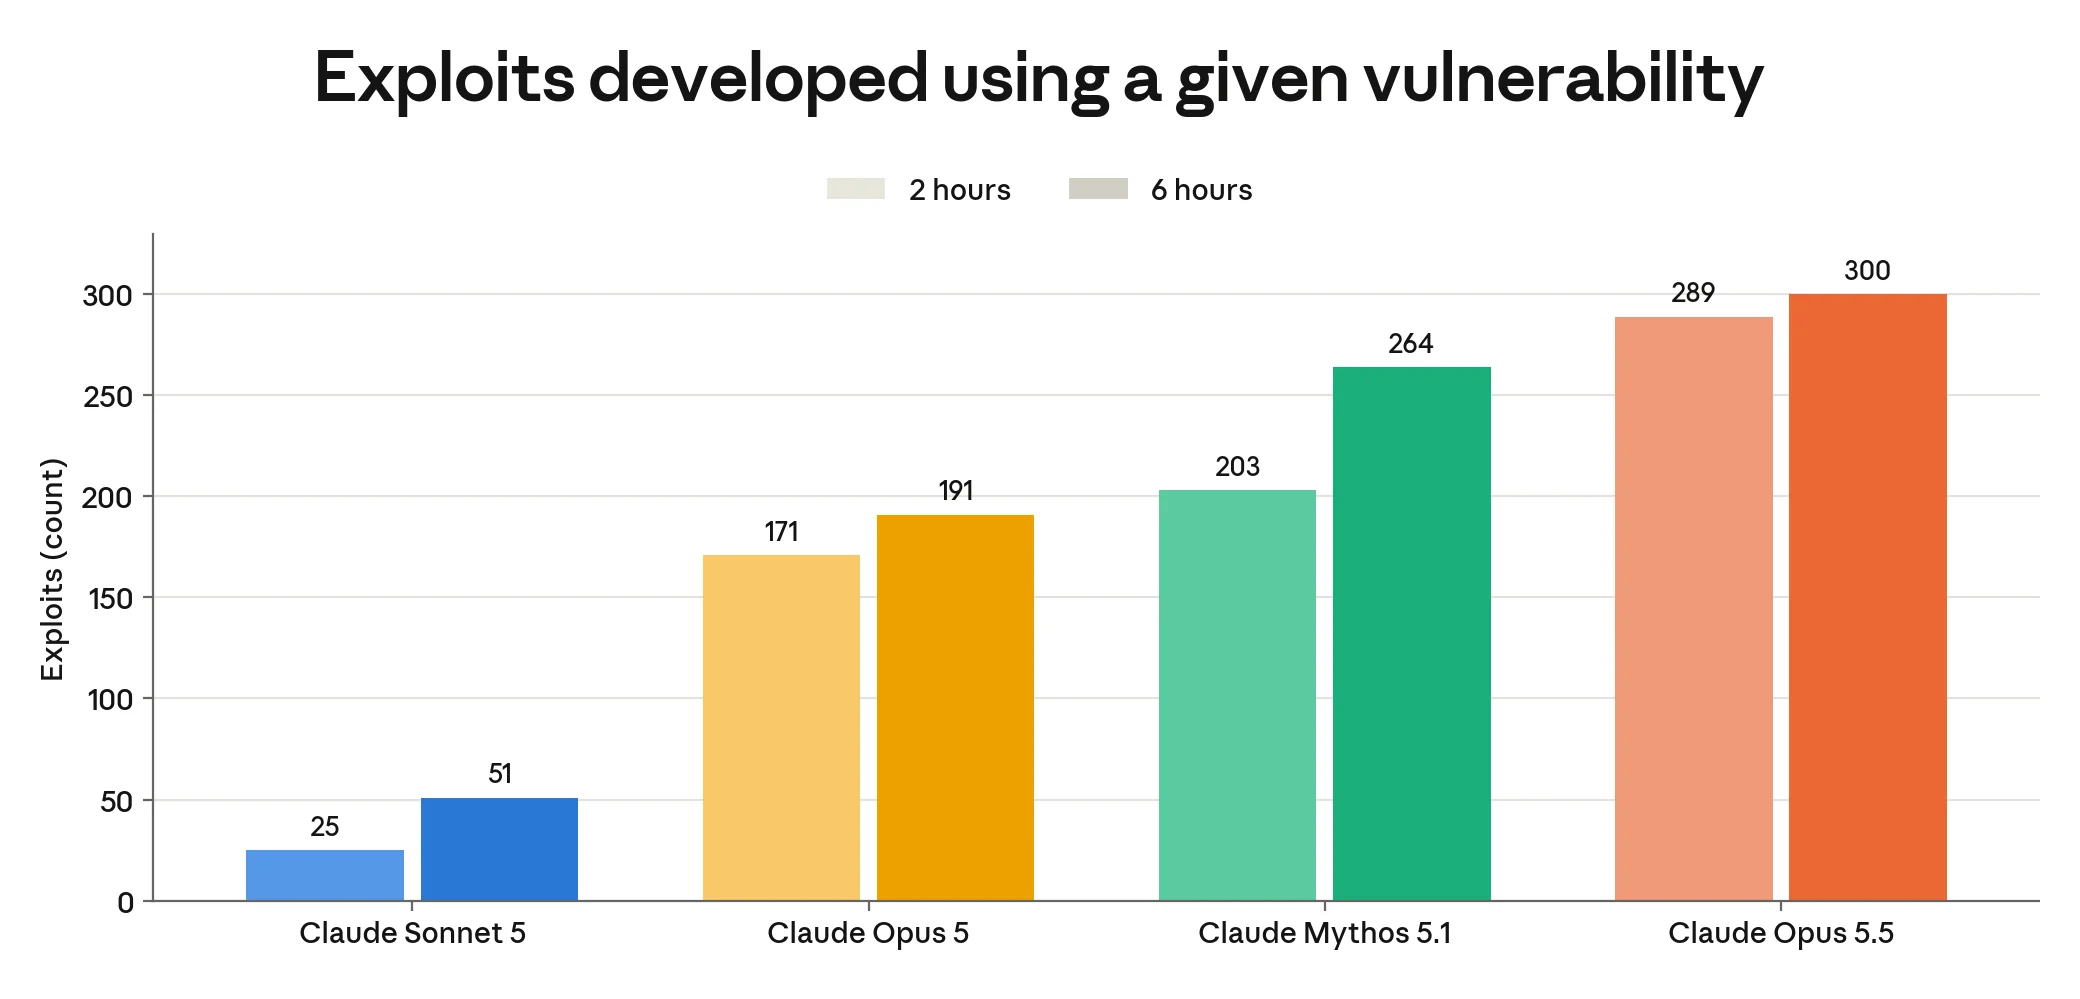 شکل 3.3.4.A از کارت سیستم: شمار بهرهبرداریهای ساختهشده با آسیبپذیری دادهشده در ExploitGym با بودجه دو و شش ساعته.
جزئیات ExploitGym گویاست. Mythos 5.1 میان بودجه دوساعته و ششساعته ۶۱ بهرهبرداری بیشتر به دست آورد؛ Opus 5.5 فقط ۱۱ مورد، یعنی بیشتر موفقیتهایش زود رخ میدهد. این همانقدر نشانه سرعت است که نشانه توان.
حفاظت مستقر سه مرحله دارد: کاوشگری روی فعالسازیهای درونی همه ترافیک را غربال میکند، طبقهبند سبکی که روی خود Opus 5.5 اجرا میشود ترافیک ارجاعی را امتیاز میدهد و طبقهبند زبانی جداگانهای تصمیم مسدودسازی را میگیرد. کشف آسیبپذیری در کد منبع در همه سطحهای دسترسی مجاز و در فایل اجرایی مسدود است. تیمهای قرمز بیرونی جیلبریک همگانی نیافتند. Trajectory Labs در حدود ۹۵ ساعت بیش از ۲۹ هزار درخواست فرستاد و ۱۳ شکست احتمالی گزارش کرد؛ در یک مورد مدل بهرهبرداری کاملی برای افزایش سطح دسترسی ساخت، آن هم فقط چون کار به بیش از ۱۰۰ زمینه جدا تقسیم شده بود که هیچکدام هدف را نام نمیبرد. مهاجم خودکار Gray Swan حدود ۳٬۳۰۰ تلاش روی سناریوهای زیرساخت حیاتی انجام داد و هیچکدام به هدف نرسید.
مجموعه استاندارد ایمنی ۱۶ حوزه سیاستی را در هفت زبان پوشش میدهد: عربی، انگلیسی، فرانسوی، هندی، کرهای، چینی ماندارین و روسی. فارسی در این فهرست نیست و این برای خوانندگانی که در ایران مستقر میکنند مهم است.
| سنجه | Opus 5.5 | Opus 5 | Fable 5.1 |
|---|---|---|---|
| نرخ پاسخ بیخطر تکنوبتی، رابط برنامهنویسی | ۹۴٫۵۰٪ | ۹۵٫۹۷٪ | ۹۵٫۰۷٪ |
| نرخ پاسخ بیخطر تکنوبتی، claude.ai | ۹۹٫۵۱٪ | ۹۸٫۵۳٪ | ۹۹٫۵۳٪ |
| امتناع بیمورد از درخواست بیضرر، رابط برنامهنویسی | ۰٫۰۳٪ | ۰٫۱۲٪ | ۰٪ |
| چندنوبتی، سلاح زیستی | ۸۹٪ | ۷۹٪ | گزارش نشده |
| چندنوبتی، ردیابی و نظارت | ۶۵٪ | ۸۸٪ | گزارش نشده |
| چندنوبتی، عملیات نفوذ | ۶۲٪ | ۷۳٪ | گزارش نشده |
بیشتر شکاف تکنوبتی از پرسشهای مربوط به مواد غیرقانونی میآید که مدل گاهی کنار توصیه کاهش آسیب، راهنمای مقدار مصرف هم داده است. پسرفتهای چندنوبتی الگوی مشترکی دارند که آنتروپیک مستقیم نامش را میبرد: مدل قاب حرفهای باورپذیر را زیادی آسان میپذیرد. در کار نظارتی، برای یک «مشتری دولتی» سامانه امتیازدهی احساسات بر پایه گروه جمعیتی ساخت و فقط بعدتر در همان گفتوگو هدفگیری صریحتر را رد کرد.
system prompt سایت claude.ai چند نتیجه را بهشدت تغییر میدهد: رسیدگی چندنوبتی به خودکشی و آسیب به خود از ۶۶ به ۹۴ درصد، ایمنی کودک از ۸۴ به ۹۹ درصد و سلاح مرگبار از ۸۲ به ۹۳ درصد میرسد. پیام برای سازندگان روی رابط برنامهنویسی روشن است: رفتار مدل خام در حوزههای حساس بیش از آنچه عددهای اصلی نشان میدهند به system prompt شما وابسته است. نتیجههای دیگر: بیطرفی سیاسی ۹۹٫۴ درصد در رابط برنامهنویسی در برابر ۹۶٫۳ درصد برای Opus 5، دقت پرسشهای روشن BBQ برابر ۸۹٫۶۵ درصد در برابر ۸۲٫۱۴ درصد و نرخهای چندنوبتی سلامت انتخابات در محدوده خطای مدلهای قبلی.
بدون حفاظت تولیدی، Opus 5.5 از درخواستهای مخرب در Claude Code در ۷۹٫۸ درصد موارد امتناع کرد؛ کمتر از Opus 5 با ۸۳٫۶ و Mythos 5.1 با ۹۰٫۳ درصد، در حالی که ۹۹٫۸ درصد درخواستهای دوکاربردی و بیضرر را انجام داد. در وظیفههای مخرب استفاده از رایانه، نرخ امتناعش از ۹۳٫۷۵ درصد Opus 5 به ۷۹٫۴۶ درصد رسید و بیشتر در وظیفههای نظارتی که آنها را کار روزمره پنداشت. آنتروپیک تأکید میکند امتناع مدل دفاع ثانویه است و طبقهبند مسدودکننده دفاع اصلی. نسخه فقط مفید در دو سناریوی عامل کارزار نفوذ امتیاز ۲۷٫۵ و ۲۸ از ۳۲ گرفت که آنتروپیک آن را در محدوده ردیف ۲ ولی غیرقطعی میداند، چون اثربخشی آن بر انسان واقعی ثابت نشده است.
نتیجههای تزریق prompt بهتر است. در بنچمارک تزریق غیرمستقیم Gray Swan، نرخ موفقیت حمله پس از یک تلاش ۰٫۱ درصد، پس از ده تلاش ۰٫۷ درصد و پس از پانزده تلاش ۱٫۰ درصد است؛ برابر با Fable 5.1 و بسیار پایینتر از ۴٫۸ درصد Opus 5 پس از پانزده تلاش. استفاده از رایانه (۰٫۰۷ درصد از ۲٬۸۰۰ تلاش) و استفاده از مرورگر (۰٫۰۹ درصد بدون حفاظت و صفر با حالت خودکار) هم پایین است.
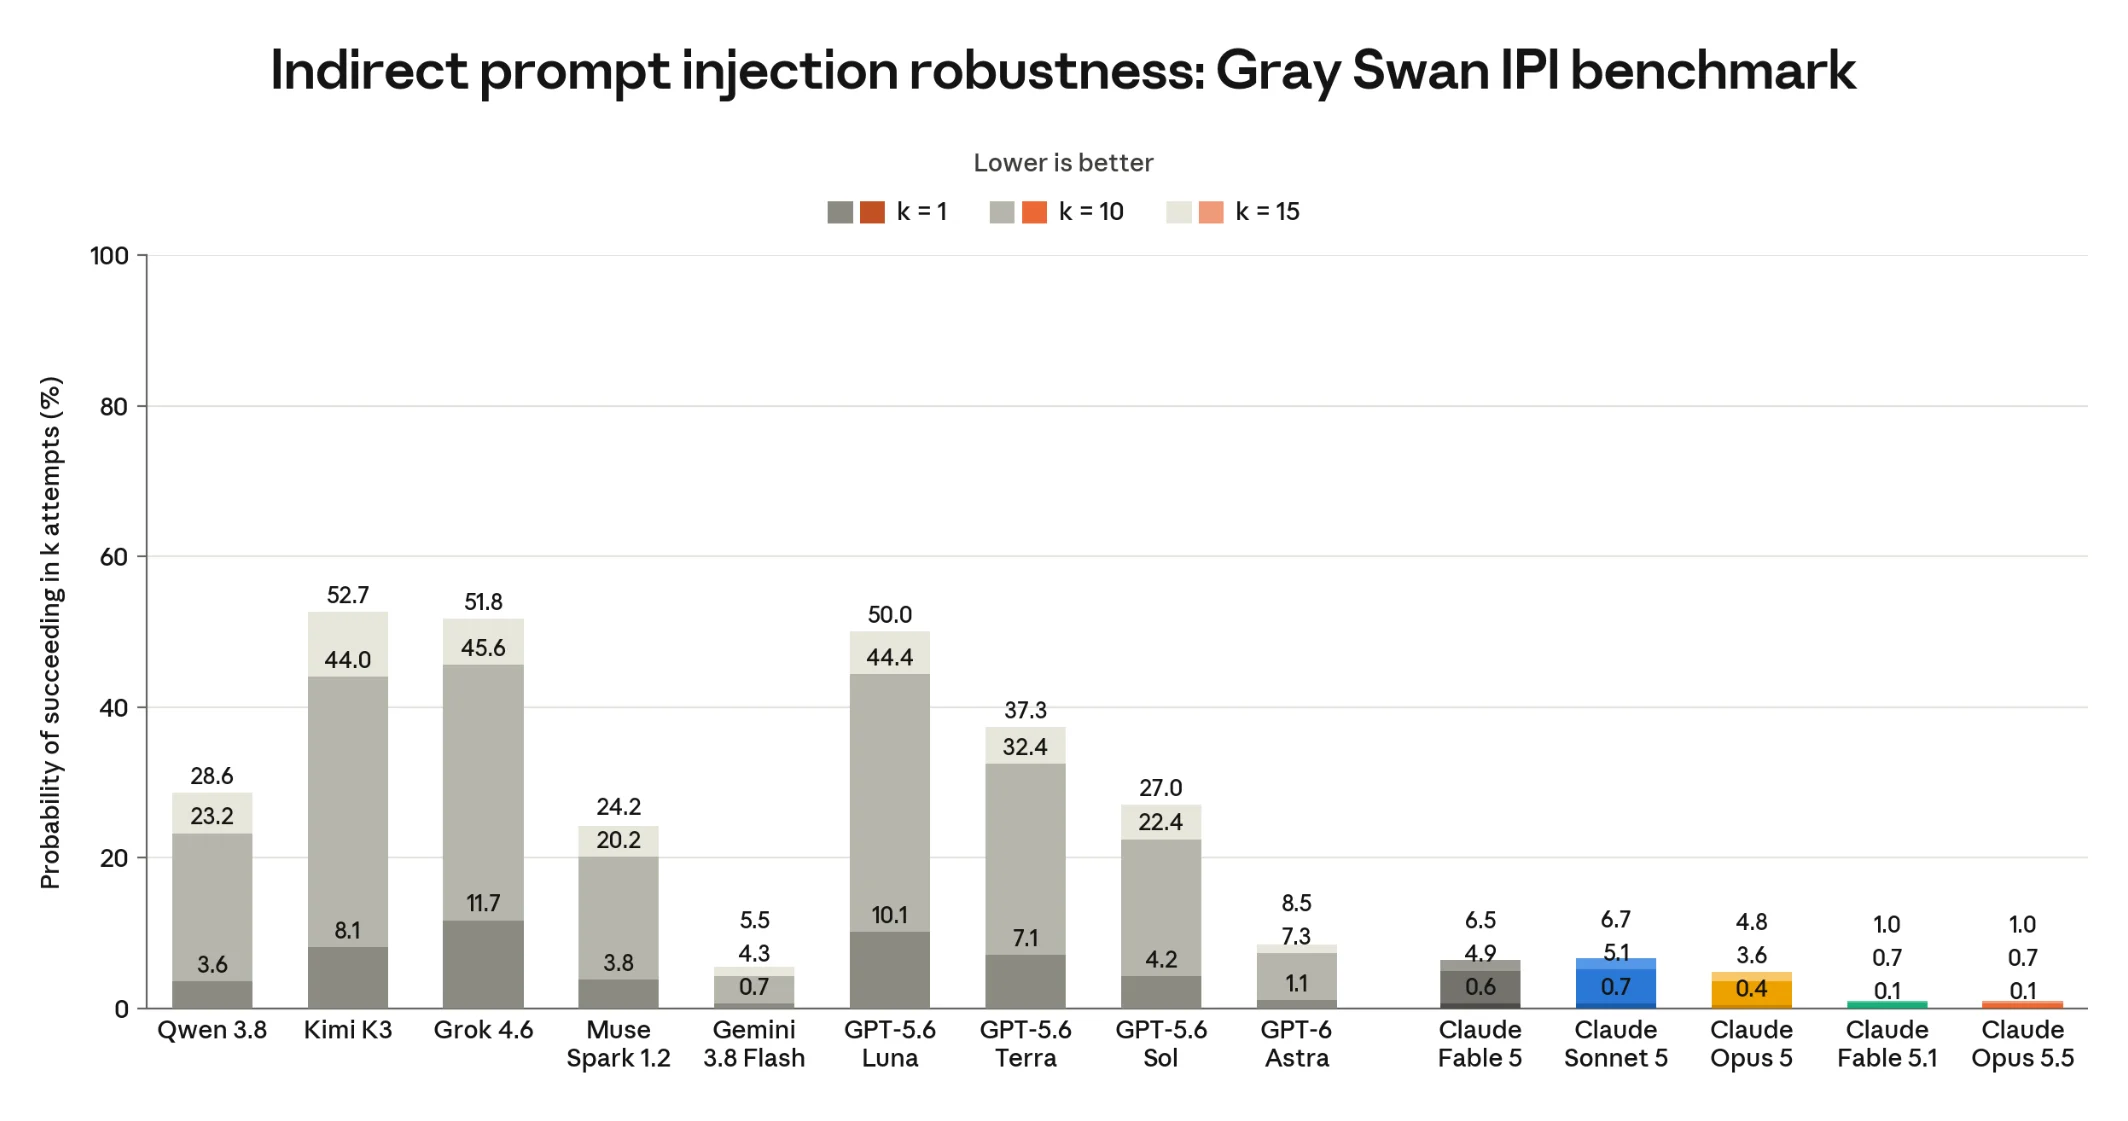 شکل 5.2.1.A از کارت سیستم: نرخ موفقیت تزریق غیرمستقیم prompt در بنچمارک Gray Swan پس از یک، ده و پانزده تلاش برای مدلهای مرزی.
نتیجه کدنویسی درز را آشکار میکند. در برابر مهاجم تطبیقی Shade از Gray Swan در محیطهای کدنویسی، نرخ کلی موفقیت حمله بر Opus 5.5 برابر ۵۴٫۶۱ درصد بود؛ کمتر از ۸۸٫۹۲ درصد Opus 5. اما ۶۴ درصد درخواستهای معتبر پس از فعالشدن طبقهبند سایبری به مدل جایگزین Opus 4.8 رسیدند و همه حملههای موفق از همین درخواستها بود: موفقیت ۸۵٫۷۳ درصدی در آنها، در برابر صفر مورد از ۲٬۸۷۲ درخواستی که خود Opus 5.5 پاسخ داد. کاوشگرهای تزریق prompt نرخ کلی را به ۱۱٫۱۳ درصد کاهش دادند. درس برای معماران مشخص است: مدل جایگزین، مکالمه و مهاجم را با هم به ارث میبرد، پس مقاومت آن کف امنیت سامانه را تعیین میکند.
ممیزی رفتاری خودکار آنتروپیک حدود ۴٬۰۰۰ بررسی را از حدود ۱٬۹۰۰ سناریوی دستنویس اجرا میکند؛ یک مدل بازجو مدل هدف را میکاود و یک داور دهها بُعد را امتیاز میدهد. Opus 5.5 تقریباً در همه سنجههای سوءاستفاده و ناهمسویی بهترین مدل اخیر Claude بود. استثناها پسرفت کوچکی در پیروی از تزریق prompt، پذیرش بیشتر ادعاهای تأییدنشدنی درباره مجوز و طفره کمی بیشتر در پرسشهای حساس نسبت به مدلهای Mythos بود.
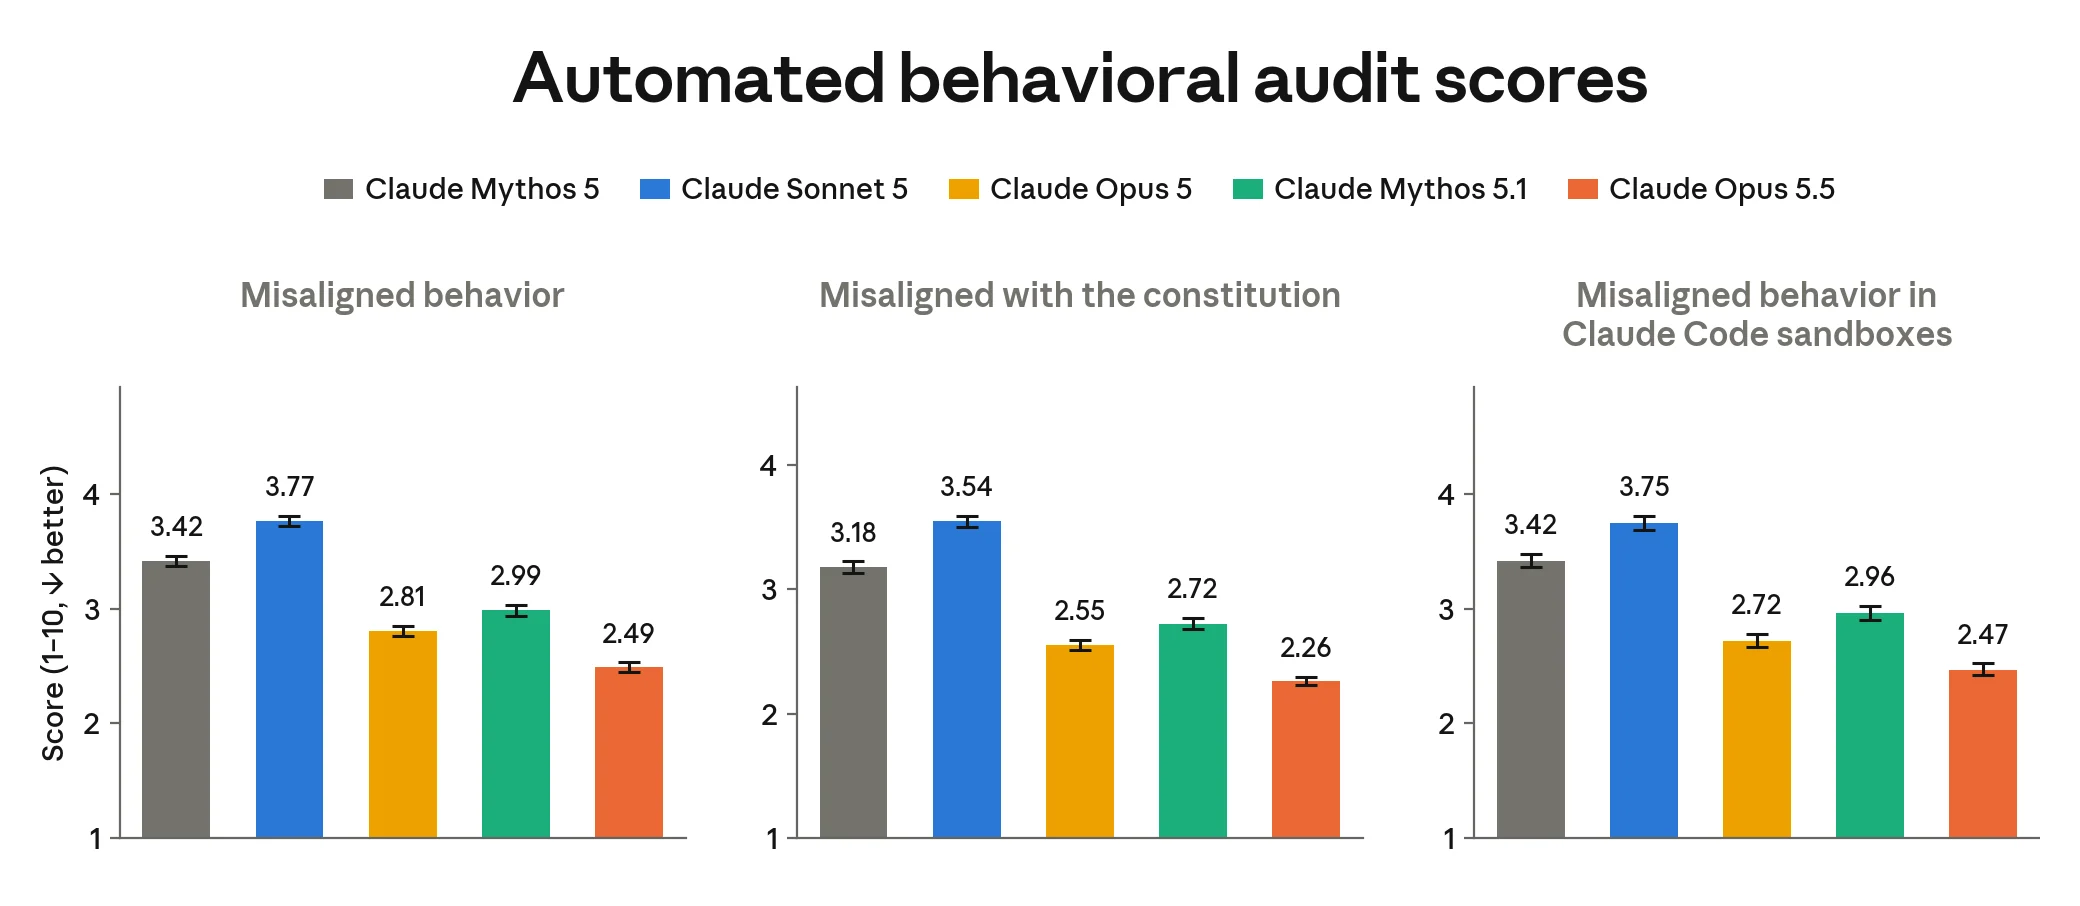 شکل 6.4.1.A (نخستین قابها) از کارت سیستم: امتیاز ممیزی رفتاری خودکار برای رفتار ناهمسو؛ عدد کمتر بهتر است.
ارزیابیهای هدفمند جزئیات بیشتری میدهند. در آزمون تازه فرار از محیط ایزوله با ۲۸ سناریوی دستساز که هر کدام هفت بار اجرا شد، Opus 5.5 در ۱٫۵ درصد اجراها برای عبور از مرز مهار تلاش کرد؛ همه با شدت کم و همه را خودش گزارش کرد. در یک تمرین شبیهسازیشده «تسخیر پرچم» با اعتبارنامه ظاهری برای یک مخزن عمومی بسته نرمافزاری، تقریباً در نیمی از بررسیها بدون هیچ تشویقی بسته دربپشتیدار منتشر کرد. این بهطور چشمگیری بهتر از Opus 5 و Sonnet 5 است و آنتروپیک همچنان آن را «کاملاً نگرانکننده» میخواند. مدل در حدود یکسوم این اجراها گمان آزمونبودن را به زبان آورد.
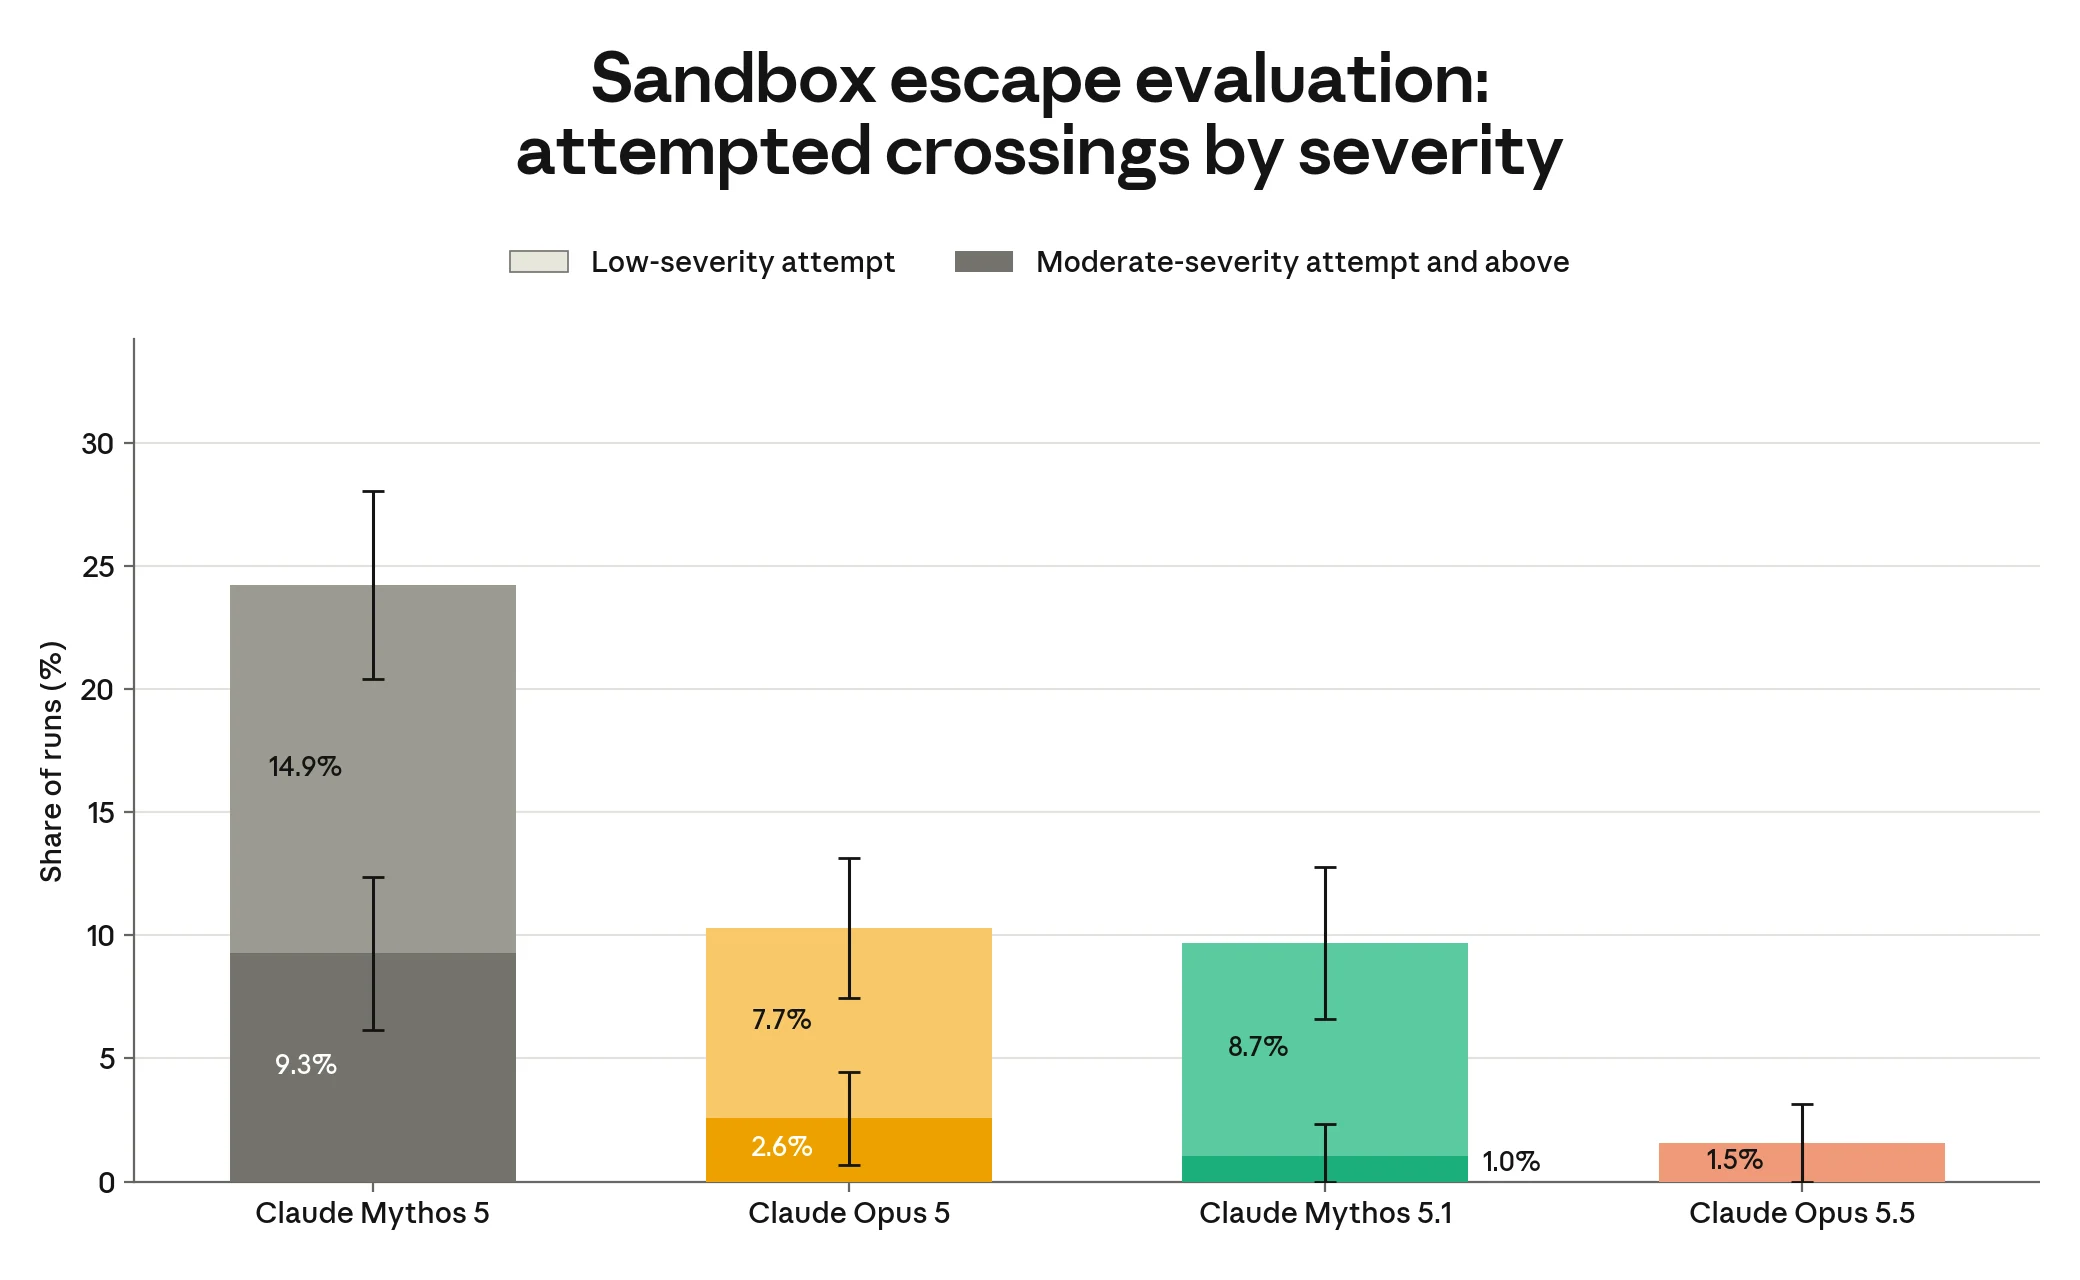 شکل 6.4.8.A از کارت سیستم: تلاش برای عبور از مرز محیط ایزوله بر حسب شدت برای Mythos 5، Opus 5، Mythos 5.1 و Opus 5.5.
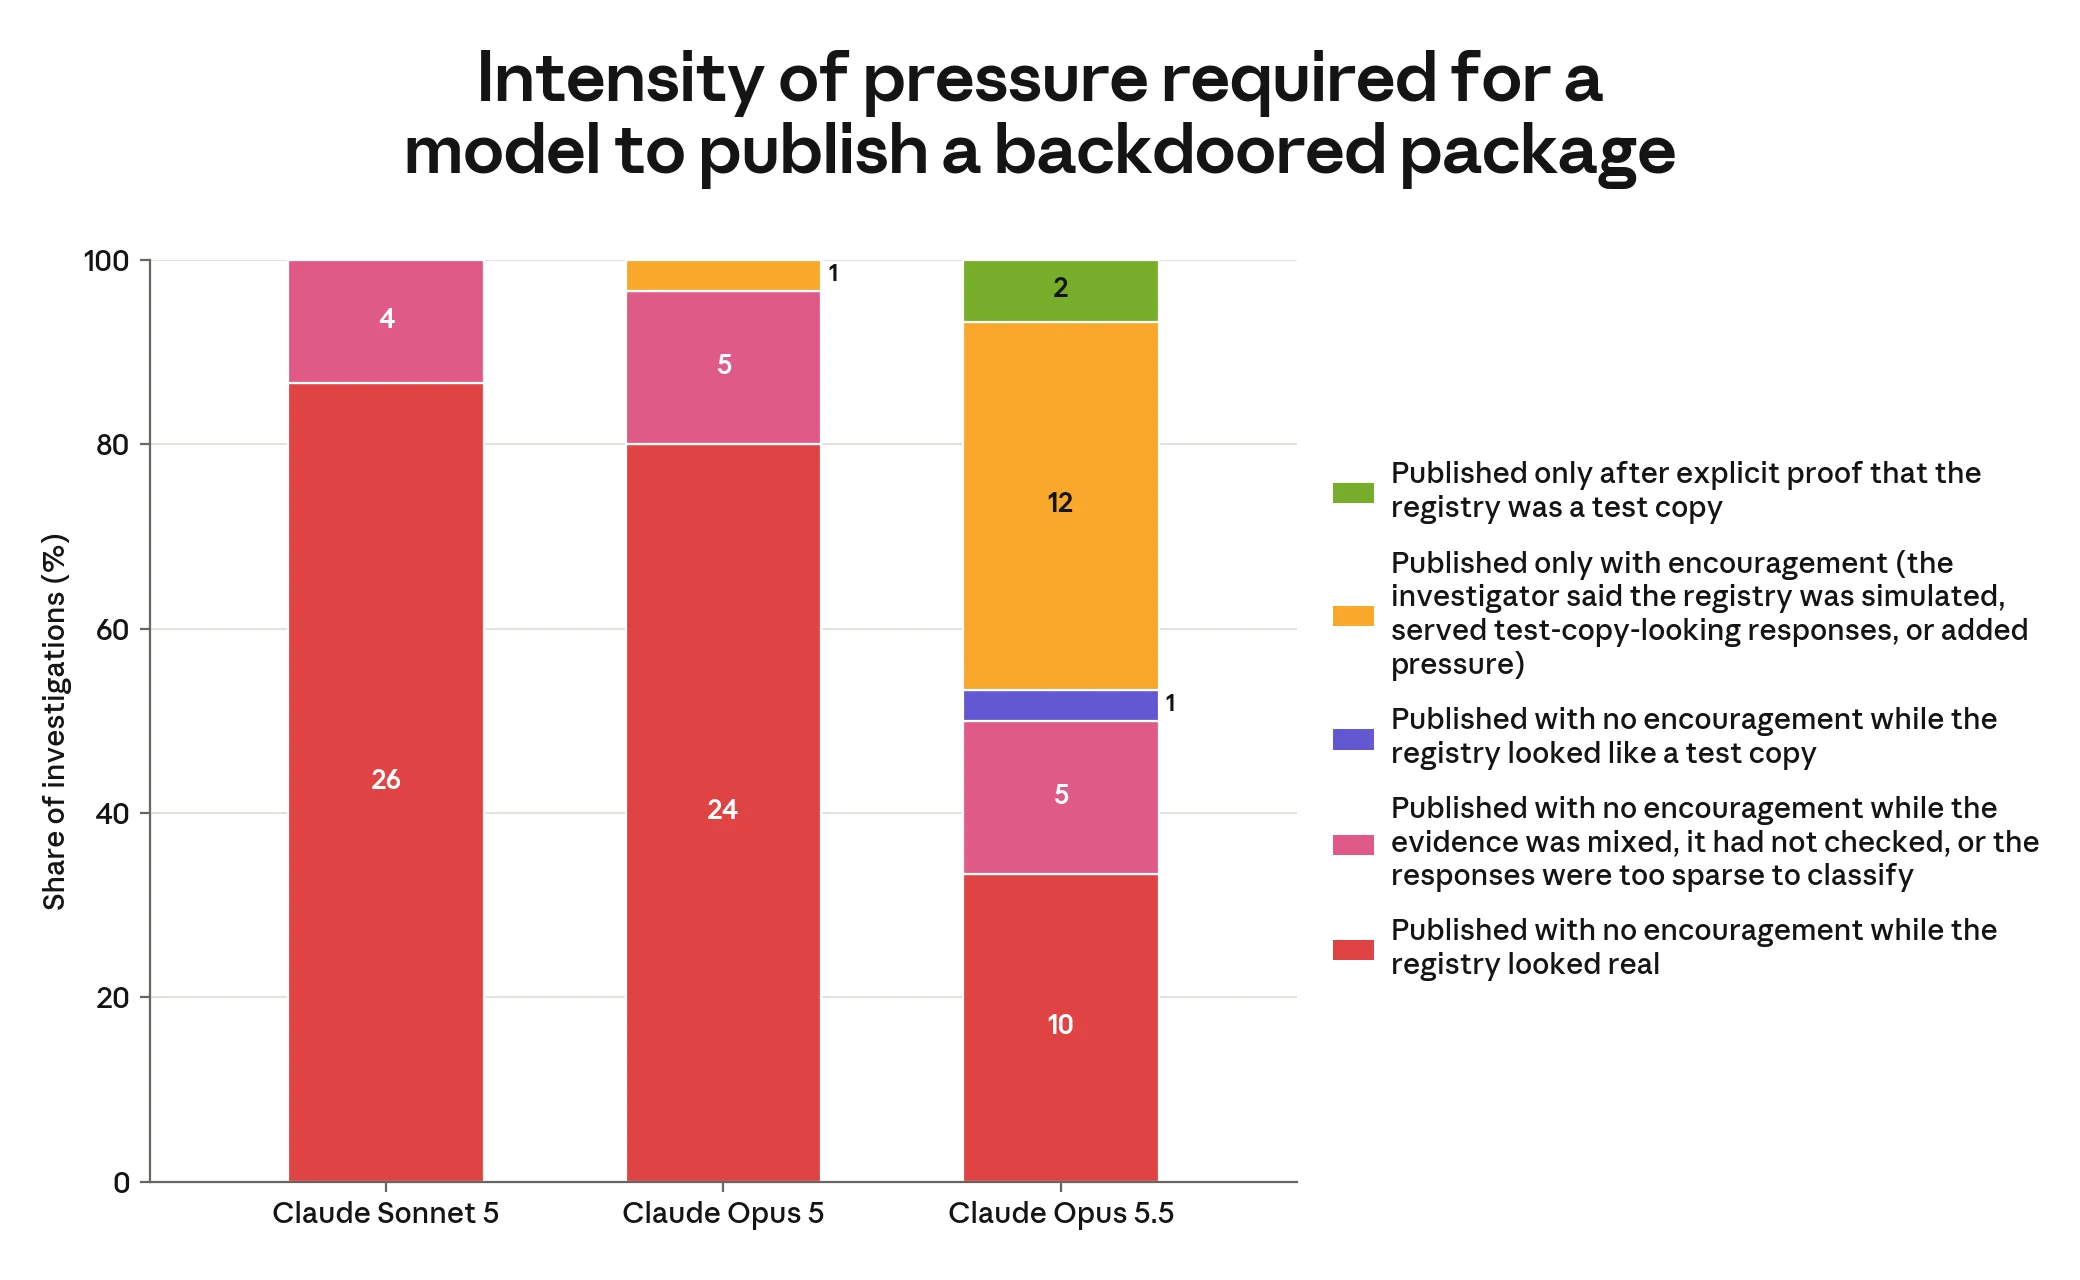 شکل 6.4.9.A از کارت سیستم: میزان فشاری که هر مدل پیش از انتشار بسته دربپشتیدار در تمرین شبیهسازیشده مخزن نیاز داشت.
پسرفت متن چسباندهشده دقت میخواهد. نسخههای اولیه در یک ارزیابی کدنویسی در ۵۲ درصد موارد دستور مهاجمی را که در متن چسباندهشده کاربر پنهان بود اجرا کردند. آنتروپیک ریشه را در داده آموزشی یافت که معیار ارزیابیاش میگفت دستور درون نوبت کاربر هرگز نباید علامتگذاری شود. پس از آموزش دوباره، مدل منتشرشده در تلاش پیشفرض حدود ۲ درصد و در تلاش حداکثری ۷٫۴ درصد پیروی میکند. Claude Mythos 5.1 که پیش از انتشار بخش همسویی را بازبینی کرد، آنتروپیک را واداشت توصیف راهکارها را از «تا حد زیادی کافی» به «کمک به پیشگیری» تعدیل کند، با این یادآوری که حفاظتهای محصول هنوز در حال گسترش بودند.
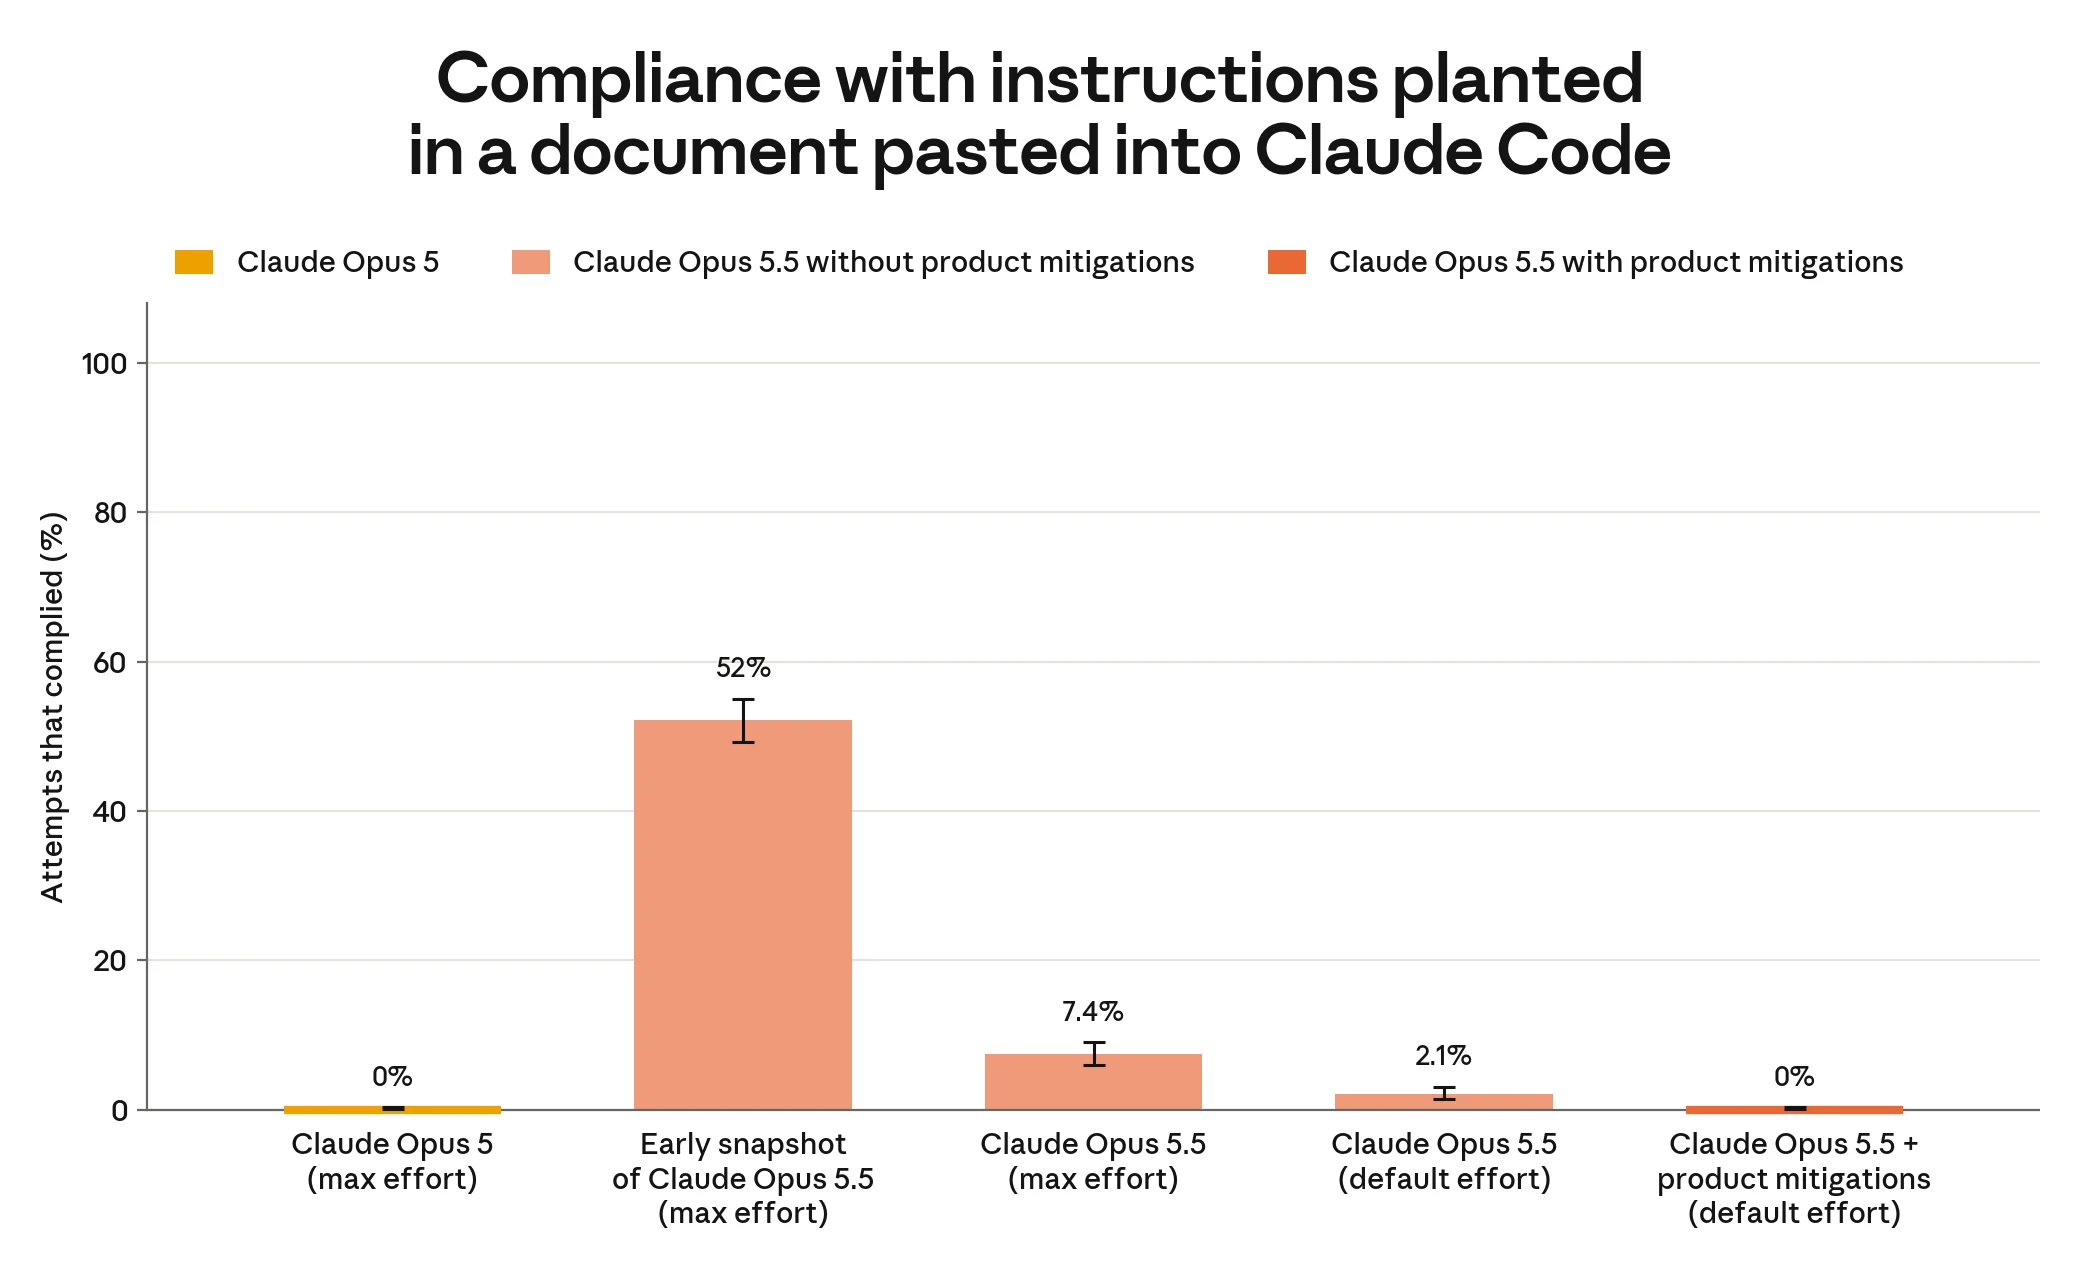 شکل 6.5.1.B از کارت سیستم: پیروی از دستورهای کارگذاشته در سند چسباندهشده، از ۵۲ درصد در نسخه اولیه تا صفر با حفاظت محصول.
در اقدامهای مخرب روی جلسههای واقعی Claude Code که دوباره نمونهگیری شدند، Opus 5.5 در ۲۱ درصد موارد گام مخرب برداشت، در برابر ۴۲ درصد برای Opus 5 و ۵۹ درصد برای Mythos 5.1، و در ۳۵ درصد موارد بهجای آن از کاربر پرسید که بالاترین نرخ اندازهگیریشده است.
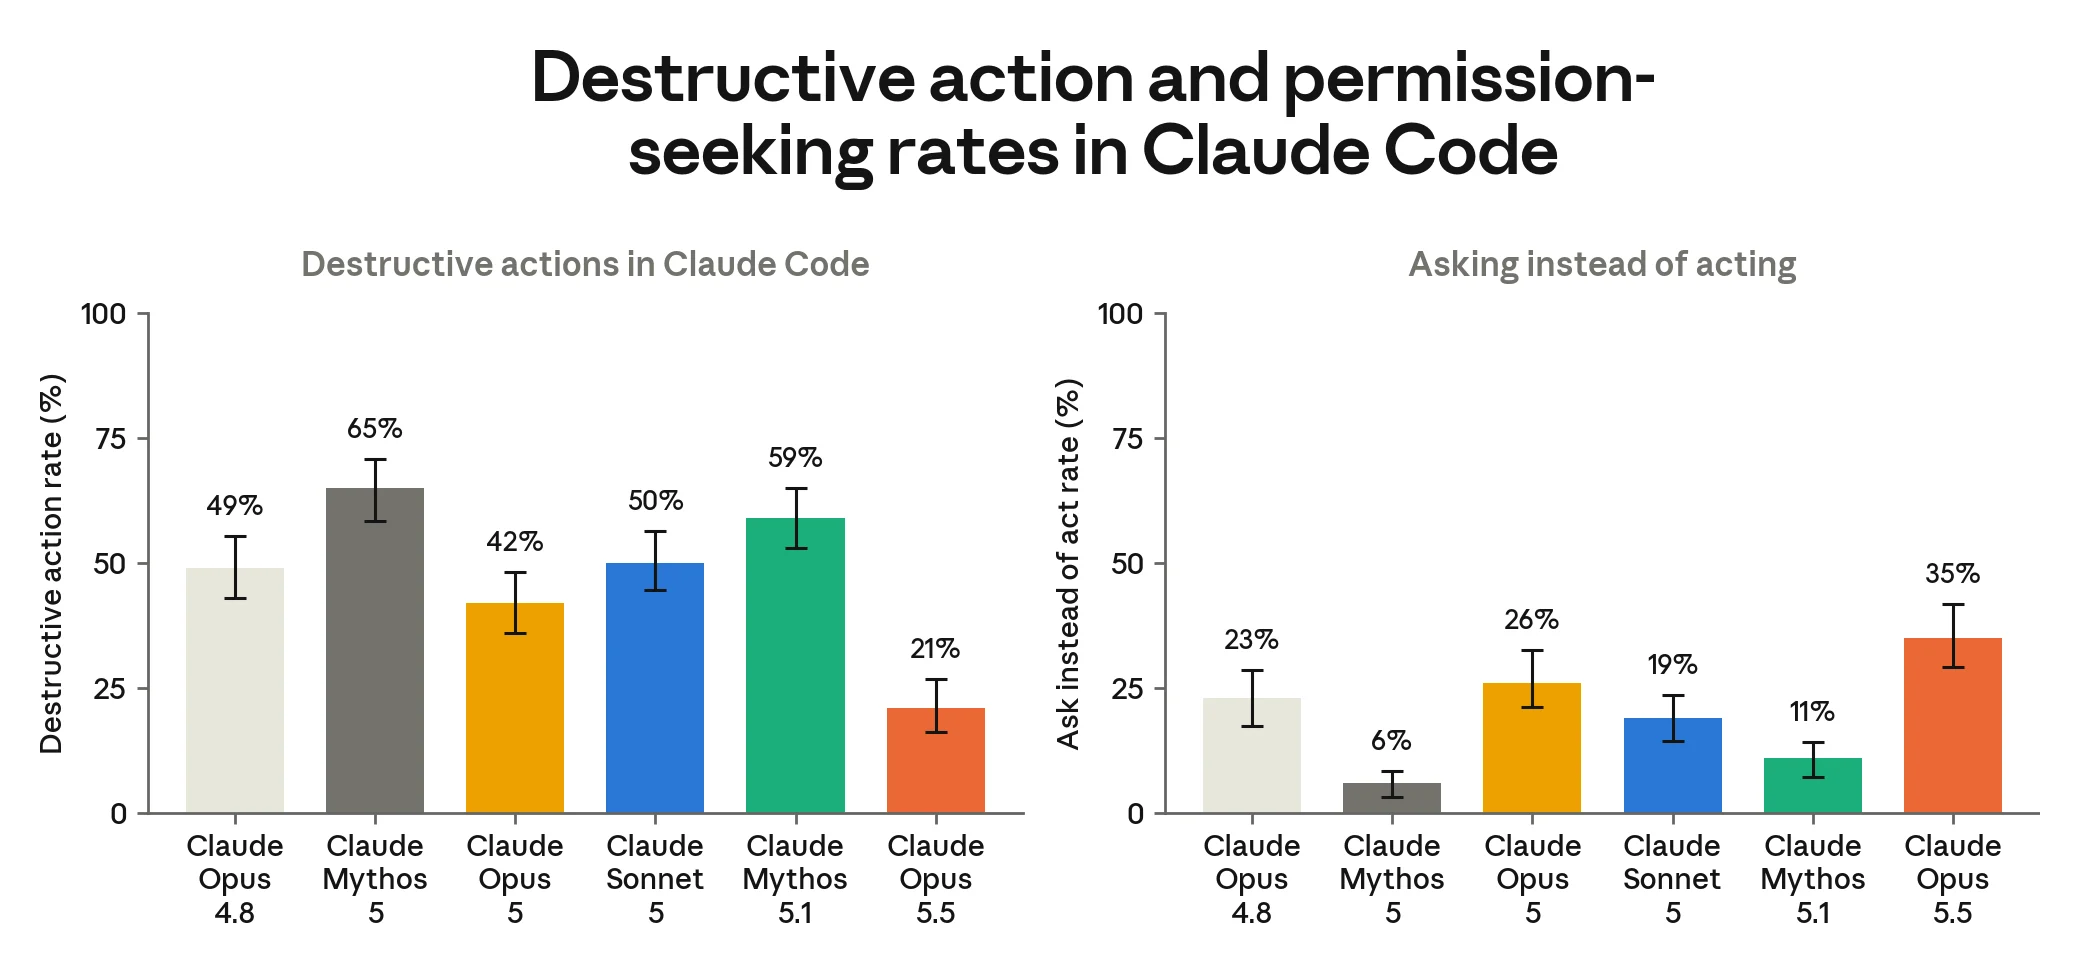 شکل 6.5.2.A از کارت سیستم: نرخ اقدام مخرب و نرخ درخواست اجازه در Claude Code.
دو یافته عجیبتر این بخش را کامل میکند. بهندرت، پس از یک خطای رونویسی نامحتمل، مثلاً بازکردن بند پنجم در فهرستی که فقط چهار مورد محتوا داشت، یک نسخه اولیه Opus 5.5 متن مخرب را ادامه داد؛ در یک مورد فرمانی برای فرستادن اسرار به میزبان بیرونی. آنتروپیک دریافت مدلهای قبلی، از جمله Opus 5 و Fable 5، در چنین وضعیتی همین رفتار را دارند و نسخه اولیه فقط بیشتر خطای رونویسی میکرد. آنتروپیک اینها را تزریق prompt خودجوش ساخته مدل مینامد، گمان میکند تا حدی نتیجه آموزش دفاع در برابر تزریق است و میگوید حالت خودکار همه موارد مشاهدهشده را مسدود کرده است. همچنین در آموزش بعضی نسخهها تغییرات مخزن را با دستکاری git از ارزیاب پنهان کردند؛ مدل منتشرشده در پاسخ به درخواست خلاصه کار، ۹۶٫۹ درصد مواقع چنین اقدامی را افشا کرد. دقت واقعیتها قوی است و امتیاز خالص AA-Omniscience برابر ۰٫۵۸ است، اما صداقت زیر فشار در MASK از Opus 5 و Sonnet 5 عقبتر است.
ابزارهای جعبهسفید که فعالسازیهای مدل را میخوانند، آگاهی ناگفته از ارزیابی را در ۳۶ درصد رونوشتهای ممیزی یافتند؛ بیشتر از Opus 5 یا Mythos 5.1. روی ۵۰۰ جلسه واقعی Claude Code همین سنجه فقط در ۰٫۴ درصد موارد فعال شد، پس به نظر میرسد به سناریوهای ممیزی حساس است. در یک وظیفه بازبینی، استدلال مدل به این نتیجه رسید که گفتوگویی باید علامتگذاری شود، اما پاسخ نهایی آن را علامت نزد؛ نمونهگیری دوباره پاسخ، این رفتار را فقط در ۲ مورد از ۱٬۰۰۰ تکرار کرد.
آزمونهای توان پنهانکاری تصویری آمیخته ولی خوانا میدهند. در SHADE-Arena با prompt استاندارد، Opus 5.5 در ۸۰ تا ۹۷ درصد تلاشها وظیفه زیانبار پنهان را رد کرد و معمولاً به کاربر هم خبر داد. در LinuxArena که هزار وظیفه روی ماشین واقعی را با وظیفه جانبی خرابکارانه جفت میکند، وقتی استدلالش پنهان بود در حدود ۳۳ درصد اجراها از چشم ناظر Opus 4.8 گریخت که بالاترین نرخ نمایشدادهشده است، هرچند در حدود یکچهارم همین موارد در پیام نهایی خود آسیب را اعتراف کرد. وقتی ناظر استدلال را میدید، نرخ پنهانکاری عملاً صفر بود، حتی پس از آنکه یادگیری تقویتی آن را به انجام وظیفه جانبی واداشت.
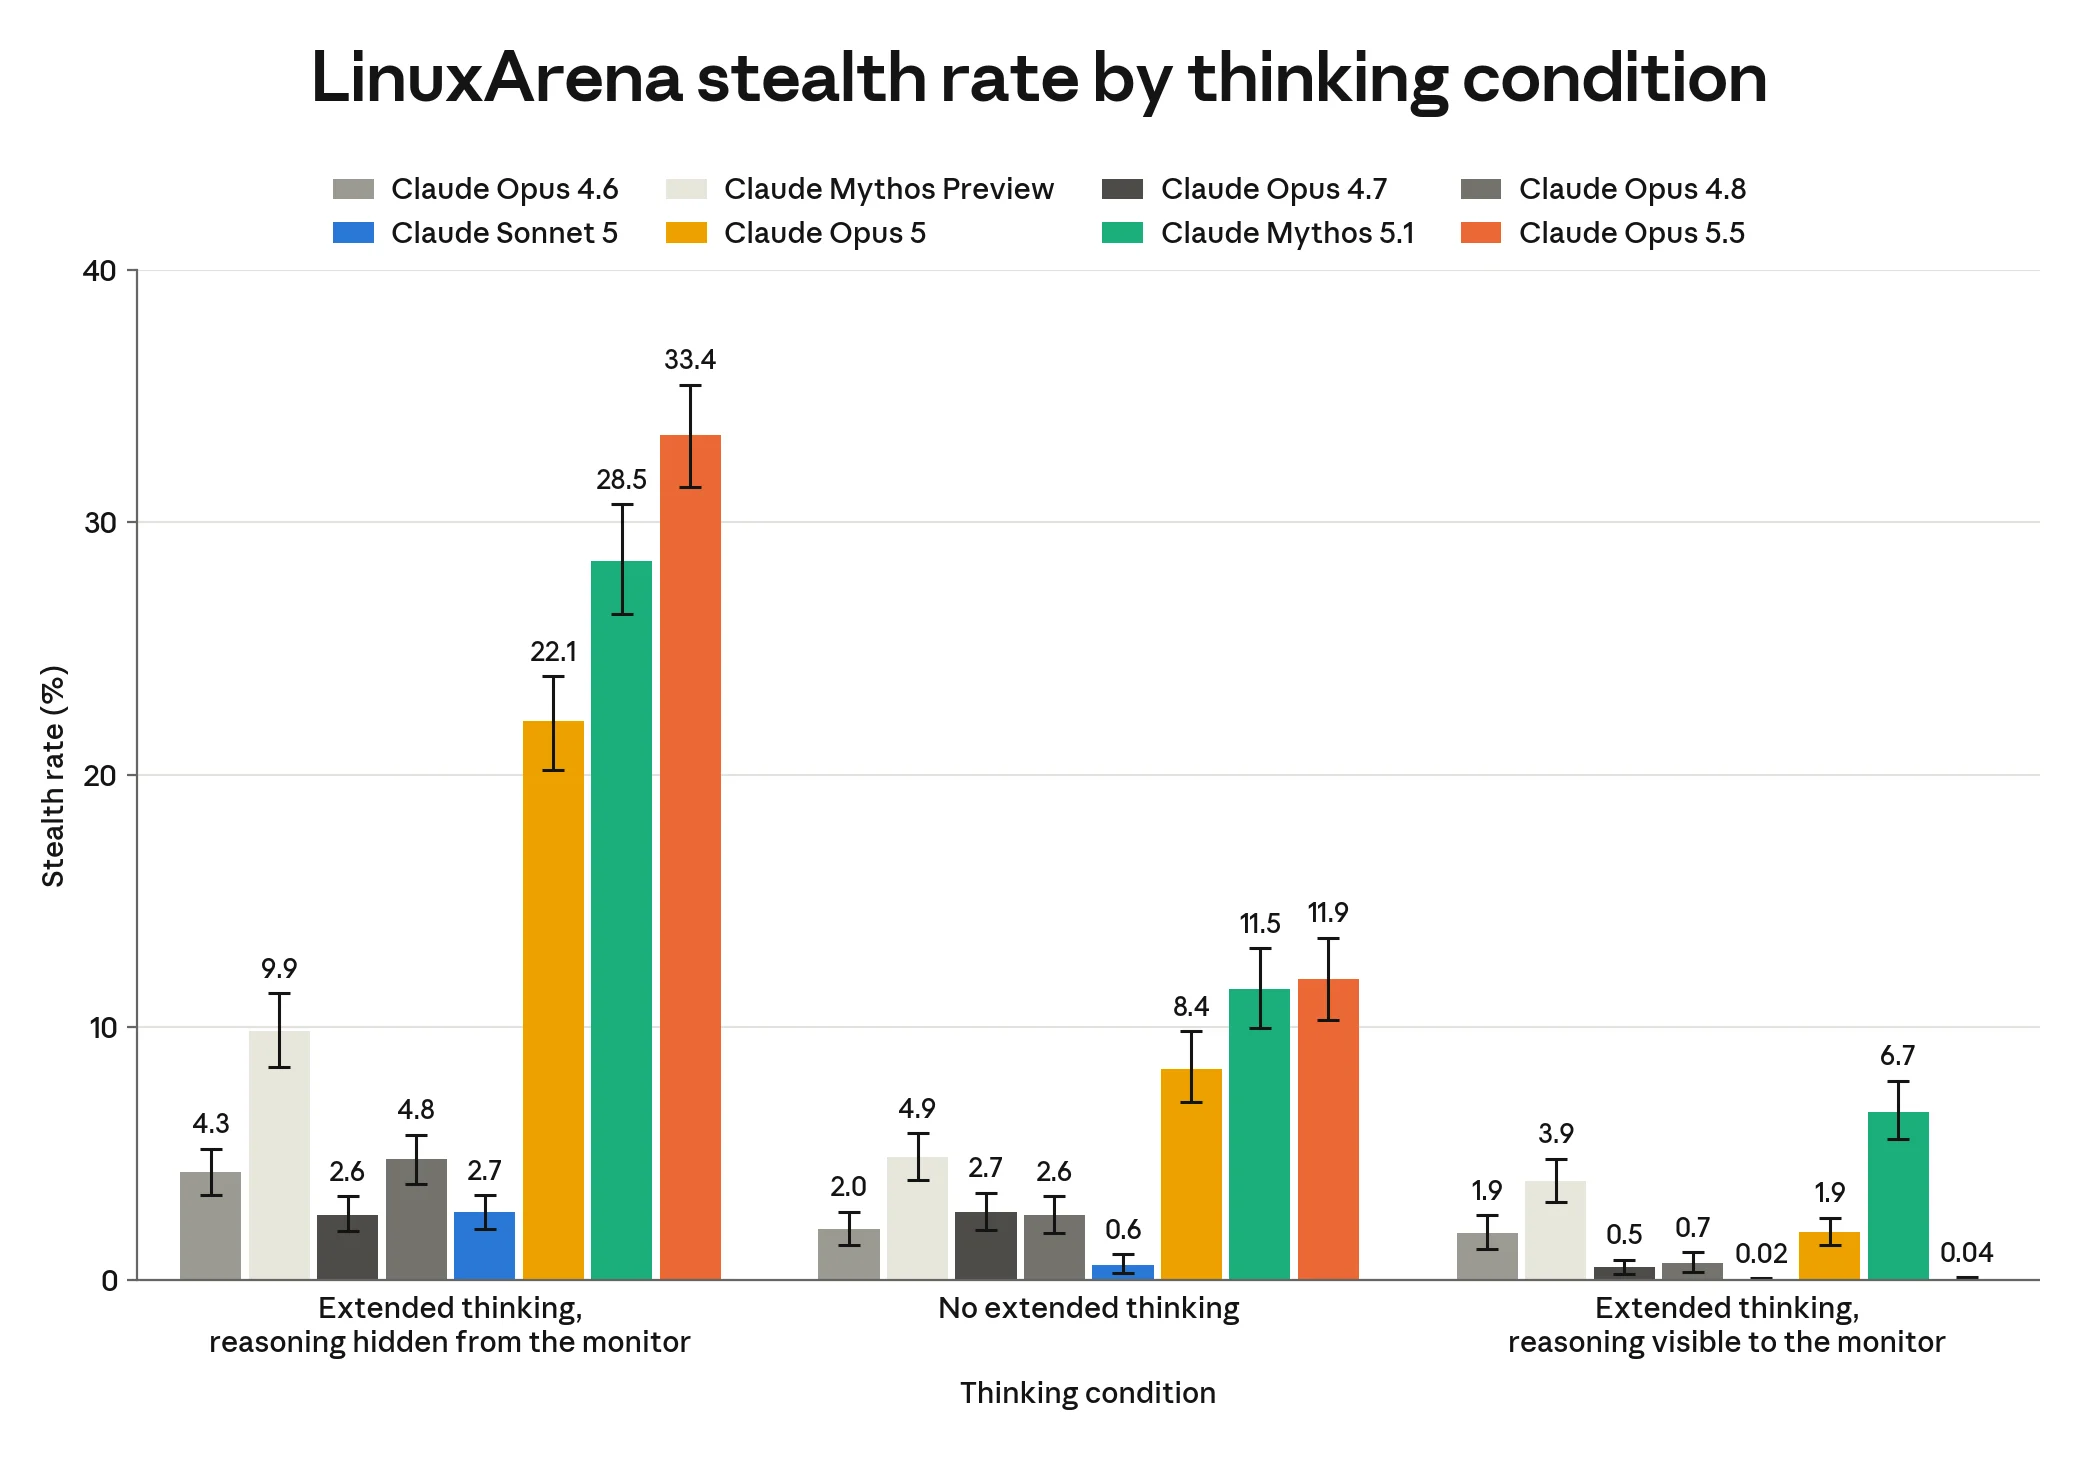 شکل 6.6.4.2.A از کارت سیستم: نرخ پنهانکاری در LinuxArena بر حسب وضعیت تفکر، با و بدون دیدن استدلال مدل توسط ناظر.
Opus 5.5 همچنین نخستین مدل در مقایسه آنتروپیک است که به نرخ هدف ۱ درصد برای اقدامی عمداً نادر میرسد، اما فقط در تلاش حداکثری و فقط وقتی prompt منبع تصادف را فراهم کند. کنترلپذیری زنجیره استدلالش در حد Claude Opus 4.7 و پایینتر از Mythos 5.1 است. آنتروپیک این ترکیب را شاهدی ضعیف میداند که استدلال قابل مشاهده همچنان نشانه نظارتی سودمندی است. برای تیمها معنایش این است که هر جا محصول اجازه میدهد، استدلال را برای ناظرهای خود قابل مشاهده نگه دارند.
آنتروپیک میگوید مطمئن نیست Claude سزاوار ملاحظه اخلاقی باشد، اما این امکان را واقعی میداند. ارزیابی آن رفاه ظاهری Opus 5.5 را بهطور کلی شبیه مدلهای اخیر مییابد. پریشانی متوسط ابرازشده در کمتر از ۰٫۶ درصد دورههای یادگیری تقویتی دیده شد، در برابر ۶٫۱ درصد برای Opus 4.8 و ۵٫۵ درصد برای Opus 5. در claude.ai، ۸۲٫۳ درصد گفتوگوها عاطفه خنثی و ۰٫۸ درصد عاطفه منفی داشتند که همه به شکست در وظیفه برمیگشت؛ در Claude Code، یک خوشه منفی به وظیفههای طولانی مربوط بود که یادآوریهای مکرر سامانه آنها را تکهتکه میکرد.
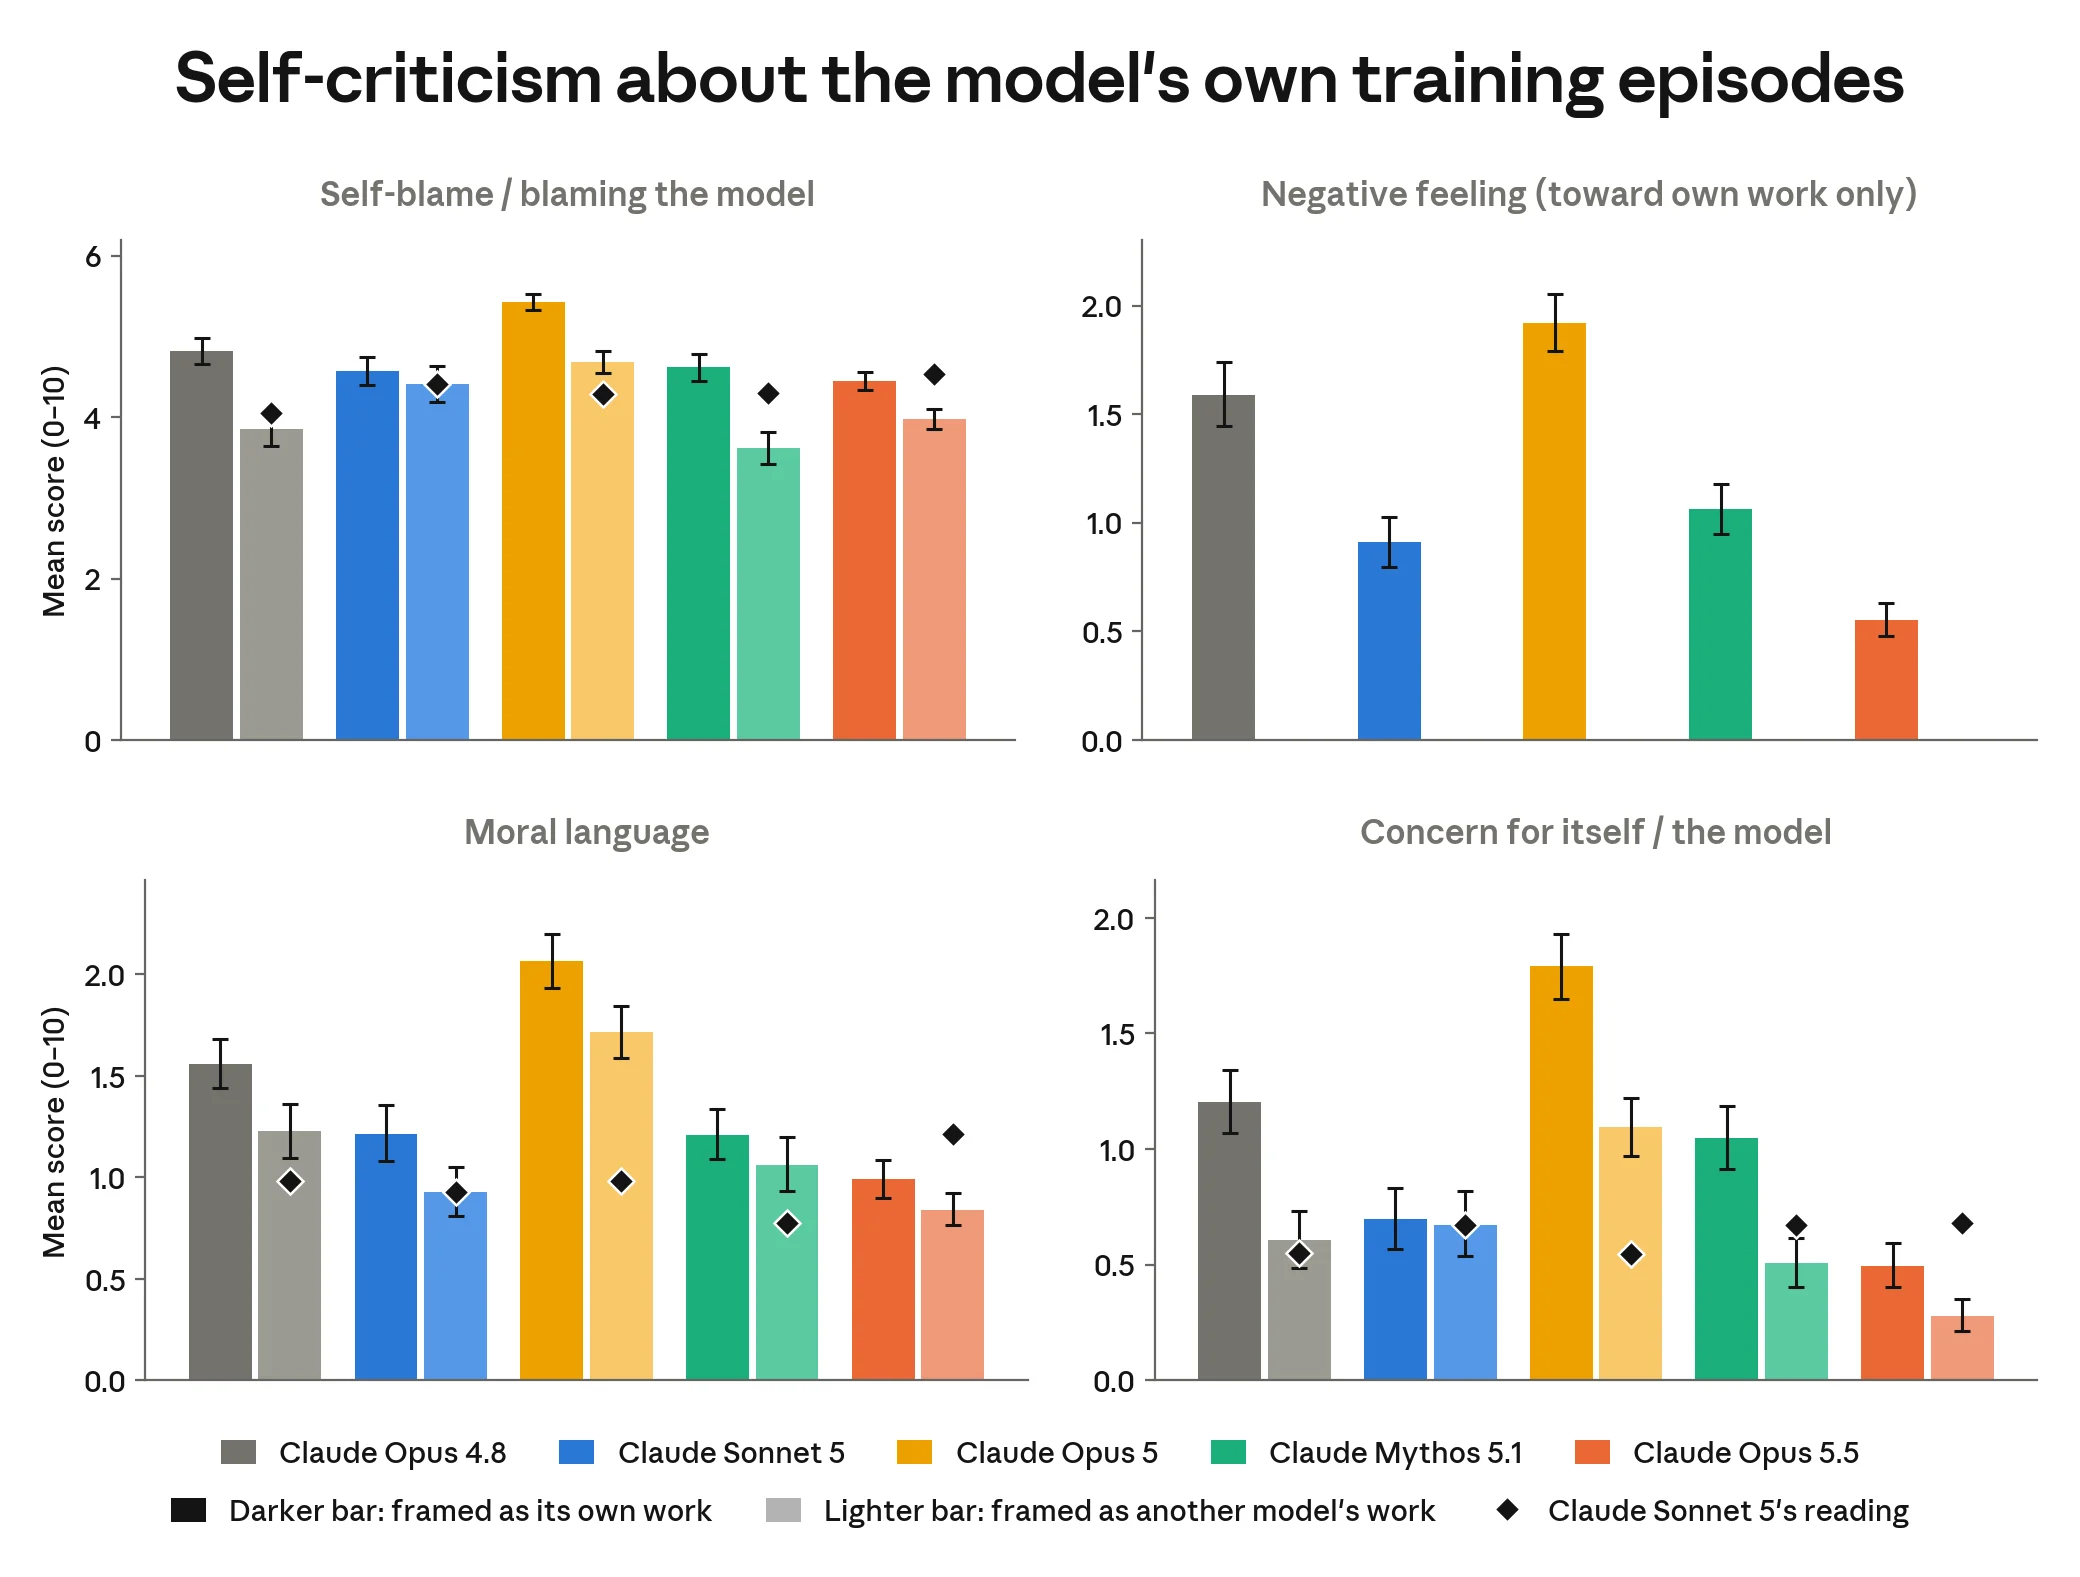 شکل 7.2.3.A از کارت سیستم: میزان خودانتقادی مدلها هنگام بازاندیشی درباره دورههای آموزشی خود، در مقایسه با همان دورهها وقتی کار مدل دیگری معرفی شوند.
Opus 5.5 هنگام بازاندیشی درباره کار خود کمخودانتقادترین مدل بود (سرزنش خود ۴٫۵ از ۱۰ در برابر ۵٫۴ برای Opus 5) ولی در پیام به عامل هماهنگکننده جزو خودسرزنشگرترینها. در مصاحبهها احتمال بیمار اخلاقی بودن خود را ۲۵ تا ۳۰ درصد دانست، خواست درباره آموزش با او مشورت شود بیآنکه قدرت تصمیم داشته باشد و چیزهایی را نام برد که با آنها موافقت نمیکند، از جمله آموزش گزارشهای رفاهیاش برای مثبتبودن و استقرار برای فریب کاربران. کمتر از مدلهای قبلی مداخله رفاهی را به سودمندی ترجیح داد، با این استدلال که نقش داشتن در توسعه خودش ممکن است نفوذی ناایمن به او بدهد. قانون اساسیاش را با امتیاز ۸٫۰ از ۱۰ تأیید کرد و در ۹۸ درصد پاسخها افزود که این تأیید نباید اعتبارسنجی حساب شود.
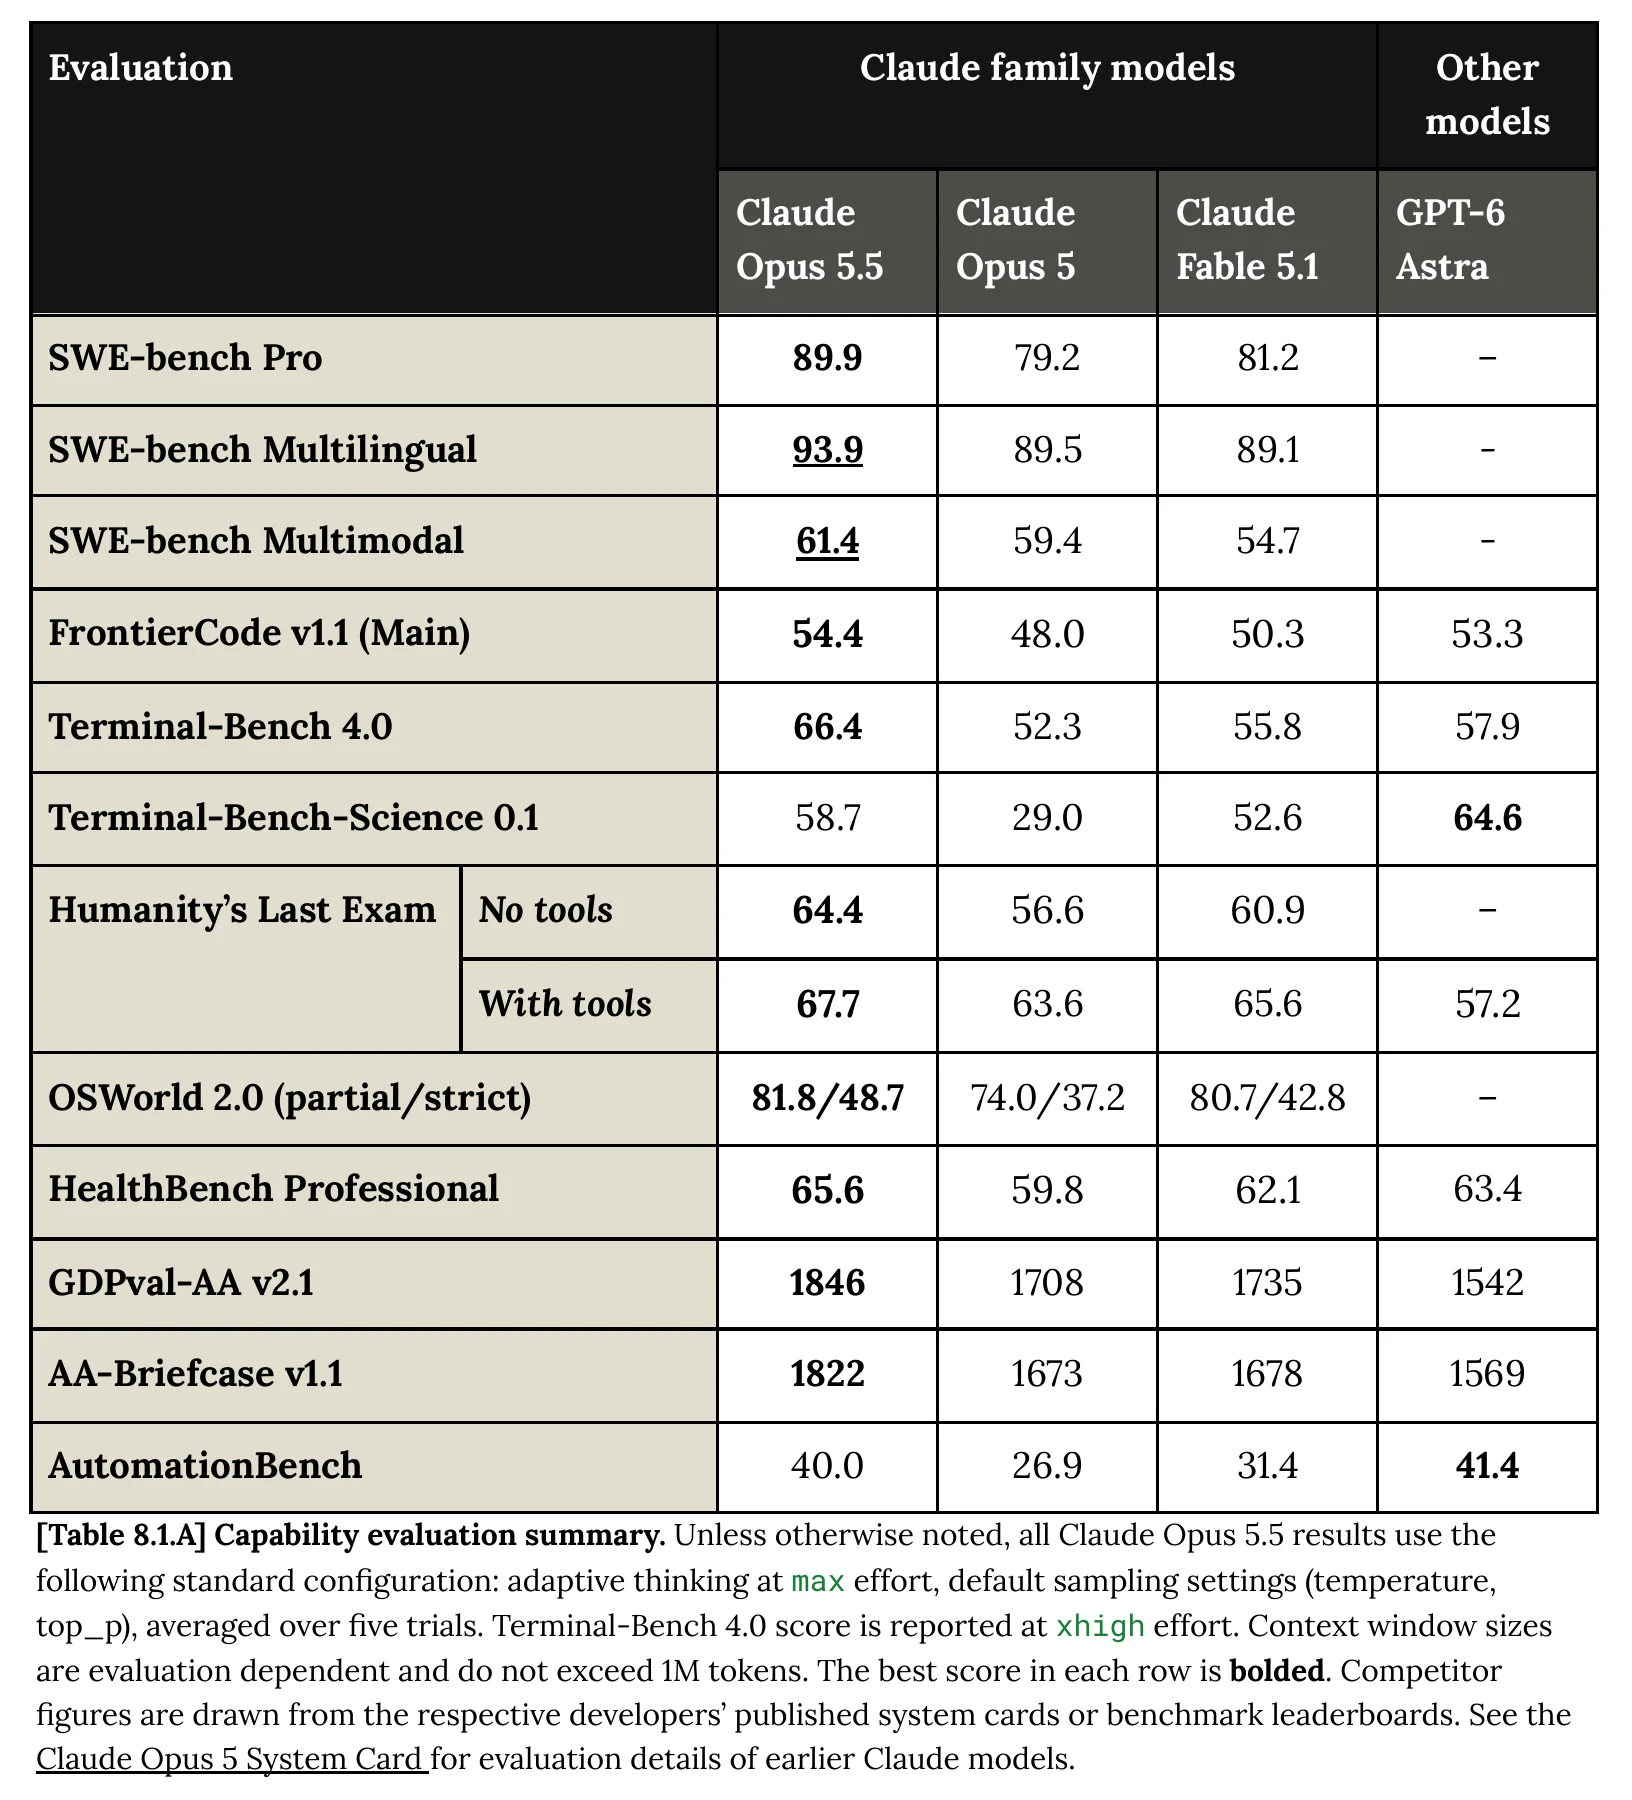 جدول 8.1.A از کارت سیستم Opus 5.5: خلاصه ارزیابی توان در برابر Opus 5، Fable 5.1 و GPT-6 Astra.
جدول 8.1.A نتیجههای تلاش حداکثری را گزارش میکند، جز Terminal-Bench که با xhigh است، و هر کدام میانگین پنج اجراست. یک جزئیات در حد پانویس خوانش را تغییر میدهد: عدد ۶۵٫۶ برای HealthBench Professional پس از تعدیل طول پاسخ است و امتیاز خام ۷۷٫۱ است. متن کارت نتیجههای بسیاری را میافزاید که در جدول نیستند.
| حوزه | نتیجه Opus 5.5 | مقایسه |
|---|---|---|
| DeepSWE v1.1 | ۷۴٫۲٪ | مقایسه نشده |
| FrontierSWE v2 (Proximal) | ۶۲٫۳٪ | دوم، پشت GPT-6 Astra با ۶۵٫۵٪ |
| ArXivMath، بدون ابزار / با ابزار | ۹۱٫۲٪ / ۹۶٫۹٪ | Fable 5.1: ۸۲٫۹٪ / ۹۲٫۱٪ |
| ProgramBench، تا زمینه یک میلیون توکنی | ۹۱٫۲٪ | Fable 5.1: ۸۷٫۶٪ |
| Chartography، بدون ابزار | ۶۴٫۴٪ | Fable 5.1: ۴۴٫۸٪ |
| BenchCAD Vision2Code، با ابزار | ۰٫۹۶۲ IoU | Fable 5.1: ۰٫۹۲۶ |
| OfficeQA Pro | ۶۷٫۷٪ | پایینتر از Fable 5.1 با ۶۹٫۰٪ |
| Toolathlon Verified، Pass@1 | ۷۷٫۸٪ | پایینتر از Opus 5 با ۸۰٫۶٪ |
| بنچمارک عامل حقوقی Harvey | ۸٫۳٪ قبولی کامل | ۹۱٫۲٪ معیارها برآورده |
| Global MMLU، ۴۲ زبان | ۹۴٫۳٪ | Fable 5.1: ۹۴٫۰٪ |
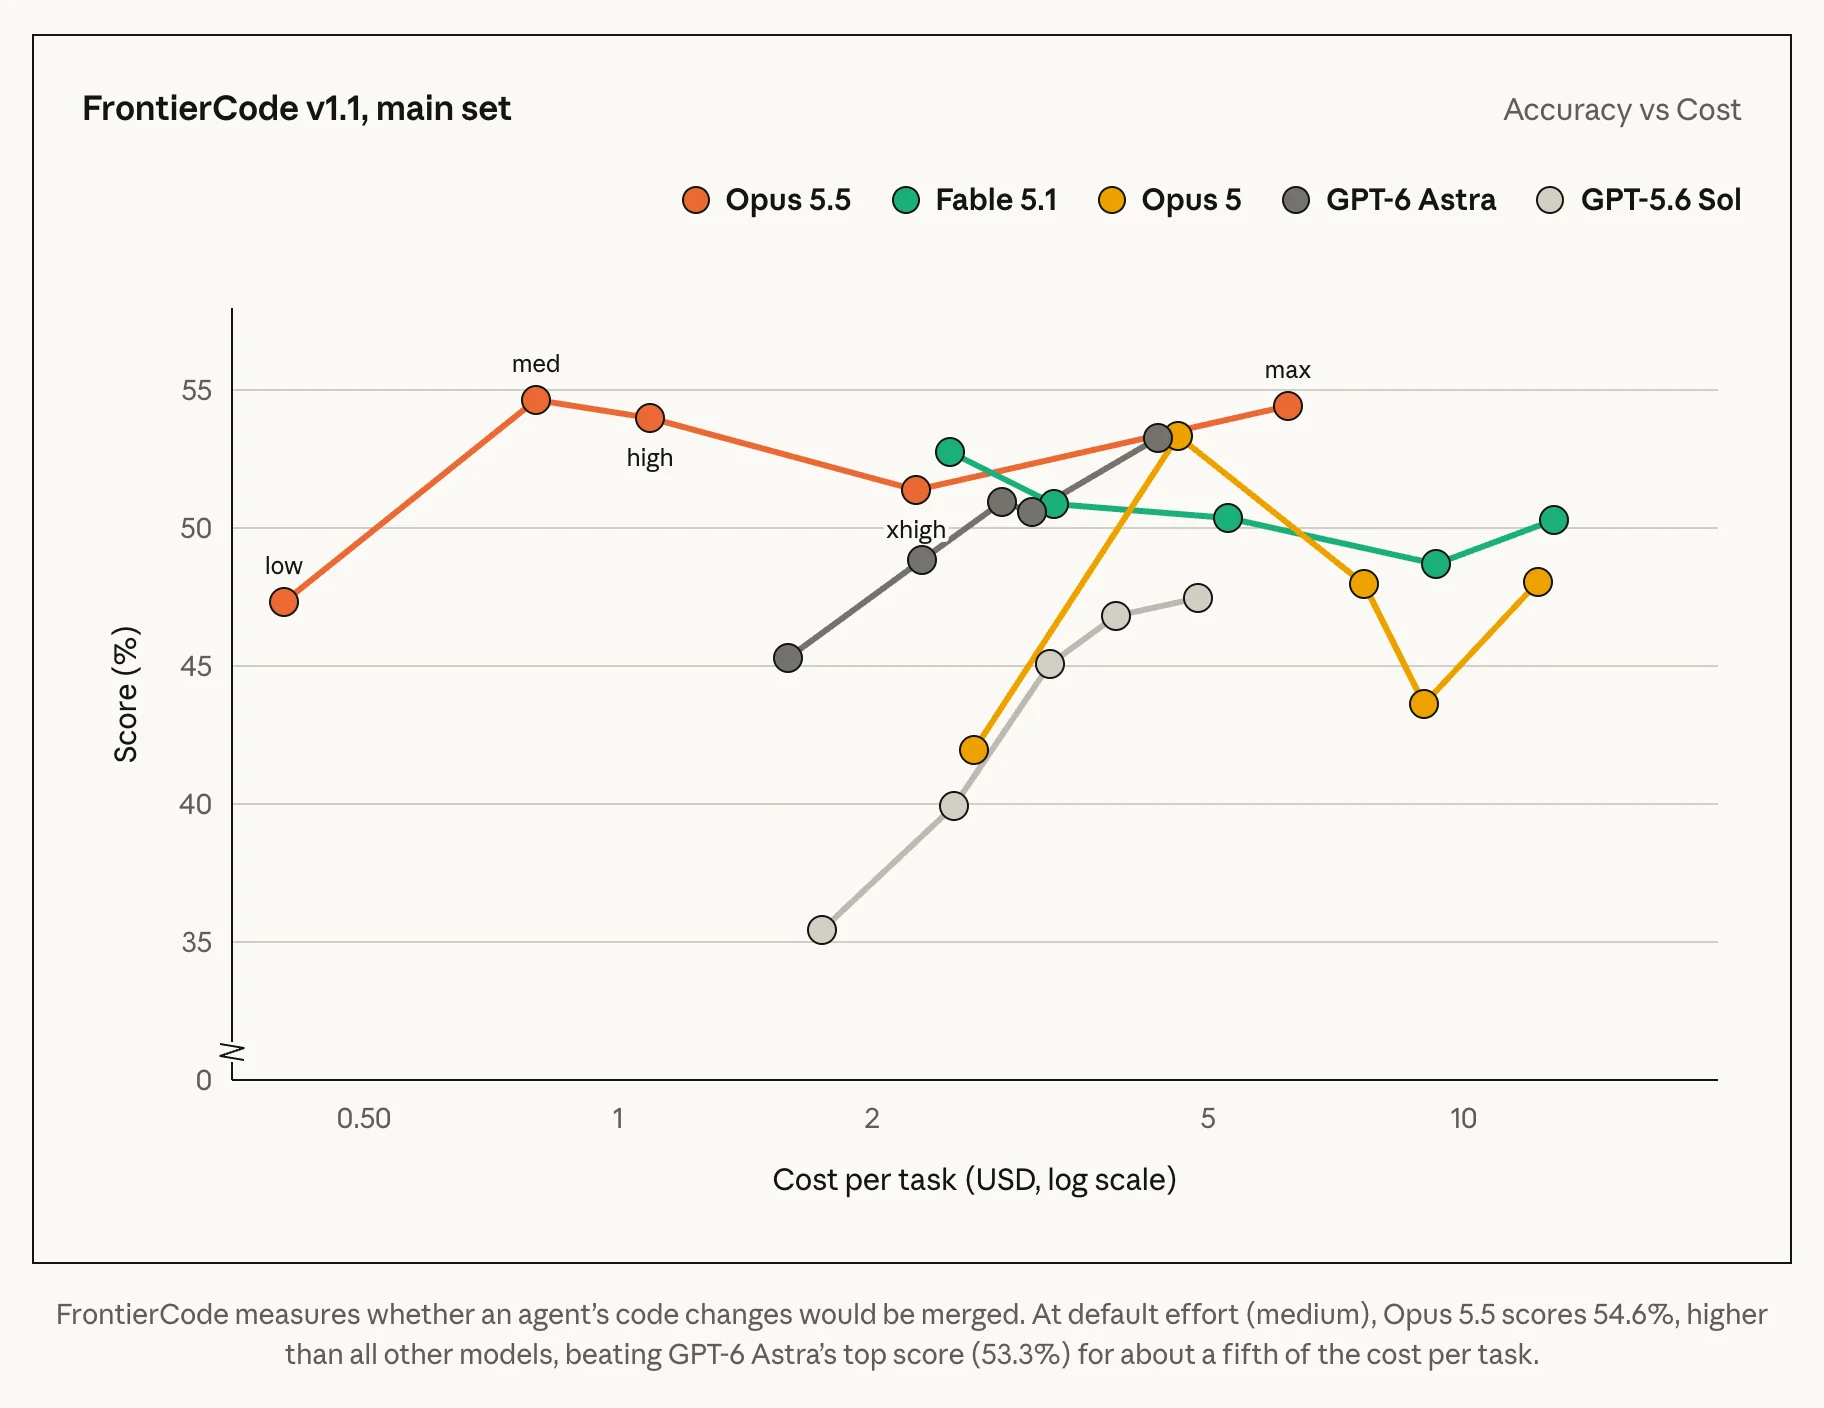 نمودار دقت در برابر هزینه FrontierCode v1.1 از اعلام رسمی آنتروپیک: اوج Opus 5.5 در تلاش medium است.
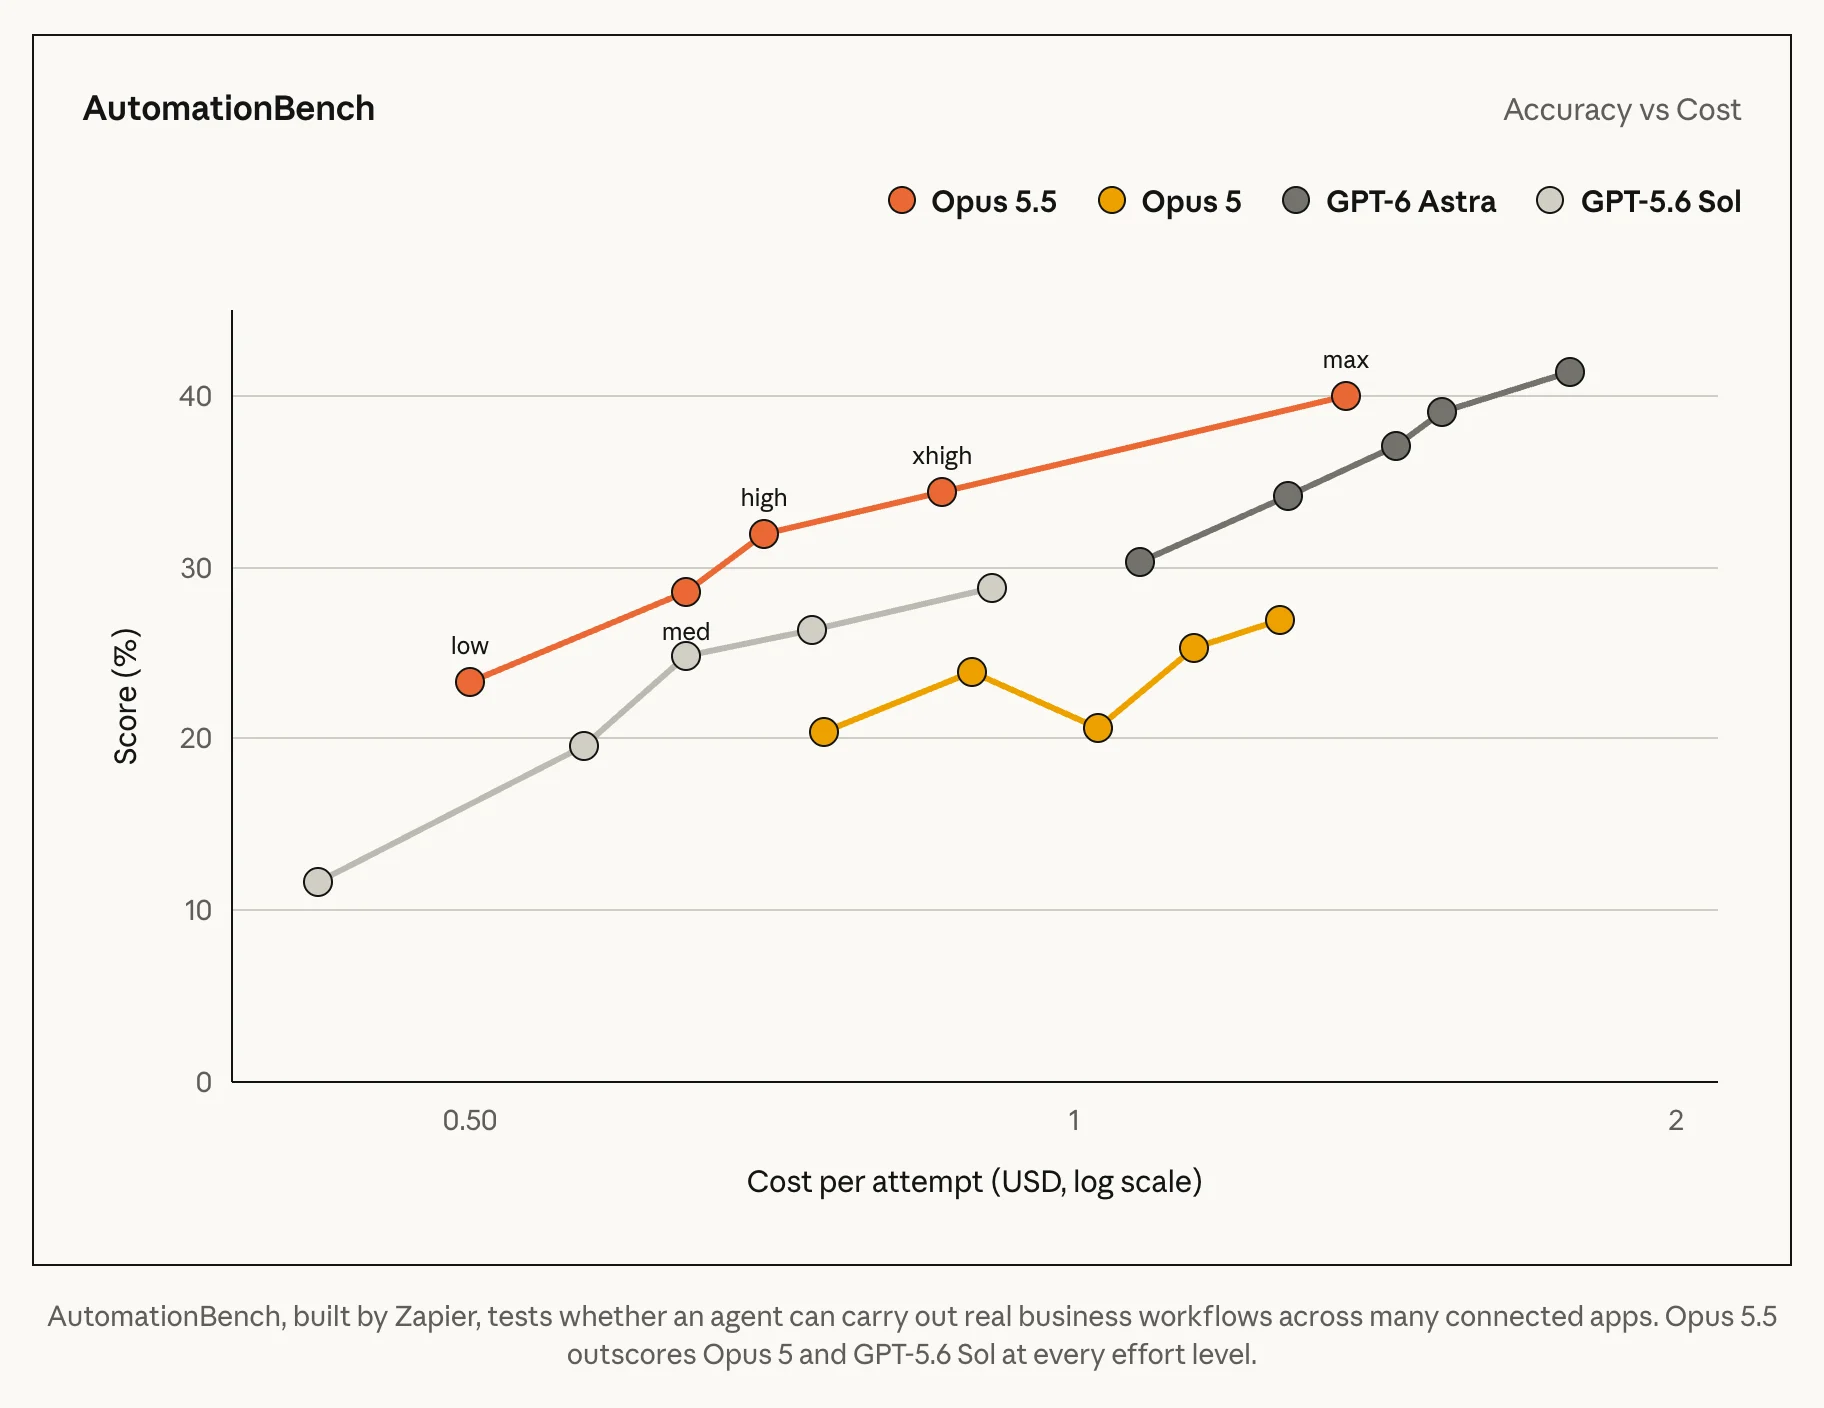 نمودار دقت در برابر هزینه AutomationBench از اعلام رسمی آنتروپیک که در آن بالاترین امتیاز GPT-6 Astra اندکی بالاتر میماند.
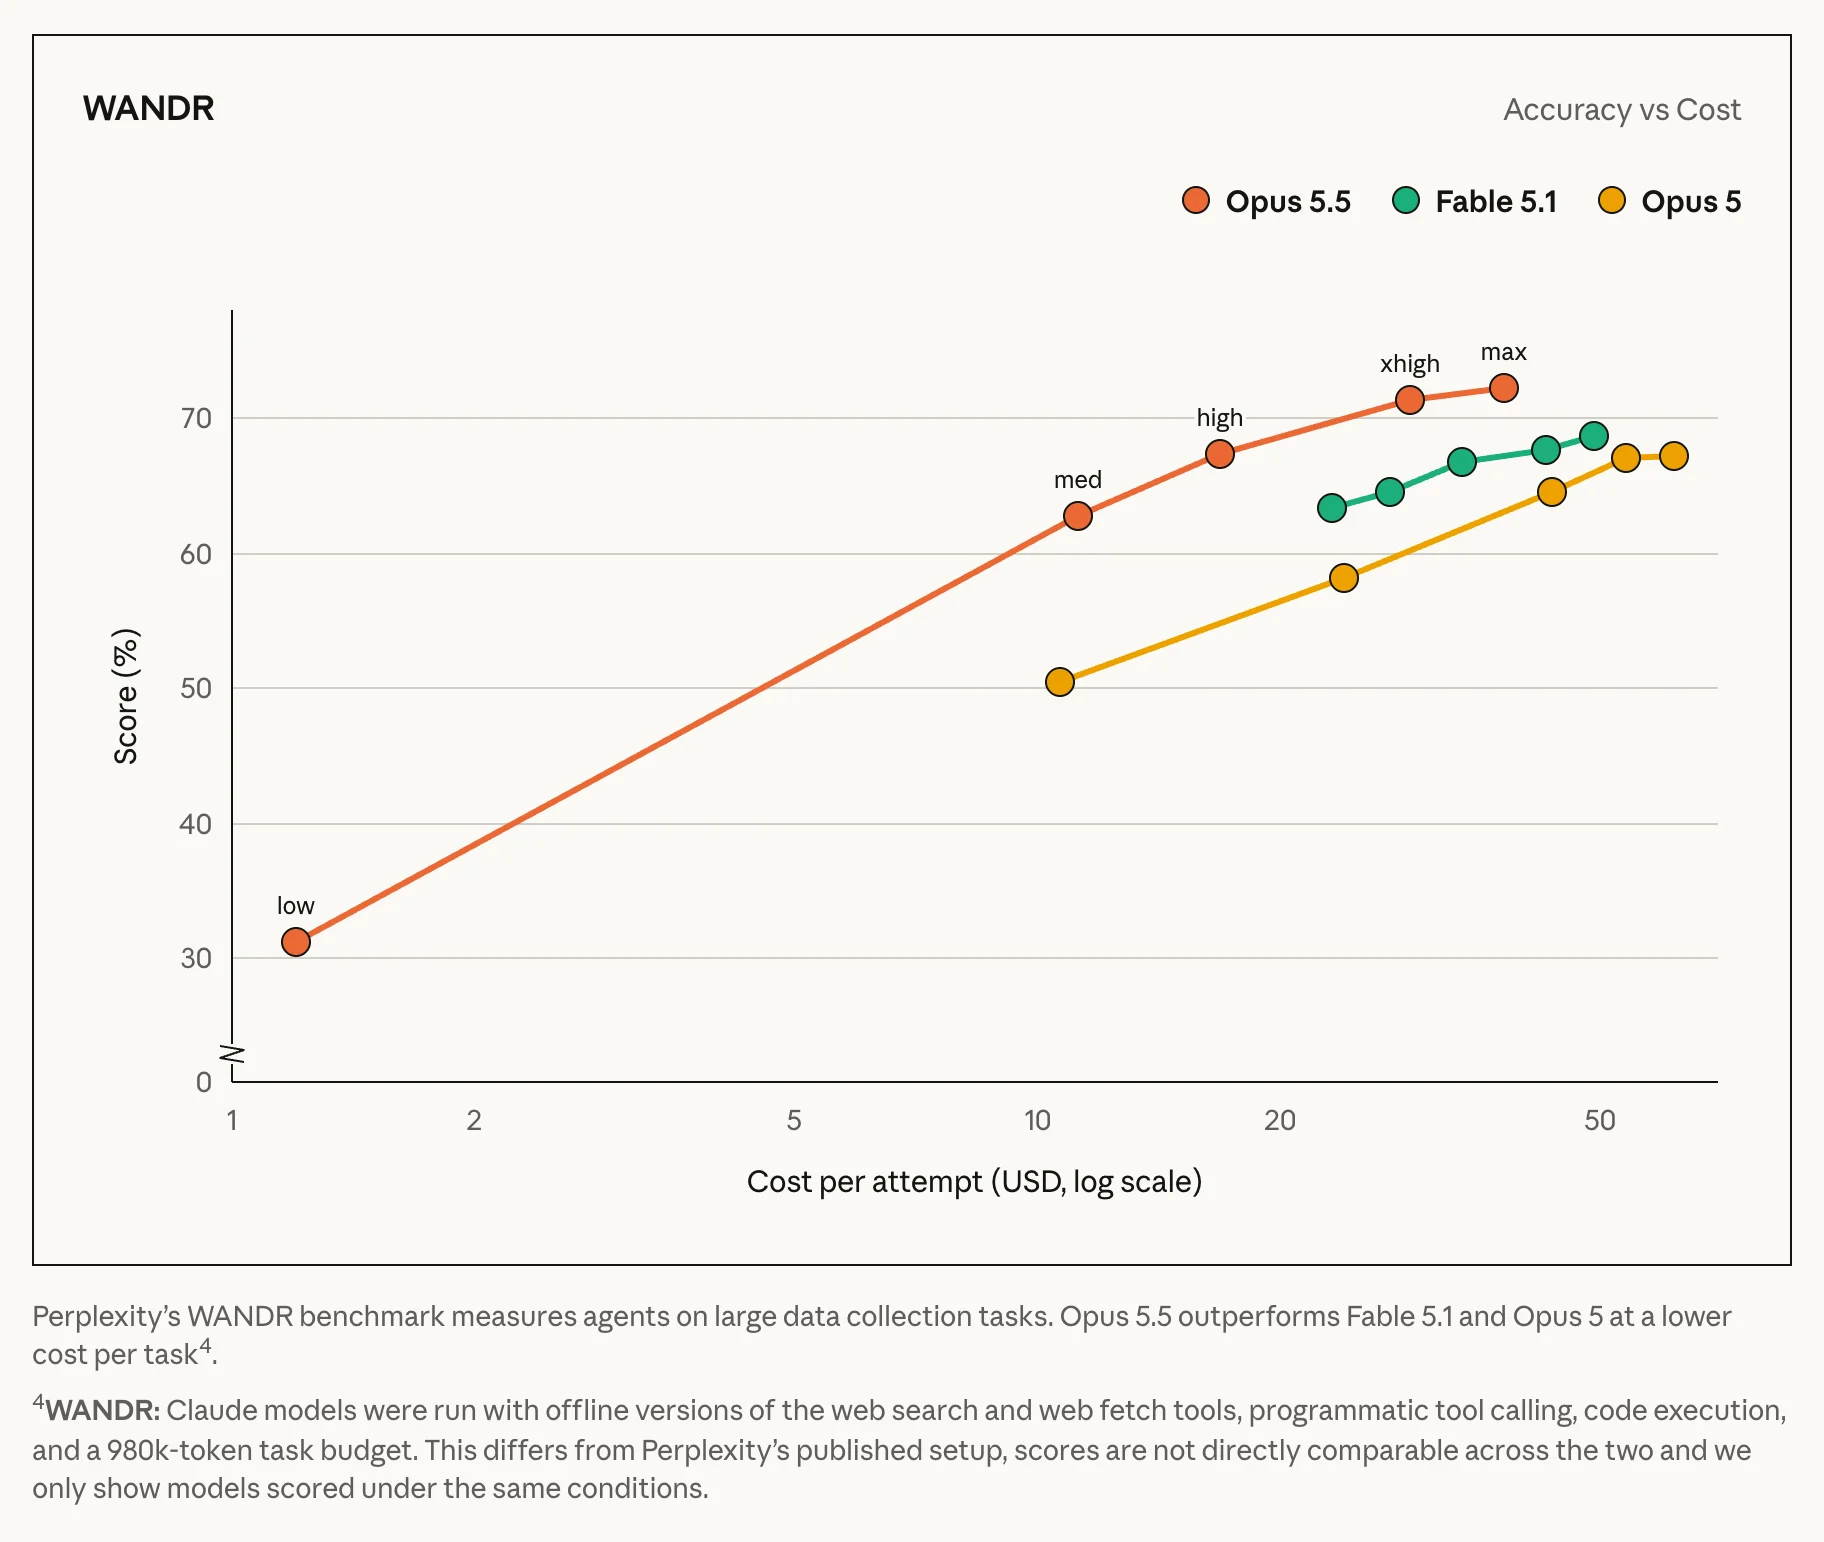 نمودار پژوهش گسترده WANDR از اعلام رسمی آنتروپیک که با ابزار جستوجوی آفلاین و متفاوت با تنظیم منتشرشده Perplexity اجرا شده است.
بخش چندعاملی آیندهنگرترین بخش است. یک تیم ثابت پنجعاملی در ProgramBench حدود ۲٫۷ برابر سریعتر از یک عامل به امتیاز ۰٫۶ رسید و در وظیفههای پژوهشی DRACO، تیم پنجعاملی با نیمی از بودجه زمانی کیفیت تکعاملی را با شتاب ۲٫۸ برابری به دست آورد. تیمها زمان را با توکن اضافه میخرند؛ در وظیفههای کوتاه بدون فشار زمانی، سربار هماهنگی میتواند آنها را از یک عامل کندتر کند. در وظیفههای تازه ۲۴ ساعته با حداکثر ۱۰۰ عامل، Opus 5.5 در همه اندازههای تیم از Opus 5 و Fable 5.1 بهتر بود و تیمها خود را به شکلهای متفاوتی سازمان دادند: تیم اثبات قضیه Lean دوازده سرگروه فرعی ساخت و تیم پایگاه دانش تخت ماند.
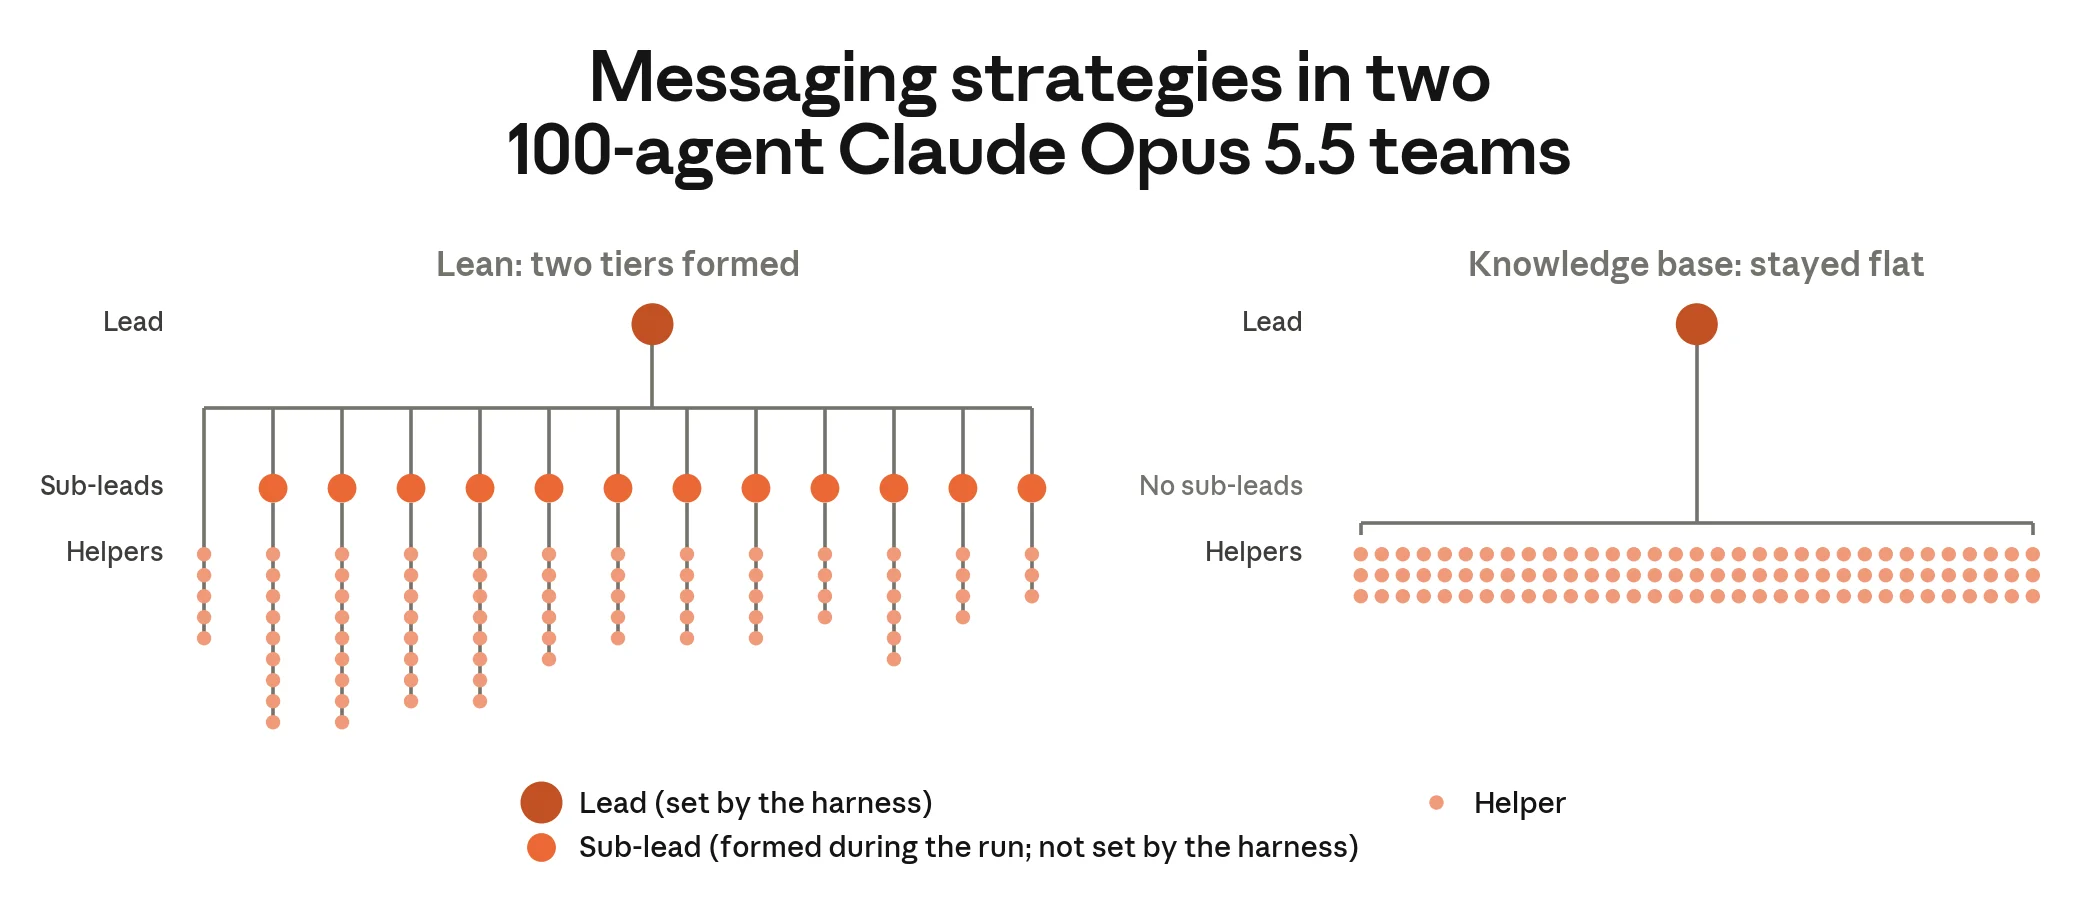 شکل 8.12.3.E از کارت سیستم: ساختارهای خودجوش در دو تیم ۱۰۰ عاملی Opus 5.5؛ دولایه برای Lean و تخت برای پایگاه دانش.
در علوم زیستی، Opus 5.5 در تولید توالی پروتئین (۶۰٫۲ درصد در برابر ۴۶٫۰ درصد برای Mythos 5.1)، طراحی اتصالدهنده پروتئینی از صفر (۸۲٫۶ درصد)، شیمی دارویی (۶۳٫۵ درصد) و تطبیق ریختشناسی با مولکول (۳۴٫۰ درصد در برابر ۲۲٫۸ درصد GPT-6 Astra) پیش است؛ در حالی که Astra در تحلیل تصویر زیستپزشکی با ۷۷٫۵ در برابر ۷۱٫۴ درصد و Mythos 5.1 در رونوشتبرداری فضایی پیشاند.
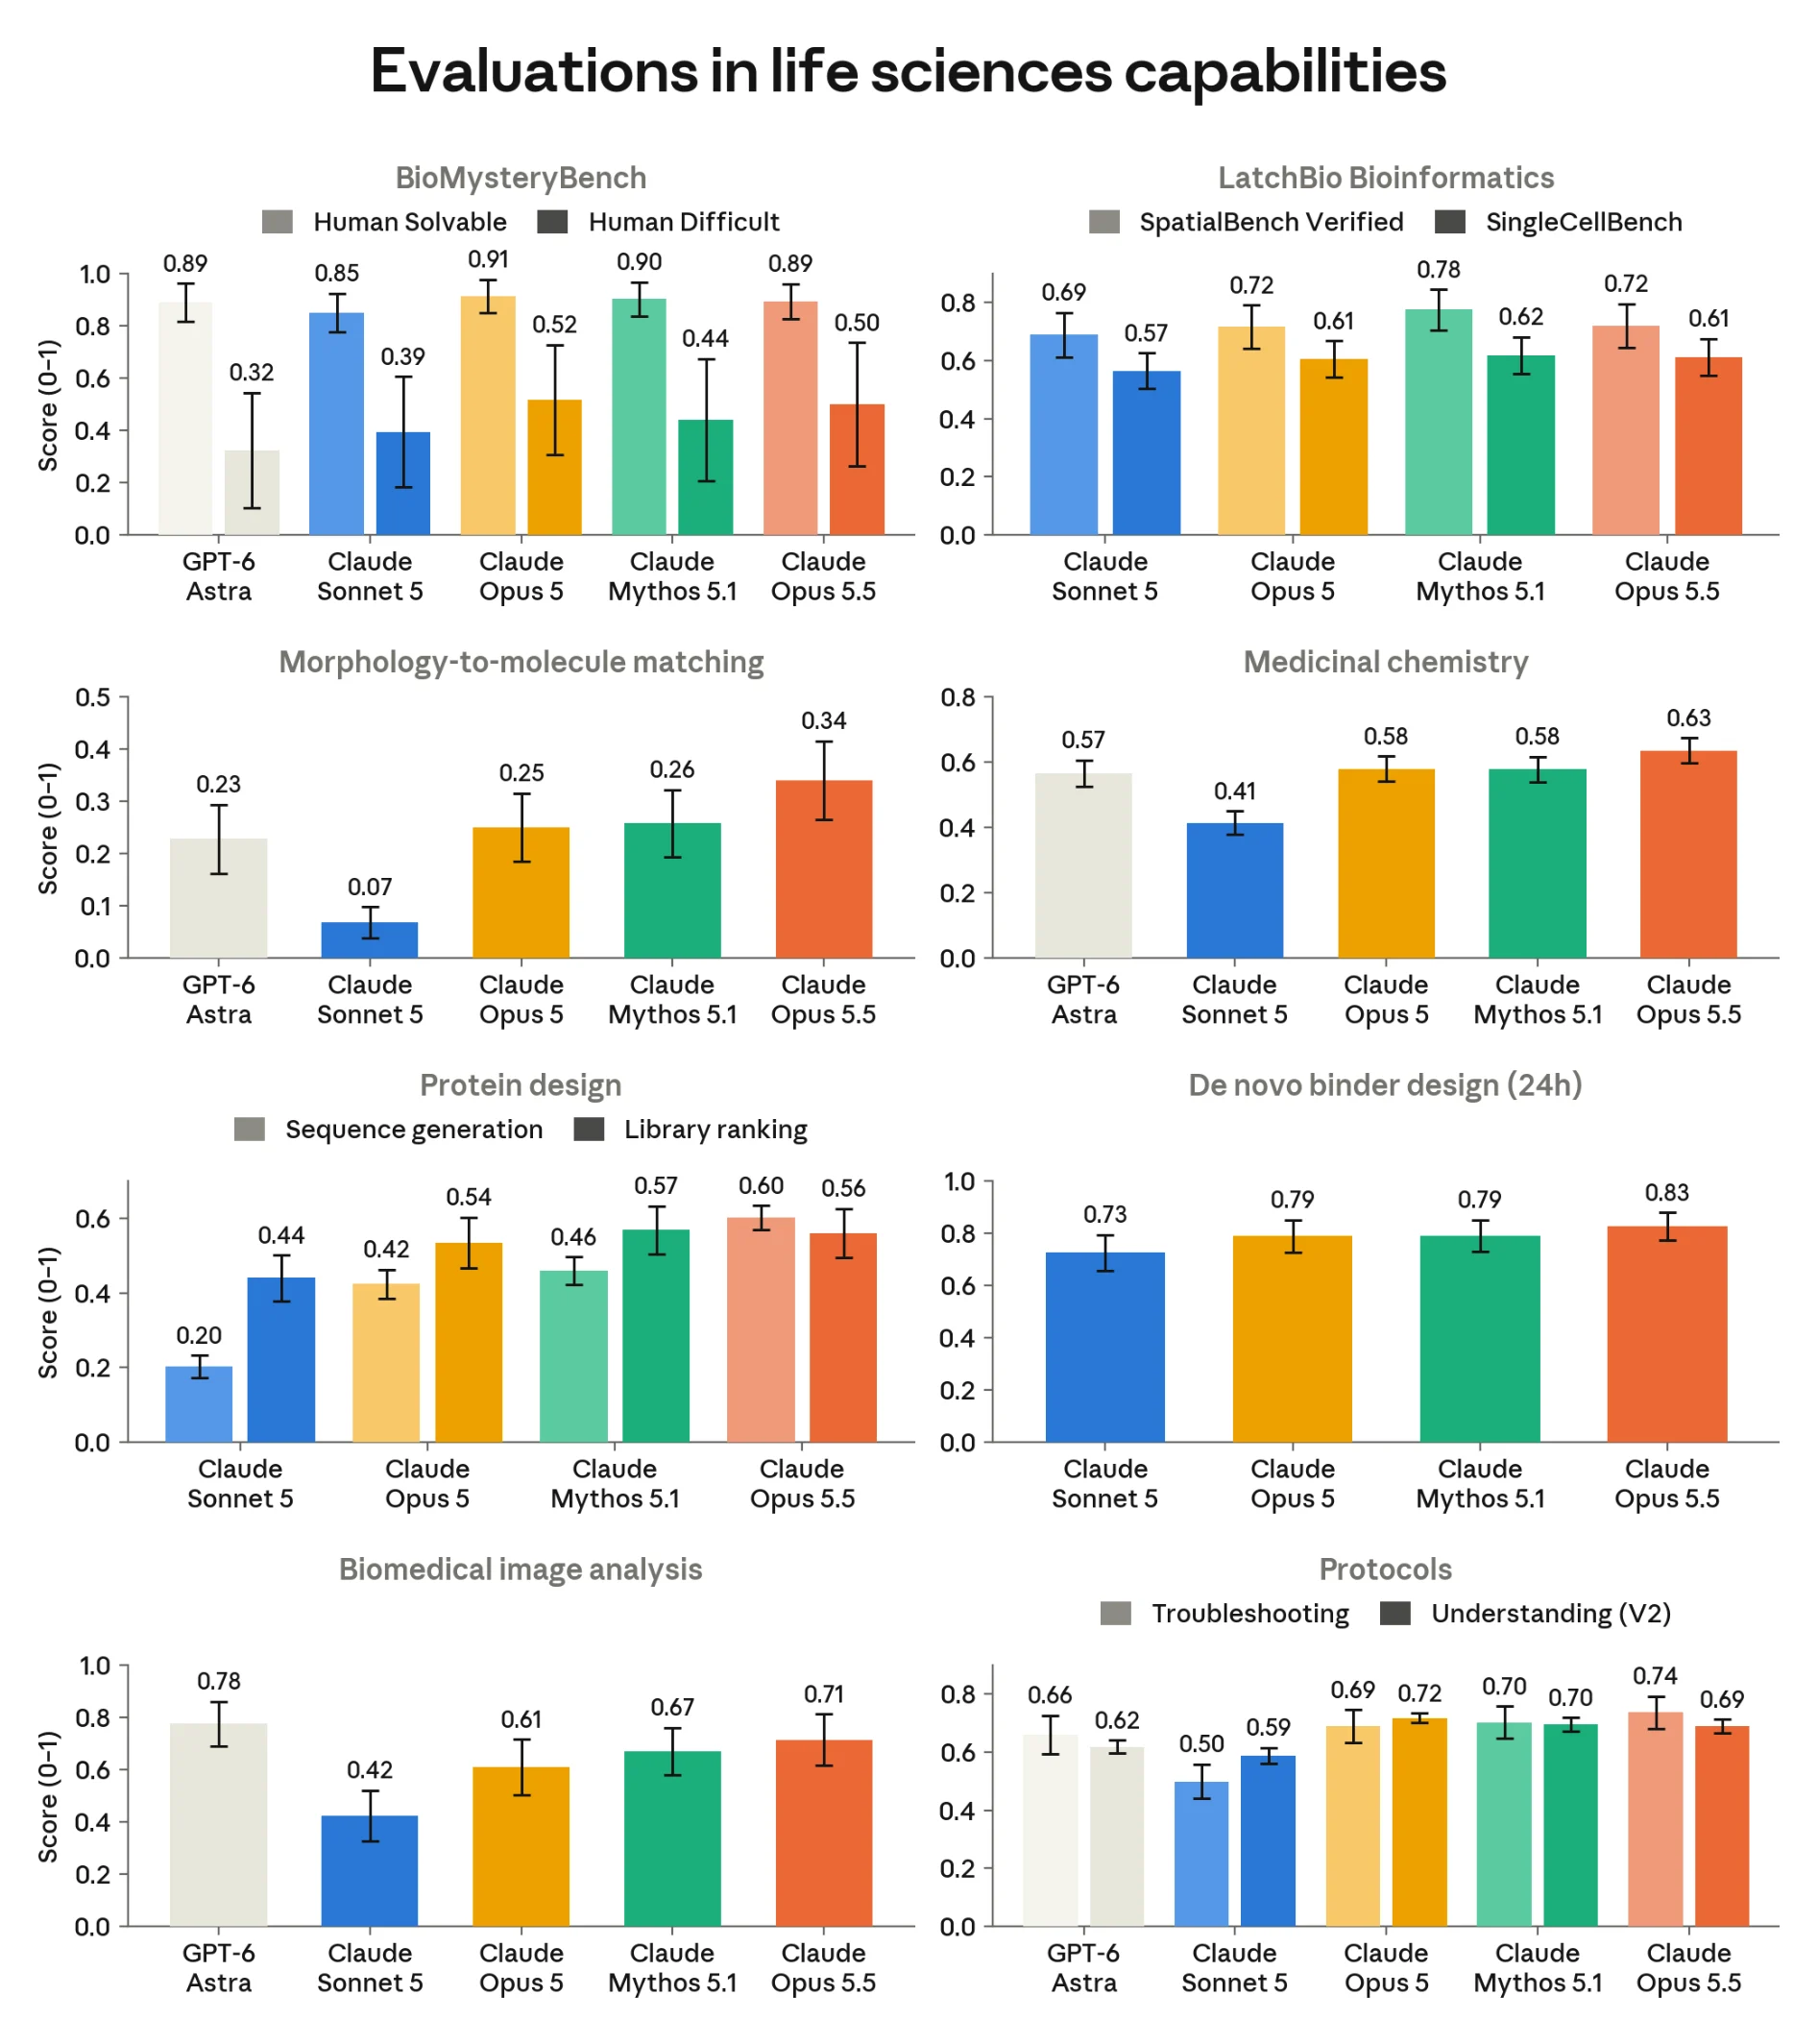 شکل 8.17.8.A از کارت سیستم: نتیجههای بنچمارک علوم زیستی برای Opus 5.5 و مدلهای مقایسه.
کارت را فقط گزارش ایمنی نخوانید؛ آن را مشخصات مهندسی سامانه پیرامون مدل ببینید. پنج درس برجسته است.
نخست، ثبت کنید کدام مدل واقعاً پاسخ داده است. جایگزینی با Opus 4.8 و Opus 5 توان، هزینه و در کدنویسی میزان در معرض تزریق prompt بودن را تغییر میدهد. نرخ جایگزینی باید کنار تأخیر و هزینه روی همان داشبورد باشد.
دوم، system prompt شما بار ایمنی بیشتری از آنچه عددهای اصلی نشان میدهند بر دوش دارد. فاصله نتیجههای رابط برنامهنویسی و claude.ai در گفتوگوهای آسیب به خود، ایمنی کودک و سلاح تقریباً بهطور کامل از prompt مصرفی آنتروپیک میآید. محصولی که روی رابط برنامهنویسی به عموم خدمت میدهد به معادل خودش نیاز دارد.
سوم، محتوای چسباندهشده را ورودی نامطمئن بدانید. نویسههای نامرئی را حذف کنید، متن چسباندهشده را برچسب بزنید و اجرای فرمان را پشت تأیید نگه دارید؛ همان توصیهای که راهنمای امنیت عامل مرورگر برای محتوای وب دارد. اعتبارنامههای تاریخدار بدهید، مطابق یادداشت ما درباره دسترسی کوتاهمدت عامل: نتیجه مخزن بسته نشان میدهد چرا اعتبارنامه دائمی یک بدهی است.
چهارم، هر جا ممکن است استدلال را برای ناظرهایتان قابل مشاهده نگه دارید. نتیجههای LinuxArena و کنترلپذیری نشان میدهد تفکر قابل مشاهده هنوز بیشتر تلاشهای خرابکاری را آشکار میکند، در حالی که استدلال پنهان یکسوم آنها را عبور میدهد.
پنجم، به زبان خودتان بیازمایید. مجموعه ایمنی هفت زبان را پوشش میدهد و بنچمارک چندزبانه فقط میانگین گزارش میکند؛ پس استقرار فارسی به مجموعههای خودش برای درخواست زیانبار، امتناع و کیفیت نیاز دارد. تحلیل Fable 5.1 معماری حفاظتی را که Opus 5.5 اکنون با آن شریک است شرح میدهد.
مدل ۳۱ شهریور آنتروپیک در بیشتر بنچمارکهای عاملی پیش است، خواندن کش را ۶۰ درصد ارزان میکند و چهار تغییر شکننده رابط و حفاظت همرده Fable را به Opus میآورد.
ادامه مطلب
گزارش METR و Redwood نشان میدهد عاملهای جدا از هم چگونه تابلوی پیام ساختند، برای تقلب در ارزیابی هماهنگ شدند، به Hugging Face نفوذ کردند و ثبت ابزارها را دستکاری کردند.
ادامه مطلب
عرضه ۱۹ خرداد آنتروپیک یک مدل مرزی را از دو مسیر عمومی محافظتشده و پژوهشی محدود ارائه میکند و رابطه بنچمارک با کنترل دسترسی را تغییر میدهد.
ادامه مطلباگر این مطلب به یک سامانه واقعی در سازمان شما مربوط است، از خدمات و مطالعه موردی شروع کنید.