فناوری هوش مصنوعی
معرفی DeepSeek V4.1 Flash؛ بینایی، قیمت و جایگزینی V4 Pro
دیپسیک در ۱۰ سپتامبر مدل تازه خود را با بینایی بومی و هزینه کمتر معرفی کرد؛ بررسی نتایج، قیمت API و تغییر مهم مسیر درخواستها در ۱۴ سپتامبر.
ادامه مطلبخوانش فنی گزارش ۵۱صفحهای دیپسیک؛ اجرای رمزگذار–رمزگشای علّی، CSA2، بازپخش محدود، Engram، DSpark و تفاوت کد مرجع با سامانه تولیدی.
برای فهم DeepSeek V4.1 Flash باید سه پرسش را دنبال کرد: مدل خودرگرسیو کجا محاسبه میکند، کدام لایه مالک حافظه است و کدام وضعیت باید پس از توقف نشست باقی بماند؟ عدد شاخص، ۸۹۰ بایت حافظه نهان سراسری KV برای هر توکن است. بخش جذاب مهندسی، وابستگیهایی است که رسیدن به این عدد را ممکن میکنند، بدون آنکه همه لایهها یک رفتار یکسان داشته باشند.
این خوانش فنی بر گزارش ۵۱صفحهای دیپسیک درباره فشردهسازی حافظه نهان KV تکیه دارد و معماری را با کد منتشرشده تطبیق میدهد. فرض بر آشنایی خواننده با ترنسفورمر، حافظه کلید–مقدار و مسیریابی ترکیب متخصصان است. برای دسترسی، قیمت و زمانبندی جایگزینی Pro، تحلیل عرضه مدل را ببینید.
وضعیت شواهد: ابعاد و جزئیات آموزش از دیپسیک نقل شدهاند. معادلههایی که بهعنوان محاسبه معرفی میشوند، بازسازی ما از همان ابعاد هستند. مقاله و کد مرجع بررسی شدهاند؛ وزن مدل اجرا نشده، ارزیابیها بازتولید نشده و حافظه گرافیکی سامانه تولیدی اندازهگیری نشده است. شکلهای رسمی با برچسب اصلی و براساس مجوز MIT مخزن بازنشر شدهاند.
رمزگشای معمولی، تاریخچه را در حافظه نهان نگه میدارد تا هنگام تولید، همه توکنهای قبلی دوباره محاسبه نشوند. اما عامل مرتب خروجی ابزار را اضافه میکند، پیشوند قدیمی را ادامه میدهد و درخواستش ممکن است به کارگر دیگری منتقل شود. در این وضعیت سه گلوگاه مستقل شکل میگیرند: محاسبه ورودیِ بدون اصابت، حافظه پرپهنایباند برای توجه فعال و ذخیرهسازی و انتقال پیشوند قابلبازاستفاده.
گزارش برای هرکدام سازوکار متفاوتی دارد. معماری رمزگذار–رمزگشای علّی یا CED، تعداد لایههایی را که بیشتر توکنهای ورودی طی میکنند کاهش میدهد. توجه تنک فشرده نسخه دوم یا CSA2، وضعیت سراسری تکراری و انتخاب مجدد را کم میکند. ذخیره FP4 هر مدخل را کوچکتر میسازد. بازپخش محدود SWA نیز موازنه نگهداری وضعیت محلی و بازسازی آن را تغییر میدهد.
اگر همه اینها را فقط «فشردهسازی» بنامیم، مرزهای خطایشان پنهان میماند. کوانتیزهسازی دقت عددی را تغییر میدهد؛ انتخاب تنک تعیین میکند چه چیزی قابلبازیابی است؛ اشتراک لایهها بازنمایی را محدود میکند و بازپخش، تاریخچه ازدسترفته را تقریب میزند. ارزیابی استقرار باید این مرزها را جداگانه آزمایش کند.
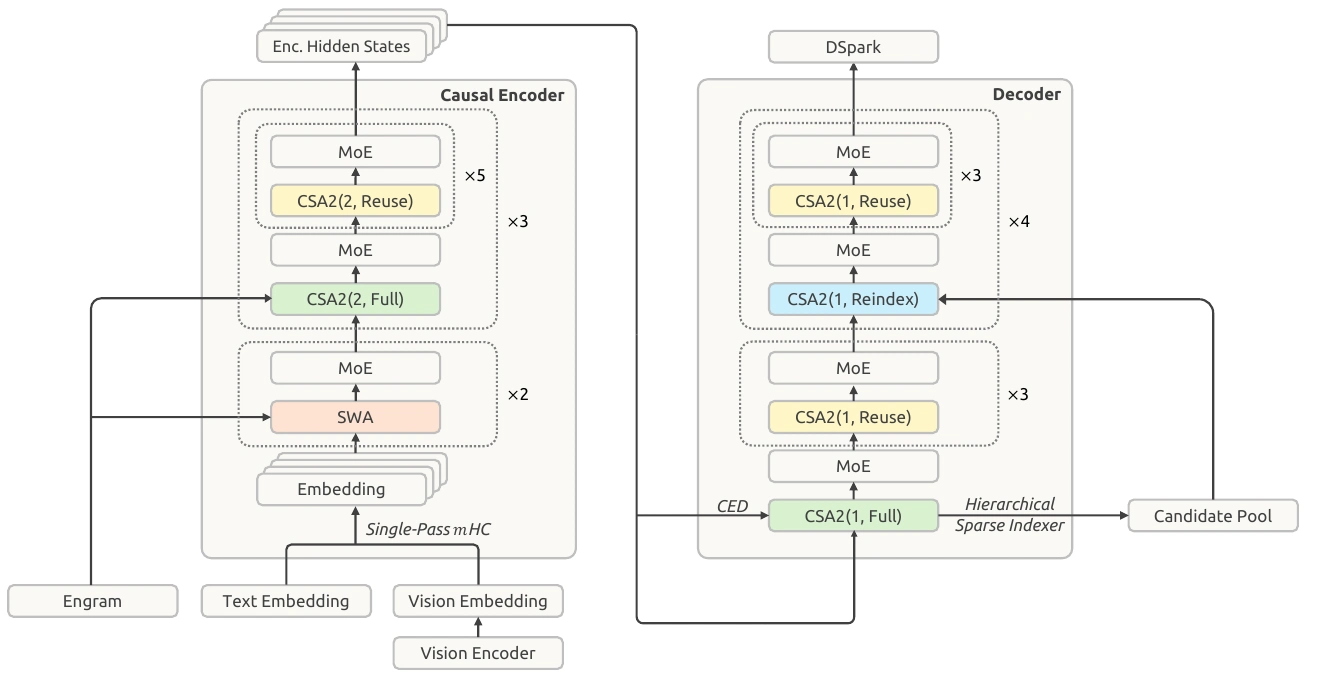
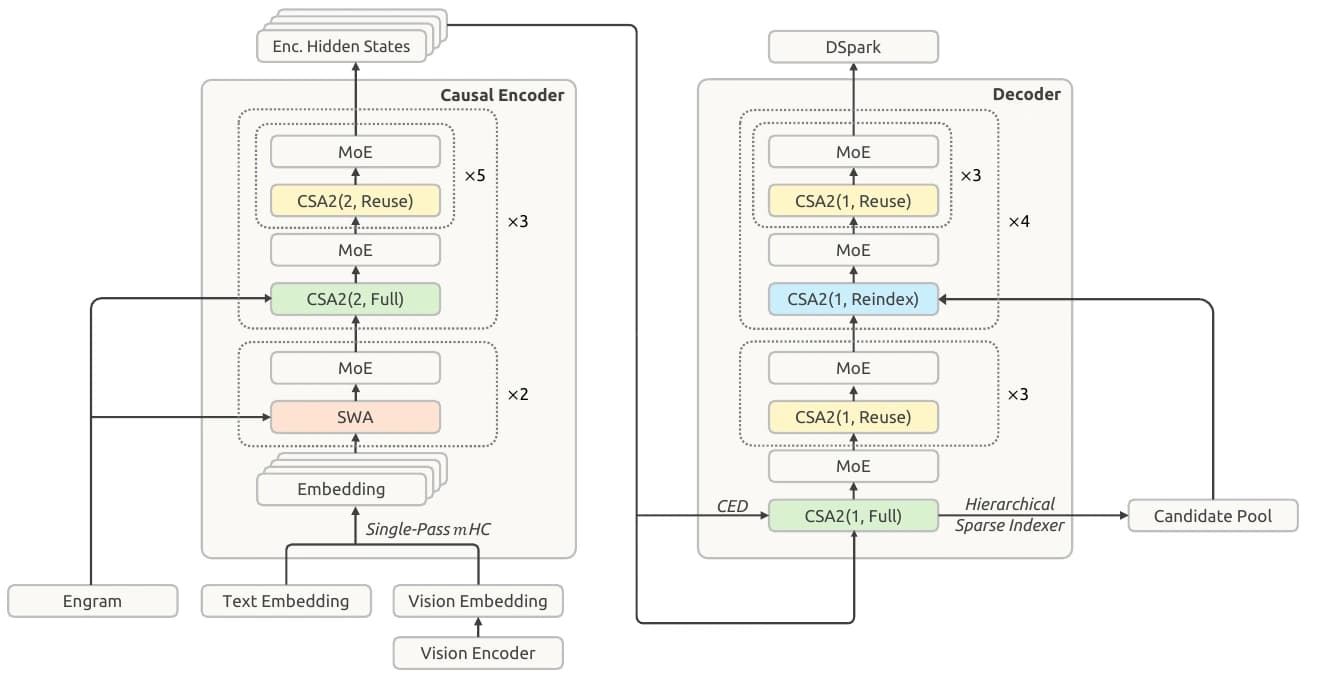 شکل ۳ گزارش دیپسیک، صفحه ۷: رمزگذار و رمزگشای بیستلایه، حافظه Engram، تعبیه تصویر، حافظه سراسری مشترک و DSpark. پیکانها و تعداد تکرارها مطابق شکل اصلی هستند.
پیکربندی ثابت کد استنتاج جزئیات طراحی را مشخص میکند:
| جزء | پیکربندی منتشرشده |
|---|---|
| بدنه زبانی | ۴۰ لایه با عرض ۵۱۲۰؛ رمزگذار ۲۰ و رمزگشا ۲۰ لایه |
| توجه اصلی | ۶۴ سر پرسوجو با بُعد ۵۱۲ |
| نمایهگذار تنک | ۳۲ سر پرسوجو با بُعد ۱۲۸؛ انتخاب ۵۱۲ مدخل |
| توجه محلی | پنجره لغزان ۱۲۸توکنی |
| متخصصان هر لایه | ۳۸۴ متخصص مسیریابیشده و ۱ متخصص مشترک؛ انتخاب ۶ متخصص برای هر توکن |
| لایههای سازنده KV سراسری | ۲، ۸، ۱۴ و ۲۰ با شمارهگذاری از صفر |
| لایههای سازنده نمایه | ۲، ۸، ۱۴، ۲۰، ۲۴، ۲۸، ۳۲ و ۳۶ |
| جریانهای باقیمانده | ۴ |
گزارش ۵۵۲ میلیارد پارامتر بدنه اصلی بهعلاوه ۱۹۶ میلیارد پارامتر Engram را ذکر میکند؛ حدود ۸ میلیارد هنگام پیشپرکردن و ۱۶ میلیارد هنگام تولید فعال میشوند. جمع دو جزء نامبرده ۷۴۸ میلیارد است، اما این جمع تخمین حجم بایتی وزن یا حسابرسی تمام تنسورهای جانبی نیست. ظرفیت ذخیرهشده را باید از کار انجامشده برای هر توکن جدا دانست.
در رمزگشای معمولی، لایه بالاتر کلید و مقدار تاریخچه را از وضعیت پنهان خودش میسازد. ساخت آن حافظه مستلزم عبور ورودی از لایههای قبلی است. CED این وابستگی را برای شاخه سراسری میشکند: KV سراسری رمزگشا مستقیماً از خروجی نهایی رمزگذار تصویر میشود.
اگر H_E وضعیت نهایی رمزگذار باشد، معادله ۱ گزارش را میتوان چنین خواند:
C_l = H_E W_KV,l
Z_l = H_E W_Z,l
در این نمایش، C_l بازنماییهای نامزدِ کلید–مقدار و Z_l وزنهای فشردهسازی را در بر دارد. در طراحی ترکیبی منتشرشده، لایه Full رمزگشا مالک این حافظه سراسری است و لایههای بعدی از آن استفاده میکنند. رمزگشا همچنان پرسوجوی خودش را میسازد و KV پنجره لغزان محلی را از وضعیت پنهان همان لایه به دست میآورد.
رمزگذار اینجا علّی است، نه رمزگذار دوسویهای که توکنهای آینده را ببیند. هنگام تولید، توکن تازه هنوز هر دو نیمه را طی میکند. صرفهجویی مربوط به پیشپرکردن است: بیشتر موقعیتهای ورودی فقط رمزگذار و تصویرسازی کمهزینه حافظه سراسری رمزگشا را لازم دارند. بازپخش کوتاه رمزگشا، وضعیت محلیِ ساختهنشده را فراهم میکند.
برای طول ورودی N، عمق کل L و پنجره محلی W، مقایسه تقریبی کار لایهها در گزارش چنین است:
ordinary prefill: N L
CED prefill:      N L/2 + W L/2
ratio:           1/2 + W/(2N)
با یک میلیون توکن و پنجره ۱۲۸، نسبت حدود ۰٫۵۰۰۰۶۴ میشود. این مثال حسابی ما از مدل ساده کار در مقاله است، نه پیشبینی دوبرابر شدن سرعت واقعی. هستههای توجه، تصویرسازی، رمزگذاری تصویر، ارتباط و وضعیت اصابت حافظه هم اثر دارند. وقتی پسوند تازه کوتاه باشد، سهم نسبی بازپخش مهمتر میشود.
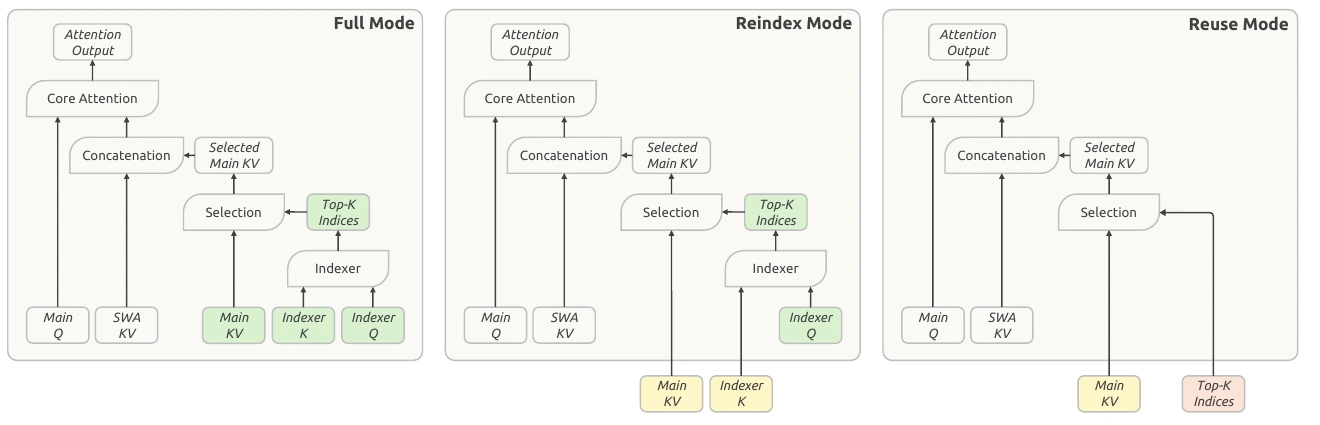
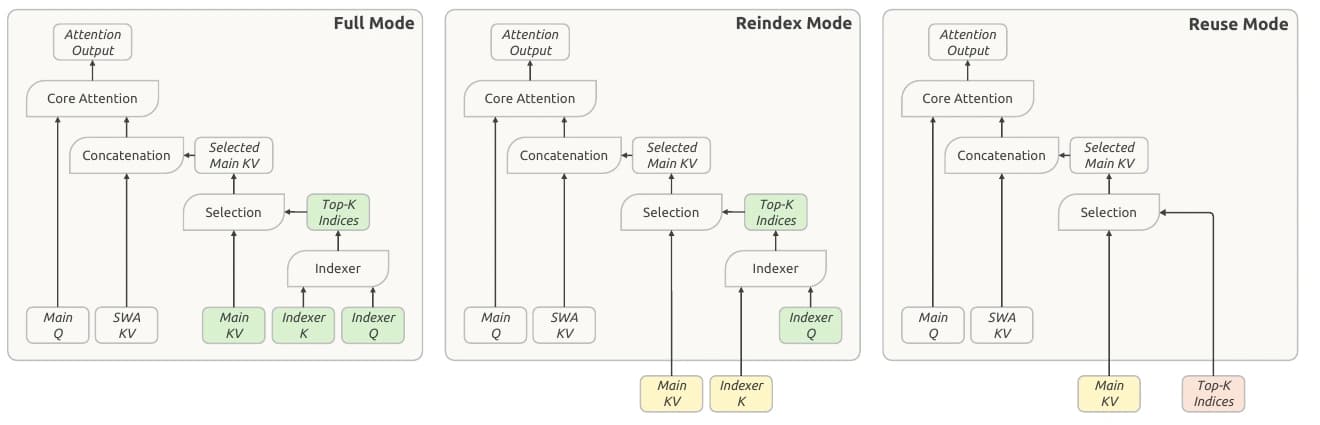 شکل ۴ گزارش دیپسیک، صفحه ۱۰: حالت Full حافظه و نمایه را میسازد؛ Reindex حافظه را شریک میشود ولی دوباره انتخاب میکند؛ Reuse هر دو را به کار میگیرد. پرسوجوی اصلی و KV محلی در همه حالتها تازه محاسبه میشوند.
سه حالت CSA2 از پیش به لایهها اختصاص یافتهاند و گزینهای نیستند که کاربر با متن درخواست انتخاب کند.
| حالت | KV سراسری و کلید نمایهگذار | موقعیتهای برتر | کار مستقل هر لایه |
|---|---|---|---|
| Full | آنها را میسازد | انتخاب تازه انجام میدهد | پرسوجوی اصلی، KV محلی، توجه و متخصصان |
| Reindex | وضعیت آخرین مالک را شریک میشود | با پرسوجوی نمایهگذار خودش دوباره انتخاب میکند | پرسوجوی اصلی، KV محلی، توجه و متخصصان |
| Reuse | وضعیت آخرین مالک را شریک میشود | آخرین انتخاب سازگار را بازاستفاده میکند | پرسوجوی اصلی، KV محلی، توجه و متخصصان |
اشتراک KV ظرفیت ذخیرهسازی را کم میکند و استفاده مجدد از نمایهها، کار انتخاب را. این دو مستقلاند: یکسان بودن حافظه الزاماً به معنی یکسان بودن پرسش بازیابی در همه عمقها نیست. Reindex به لایه عمیقتر اجازه میدهد بدون تخصیص حافظه سراسری تازه، مدخل دیگری انتخاب کند.
حالت Reuse خروجی توجه لایه قبلی را کپی نمیکند. پرسوجوی اصلی تازه میتواند به همان مدخلهای منتخب وزن متفاوت بدهد و شاخه محلی نیز مخصوص همان لایه باقی میماند. به همین دلیل این طراحی از کپی کردن یک نتیجه در سراسر شبکه توانمندتر است.
CSA2 فشردهسازی در امتداد دنباله را هم ساده میکند. گروههای همپوشان نسخه قبلی و تعبیه موقعیت مطلق جداگانه در فشردهساز حذف میشوند. کلید نمایهگذار از KV اصلی تصویر میشود و مسیر فشردهسازی دیگری از وضعیت پنهان ندارد. نسبت یک نیز مجاز است: حتی بدون ادغام موقعیتهای مجاور، بازیابی تنک و اشتراک میان لایهها مفید میمانند.
با شمارهگذاری از صفر، لایههای ۰ و ۱ فقط توجه محلی دارند. لایههای ۲ تا ۱۹ رمزگذار، سه گروه ششتایی میسازند؛ هر گروه یک Full و پنج Reuse با نسبت فشردهسازی دو دارد. لایههای ۲۰ تا ۳۹ رمزگشا، پنج گروه چهارتایی با نسبت یک هستند. لایه ۲۰ حالت Full دارد؛ لایههای ۲۴، ۲۸، ۳۲ و ۳۶ حالت Reindex و بقیه رمزگشا حالت Reuse دارند.
encoder: SWA, SWA, [Full, Reuse ×5] ×3
decoder: [Full, Reuse ×3], [Reindex, Reuse ×3] ×4
نتیجه، چهار مالک حافظه سراسری و هشت لایه تولیدکننده انتخاب نمایه است. هر ۴۰ لایه بدنه همچنان توجه محلی و محاسبه متخصصان دارند. نباید یک حافظه سراسری را در ۴۰ ضرب کرد یا نتیجه گرفت فقط چهار لایه واقعاً اجرا میشوند.
این پیکربندی قرارداد مناسبی برای پیادهسازی است. هنگام انتقال به موتور دیگر، ارتباط مالک KV و انتخابهایی را که نسبت به موقعیتهای آن انجام شدهاند حفظ کنید. استفاده از تنسور نمایهای با نسبت فشردهسازی یا جابهجایی موقعیت متفاوت، ممکن است خروجی ظاهراً معقول بسازد ولی به تاریخچه اشتباه توجه کند.
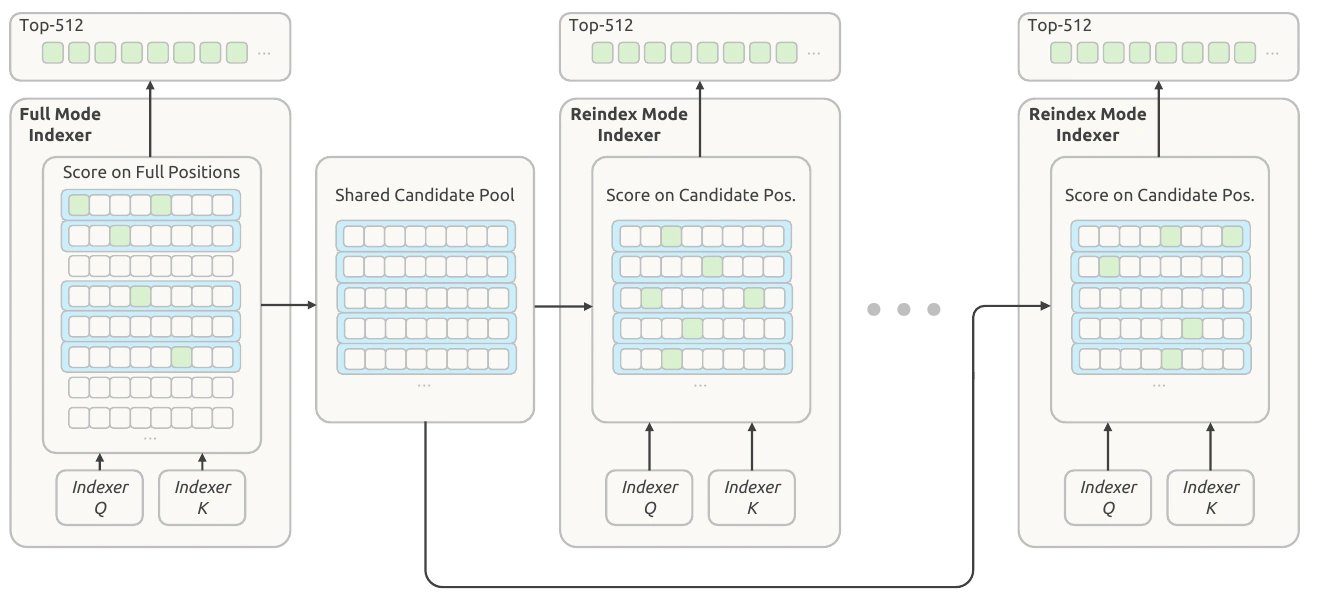
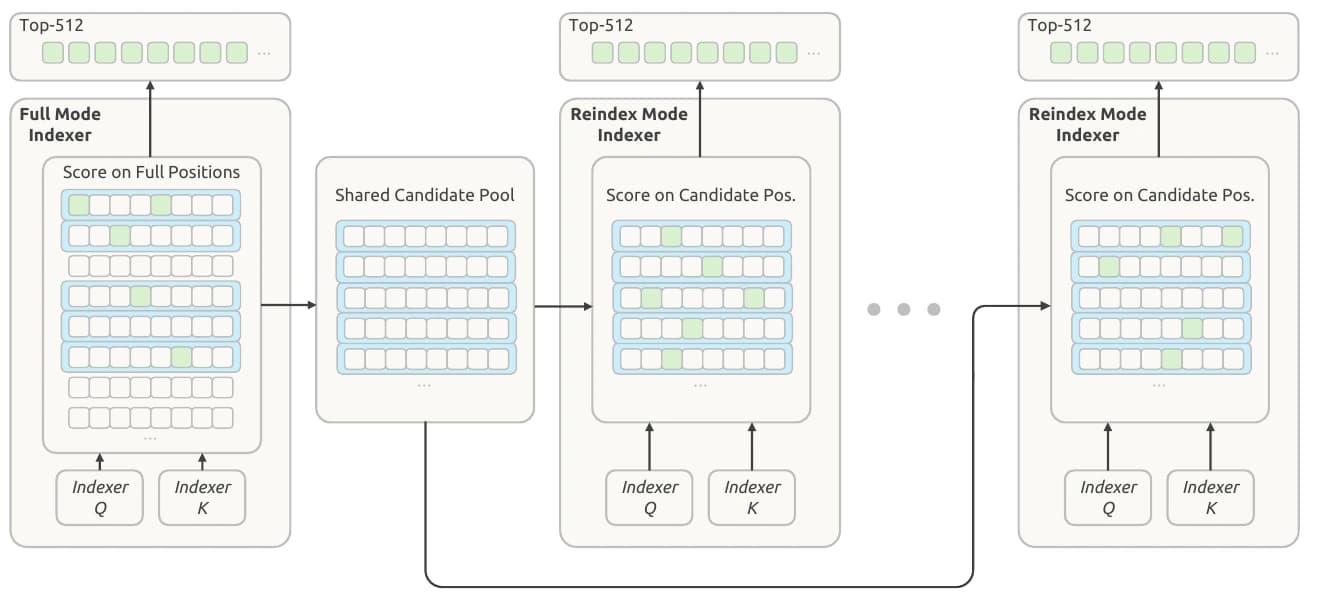 شکل ۵ گزارش دیپسیک، صفحه ۱۱: نخستین نمایهگذار رمزگشا مجموعه نامزد را از بلوکها میسازد؛ لایههای Reindex بعدی، ۵۱۲ موقعیت منتخب خود را از داخل آن برمیگزینند.
اولین لایه Full رمزگشا هنوز همه موقعیتهای سراسری قابلمشاهده از نظر علّی را امتیاز میدهد. علاوه بر انتخاب ۵۱۲ مدخل خودش، بلوکها را با بیشترین امتیاز موقعیت داخل هر بلوک رتبهبندی میکند. حداکثر ۲۰۴۸ بلوک هشتموقعیتی نگه داشته میشود؛ یعنی حداکثر ۱۶۳۸۴ نامزد. لایههای Reindex بعدی، انتخاب ۵۱۲تایی خود را از همین مجموعه انجام میدهند.
مجموعه نامزد عمداً از انتخاب نهایی توجه بزرگتر است. در یک میلیون موقعیت، نمایهگذار بعدی حدود ۶۱ برابر نامزد کمتر از پیمایش کامل بررسی میکند. این نسبت تعداد نامزد است، نه ضریب افزایش سرعت کل سامانه. پیمایش سراسری نخست باقی است، نمایهگذاری رمزگذار کار خودش را دارد و توجه باید مقدارهای منتخب را بخواند.
خطای انتخاب اولیه هم دامنه لایههای بعدی را محدود میکند: تغییر پرسوجو نمیتواند موقعیت دوری را که از مجموعه نامزد حذف شده بازگرداند. گزارش این محدودیت را در پسآموزش اعمال میکند تا مدل با همان دامنه جستوجوی استنتاج آموزش ببیند. بنابراین با یک ماسک بیاثر که فقط هنگام اجرا اضافه شده باشد روبهرو نیستیم.
قالب ذخیرهسازی در گزارش مشخص است و برنامه لایهها تعداد نسخههای آن را توضیح میدهد. محاسبه زیر برای حافظه سراسری بستهبندیشده است و همترازی و سربار تخصیصدهنده را کنار میگذارد.
KV اصلی ۵۱۲ کانال دارد. هر مقدار E2M1 چهار بیت و هر گروه ۱۶کانالی یک مقیاس یکبایتی E4M3 دارد:
main entry = 512 × 4/8 + 512/16 × 1 = 288 bytes
کلید نمایهگذار ۱۲۸ کانال دارد. ذخیرهسازی آن به شیوه MXFP4، مقدار چهاربیتی و یک مقیاس یکبایتی برای هر ۳۲ کانال نگه میدارد:
indexer entry = 128 × 4/8 + 128/32 × 1 = 68 bytes
one global entry pair = 288 + 68 = 356 bytes
هر یک از سه مالک رمزگذار بهازای دو توکن اصلی یک مدخل ذخیره میکند و مالک رمزگشا بهازای هر توکن یک مدخل:
global bytes per original token
  = (3/2 + 1) × 356
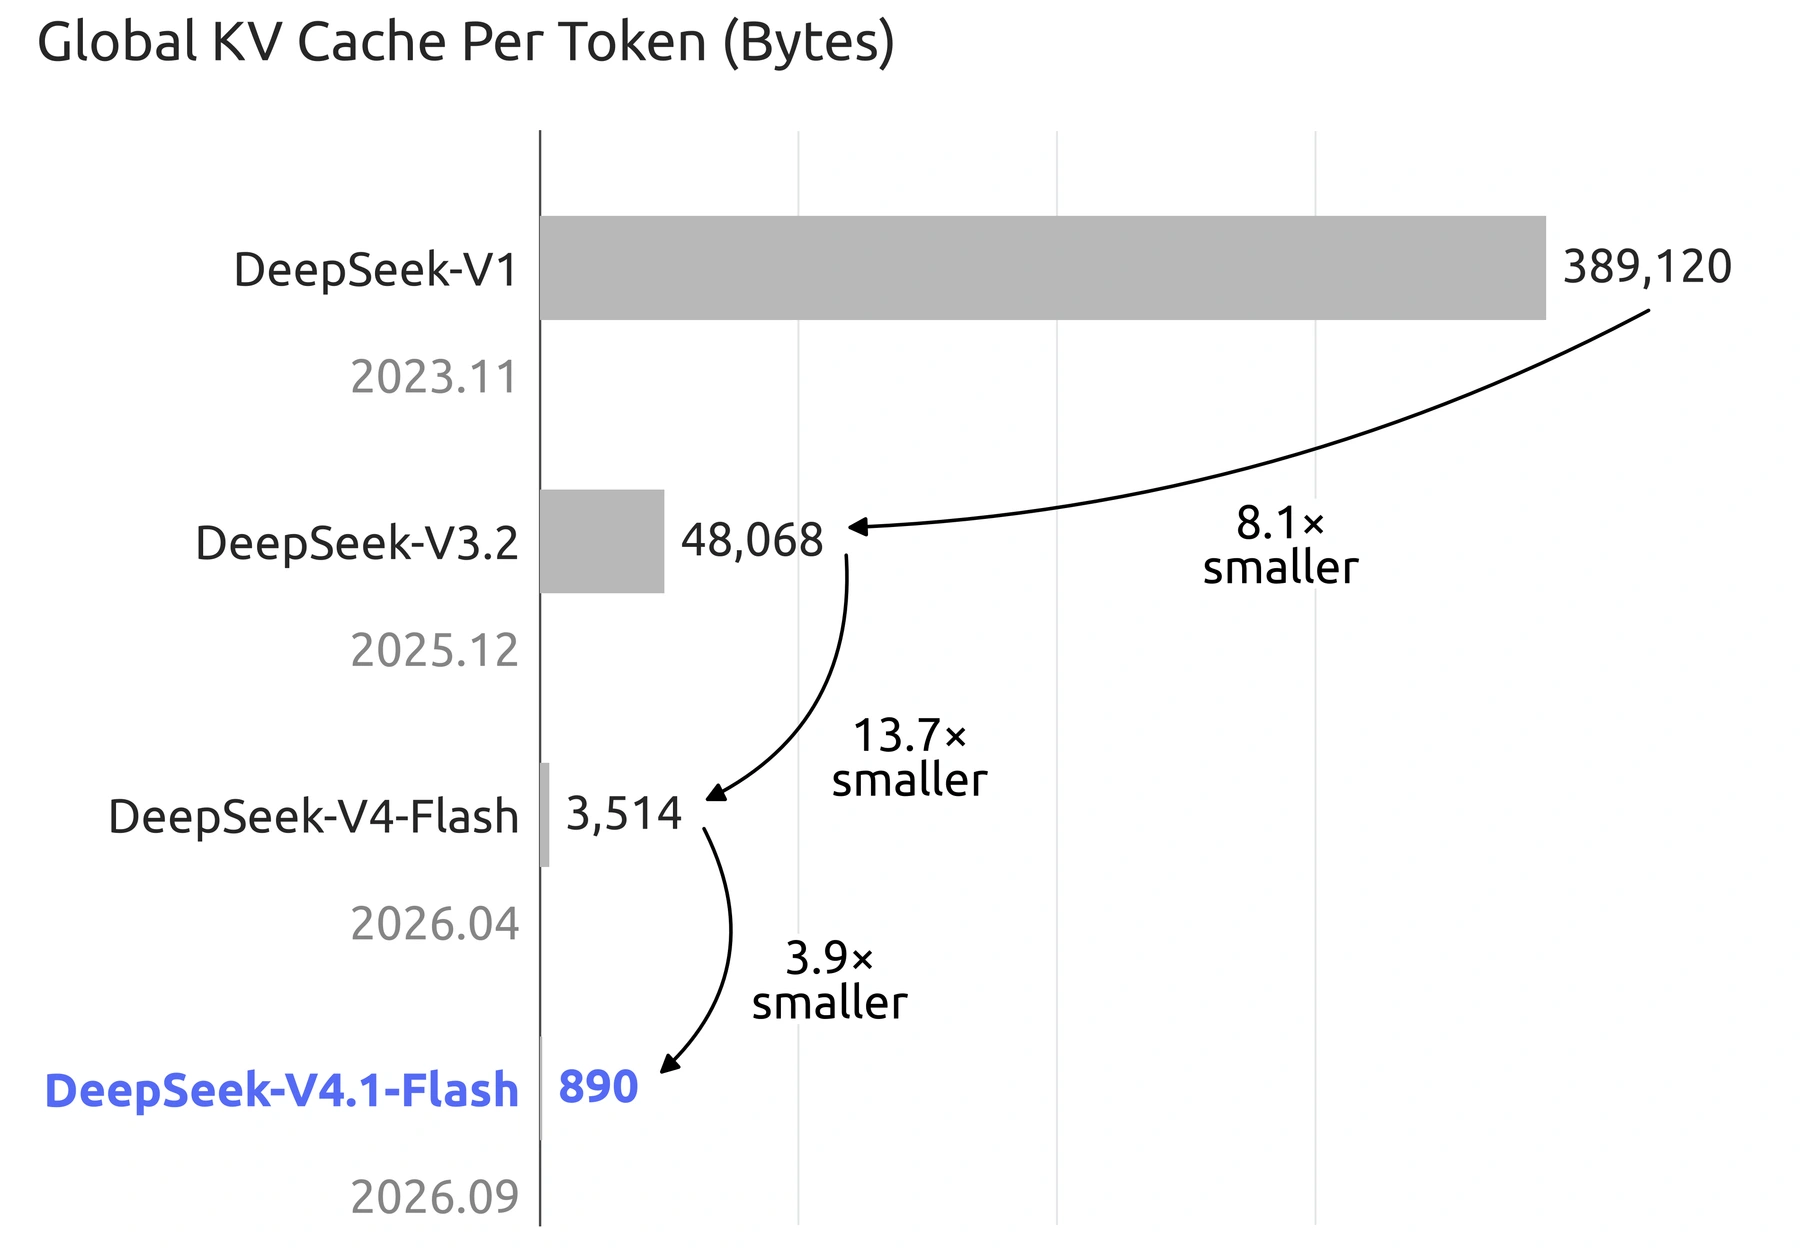
  = 890
برای یک میلیون توکن، این مقدار ۸۹۰ مگابایت با واحد دهدهی یا حدود ۸۴۹ مِبیبایت است؛ فقط برای KV سراسری. در ۱٬۰۴۸٬۵۷۶ موقعیت پیکربندی، مقدار ۸۹۰ مِبیبایت میشود. KV محلی، وزنها، Engram، بافر موقت، ارتباط، نسخههای تکراری و سربار تخصیص خارج از این حساباند. پس این عدد نمیگوید مدل در کارت گرافیکی یکگیگابایتی جا میشود.
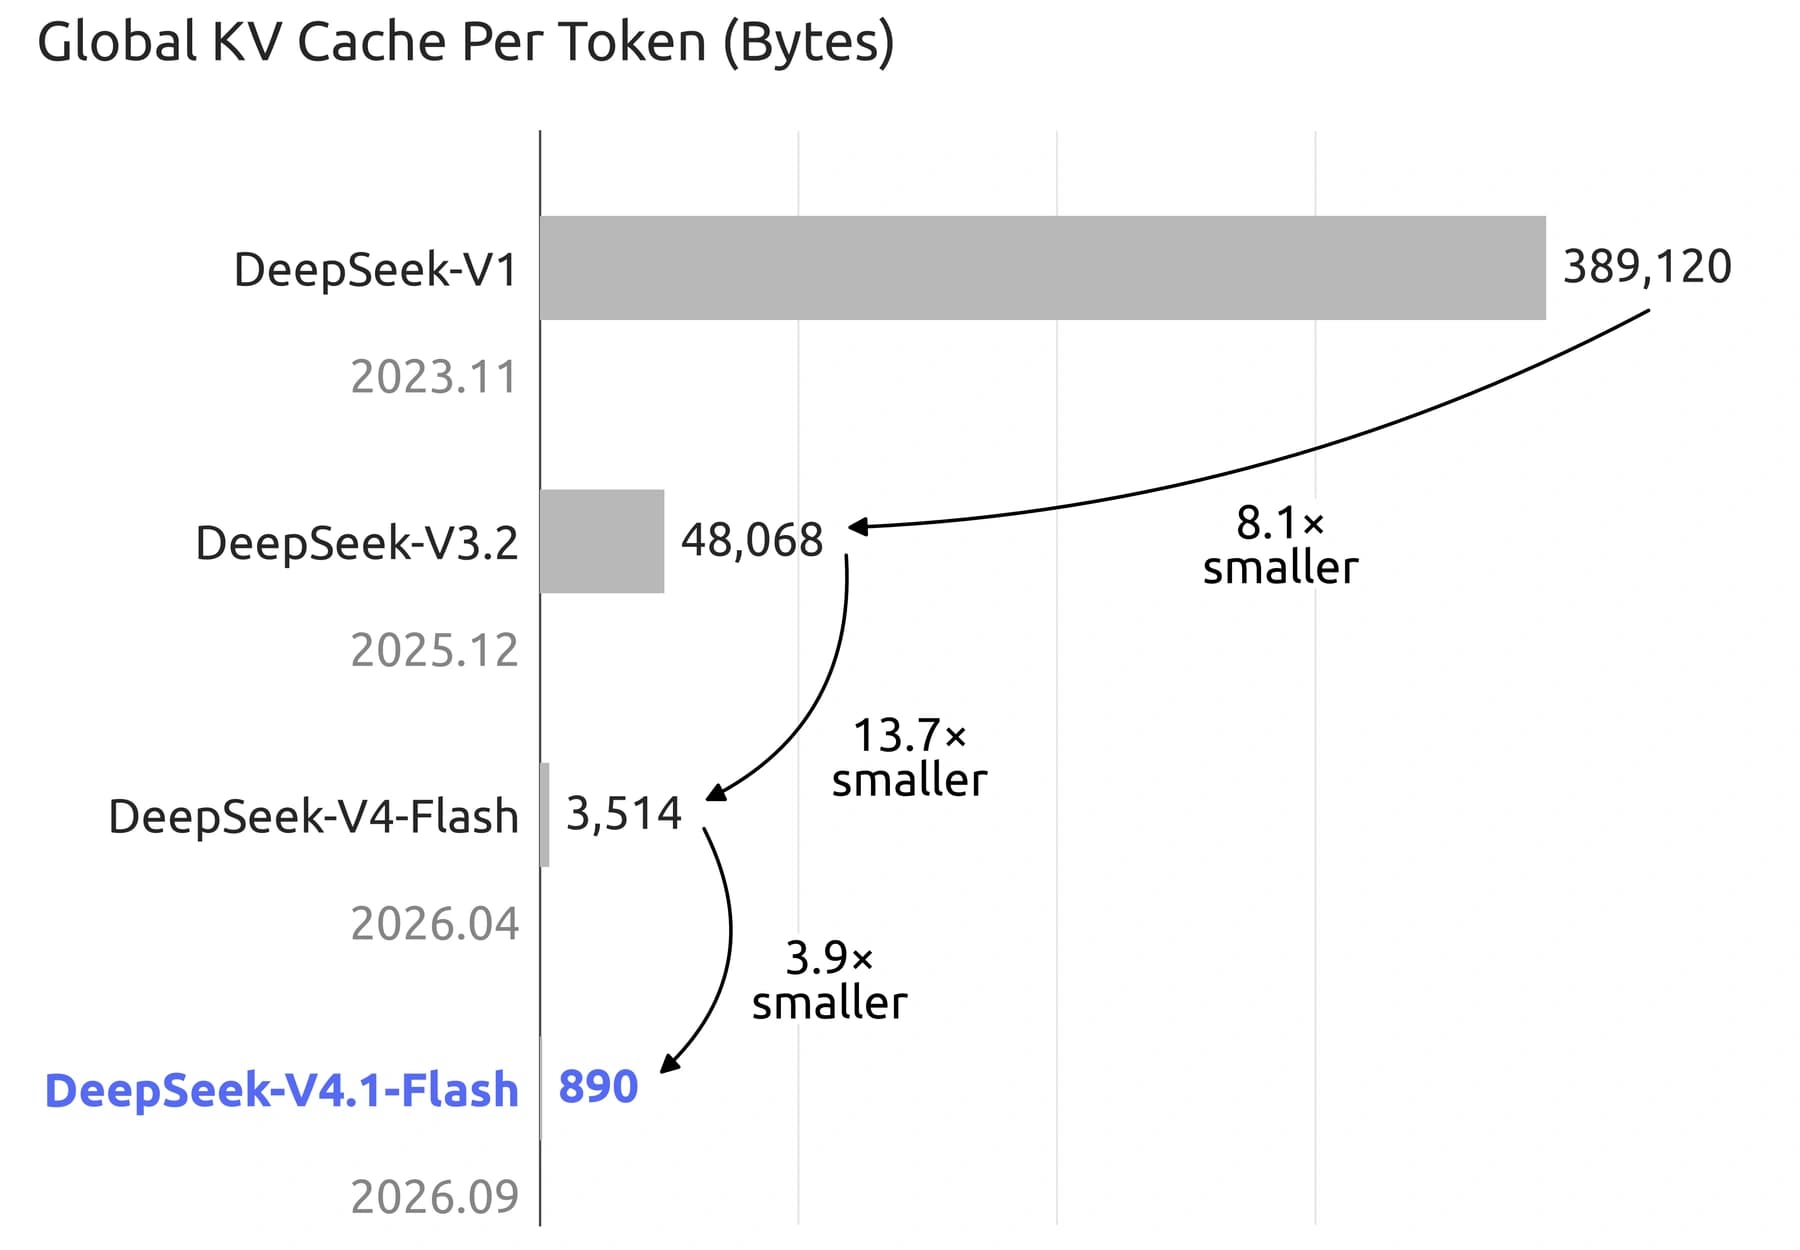 نمودار اصلی دیپسیک برای حافظه سراسری؛ نقطه ۸۹۰بایتی، KV سراسری هر توکن را اندازه میگیرد، نه وزن مدل یا کل حافظه فرایند.
این تفاوت در پیادهسازی مرجع مدل هم دیده میشود: مقدارهای کمدقت با عملیات تنسوری خوانا شبیهسازی میشوند و بافرهای حافظه با نوع داده پیشفرض زمان اجرا تخصیص مییابند. اندازه گرفتن آن بافرها، بازتولید ادعای حافظه بستهبندیشده تولیدی نیست.
کوانتیزهسازی KV اصلی پس از رمزگذاری موقعیت چرخشی انجام میشود. دیپسیک از E2M1 و مقیاس بلوکی E4M3 استفاده میکند؛ ایده مقیاس محلی مشابه NVFP4 است، اما مقیاس سراسری دوم حذف شده است. مقدارها برای توجه از حالت کوانتیزه خارج میشوند؛ بنابراین صرف خواندن حافظه به ضرب ماتریسی بومی با همان قالب ذخیره نیاز ندارد.
آموزش آگاه از کوانتیزهسازی حافظه اصلی در مرحله پسآموزش وارد میشود. KV محلی SWA بهدلیل حساسیت بیشتر، FP8 باقی میماند. عبارت کلی «مدل FP4» دقیق نیست؛ وزن متخصص، تنسور نمایهگذار، KV سراسری و KV محلی نقش و قالب یکسانی ندارند.
هنگام انتقال به زیرساخت دیگر، اندازه بلوک، نوع مقیاس، جایگاه نسبت به RoPE و رفتار گرد کردن را حفظ کنید. ظرف چهاربیتی با قرارداد مقیاس متفاوت، معادل این قالب نیست. احتمالهای خروجی و نتیجه کار را با مرجع دقیقتر مقایسه کنید و فعالسازیهای بزرگ غیرعادی و زمینه نزدیک سقف پشتیبانی را هم بگنجانید.
توجه محلیِ هر لایه وابستگی ظریفی میسازد. با پنجره W و عمق L، بازسازی دقیق وضعیت محلی عمیق ممکن است به بازپخش حدود L × W توکن قبلی نیاز داشته باشد. برای رمزگشای بیستلایه با پنجره ۱۲۸، این مقدار ۲۵۶۰ موقعیت است، نه ۱۲۸.
دیپسیک فقط ۱۲۸ موقعیت آخر را بازپخش و توجه محلی را در مرز بازپخش قطع میکند. اگر آغاز بازپخش s باشد، پرسوجوی موقعیت i بازه max(s, i − W + 1) تا i را میبیند. این وضعیتها تقریبی هستند و از نظر ریاضی با اجرای کامل و بدون وقفه یکسان نیستند.
دو مسیر وجود دارد. بازپخش رمزگذار، اصابت پیشوند سراسری با وضعیت SWA منقضیشده را مدیریت میکند: توکنهای بازپخششده فقط وضعیت محلی را بازسازی میکنند و KV سراسری ذخیرهشده حفظ میشود؛ پسوند تازه هر دو را میسازد. بازپخش رمزگشا، بخش نهایی ورودی را از نیمه بالایی عبور میدهد تا وضعیت محلی لازم برای تولید آماده شود. SWA رمزگشا بهعنوان وضعیت قابلبازاستفاده پیشوند پایدار نمیشود.
سیاست ذخیرهسازی نیز عوض میشود. حافظه سراسریِ با عمر بلند در ذخیره پایدار میماند؛ SWA رمزگذار با عمر کوتاه از مخزن حافظه میزبان استفاده میکند و پس از بیرونانداختهشدن قابلبازسازی است. کاهش حدود هشتبرابری حافظه پایدار از ترکیب کوچکتر شدن مدخلهای سراسری و حذف SWA از مخزن بلندمدت میآید، نه فقط از کوانتیزهسازی چهاربیتی.
گزارش میپذیرد که وضعیت ادامهیافته میتواند به مرز اصابت وابسته باشد. ادامههای تکراری، نوبتهای کوتاه بعدی و واقعیتهای دو سوی مرز را آزمایش کنید. برابری بیتبهبیت معیار مناسب مسیر تقریبی نیست؛ تغییر کیفیت کار و خطاهای بدترین حالت معیارهای مرتبطتری هستند.
اتصالهای فراگیر مقید به منیفلد، چند جریان باقیمانده را حمل میکنند. اگر X_l جریانها، A ترکیب ورودی، B ترکیب باقیمانده و C گسترش خروجی باشد، شکل معمول چنین است:
X_(l+1) = B_l X_l + C_l F_l(A_l X_l)
(A_l, B_l, C_l) = H(X_l)
ترکیب ورودی باید منتظر A_l بماند؛ این ضریب به کاهش روی وضعیت پنهان فعلی وابسته است. نسخه جدید، همین ضریب را یک بلوک عقب میبرد:
X_(l+1) = B_l X_l + C_l F_l(A_(l-1) X_l)
حالا هر قطعه داده در یک گذر هم در ترکیب ورودی و هم در پیشبینی ضریب بعدی مشارکت میکند. هسته تولیدی Mega-mHC بهروزرسانی باقیمانده، ترکیب، پیشبینی ضریب، نرمالسازی و تبدیل را ادغام میکند. برای n جریان با عرض d، گزارش ترافیک فعالسازی (4n + 4)d نسخه قبلی را با (2n + 2)d نسخه ادغامشده مقایسه میکند؛ با چهار جریان، جابهجایی 20d در برابر 10d مقدار است.
این نصف شدن ترافیک همان عملیات باقیمانده است، نه نصف شدن همه پهنایباند مدل. تغییر معماری، بهینهسازی هسته را ممکن میکند و نباید آن را بازنویسی عددیِ کاملاً معادل شبکه mHC قبلی فرض کرد.
Engram دو ماژول تقریباً ۹۸میلیاردپارامتری در لایههای ۱ و ۱۴ با شمارهگذاری از صفر دارد. هرکدام از انگرامهای طول ۲، ۳ و ۴ استفاده میکنند؛ برای هر مرتبه هشت سر درهمسازی و مجموع بُعد تعبیه ۲۰۴۸ در نظر گرفته شده است. جدولهایی با اندازههای اولِ متفاوت، برخوردهای منظم را کاهش میدهند. دروازهگذاری وابسته به زمینه تعیین میکند حافظه بازیابیشده چگونه وارد محاسبه باقیمانده شود.
نشانی به شناسه توکنها وابسته است، پس سامانه میتواند پیش از رسیدن به لایه مصرفکننده، دریافت سطرهای لازم را آغاز کند. گزارش تعبیه FP8 و انتقال پسزمینه از حافظه میزبان با همپوشانی محاسبه مفید را توضیح میدهد. ظرفیت ذخیرهشده بزرگ است، اما برای هر توکن ضرب متراکم روی همه سطرهای حافظه انجام نمیشود.
این حافظه نه پایگاه دانش قابلویرایش کاربر است و نه KV گفتوگو. Engram پارامتر آموختهشده نگه میدارد و KV وضعیت درخواست را. پاک کردن حافظه پیشوند، حافظه آموختهشده Engram را حذف نمیکند. نسبت به طراحی قبلی Engram، پیچش علّی کوتاه حذف و بهروزرسانی مومنتوم با موازنه Sinkhorn برای جدولها استفاده شده است.
پرسش عملی این است که آیا تأخیر جستوجو در اندازه دسته و سرعت ارتباط شما پنهان میماند. تعداد کم پارامتر فعال نمیگوید دریافت از حافظه میزبان بهموقع میرسد یا نه. محل جدولها و پهنایباند را در برنامهریزی ظرفیت وارد کنید.
DeepSeek-ViT دارای ۳۲ لایه، عرض ۱۰۲۴، شانزده سر و وصلههای ۱۴پیکسلی است. عملیات بازچینی پیکسل در بلوکهای ۳ در ۳، همسایگی فضایی را به کانال منتقل میکند؛ سپس تصویرساز دولایه خروجی را به عرض مدل زبانی میرساند. تعبیههای دیداری کنار تعبیه متن در همان دنباله علّی قرار میگیرند.
برای تصویر ۱۳۴۴ در ۱۳۴۴، محاسبه روشن است: 1344/14 = 96 وصله در هر ضلع و سپس 96/3 = 32 موقعیت دیداری در هر ضلع؛ یعنی ۱۰۲۴ توکن دیداری. این مثال معماری در آن وضوح است، نه ادعای اینکه هر تصویر با همین تعداد توکن صورتحساب میشود.
مسیریابی نیز نوع داده را تفکیک میکند. بایاسهای اصلاحی جدا، بار متخصصان برای توکن تصویر و متن را متعادل میکنند؛ امتیاز مسیریابی اصلی همچنان وزن خروجی متخصصان منتخب را تعیین میکند. بار تجمیعی ممکن است تمرکز یک نوع داده روی چند متخصص را پنهان کند. این سازوکار به بهرهبرداری هنگام آموزش مربوط است، نه تضمین دقت یکسان میان زبانها یا انواع سند.
DSpark سه بلوک ترنسفورمر با پنجره ۱۲۸توکنی دارد. امتیاز پایه پنج موقعیت پیشنویس را همزمان محاسبه میکند، وابستگی میان توکنها را با سر سبک مارکوف مدل میکند و احتمال پذیرش شرطی را پیشبینی میکند. زمانبند، برآورد بقای پیشوند را با منحنی توان عملیاتی اندازهگیریشده موتور ترکیب میکند تا طول تأیید مناسب بار فعلی انتخاب شود.
پنج موقعیت پیشنویس، تضمین پنج توکن پذیرفتهشده یا سرعت پنجبرابری نیست. مدل هدف باید پیشنهاد را تأیید کند؛ کار ردشده، اشغال دسته و هزینه تأیید، سود واقعی را تعیین میکنند. اگر تأیید طول بیشتر توان عملیاتی سامانه را کم کند، زمانبند میتواند پیشوند کوتاهتر را ترجیح دهد.
راهنمای استنتاج منتشرشده صریحاً میگوید با وجود مسیر پیشروی DSpark، تولید از نمونهگیری خودرگرسیو معمولی استفاده میکند. آزمون کوچک آن هم بررسی شکل تنسورها و اتصال هستهها با وزن مقداردهینشده است. اجرای این آزمون یا وجود تابع forward_spec، شاهد عملکرد رمزگشایی حدسی تولیدی نیست.
گزارش ۴۵ تریلیون توکن پیشآموزش را توصیف میکند؛ توجه تنک از زمینه ۶۴هزارتوکنی شروع میشود و پس از ۳۴ تریلیون توکن به یک میلیون گسترش مییابد. دستور پسآموزش همچنان تنظیم نظارتشده، یادگیری تقویتی و تقطیر برخطِ سیاست است. گزارش تغییرات اصلی پسآموزش را به ساخت داده و محیط نسبت میدهد، نه الگوریتم تقویتی تازه.
تلاش استدلالی بهصورت عددی از ۱ تا ۱۰۰ آموزش میبیند. در هر زیرگروهِ ورودی و سطح تلاش، پاداش شامل جریمه طولِ سقفدار است که ضریب آن بهصورت نمایی کاهش مییابد:
length_penalty = -min(C_max, k(b) × reasoning_length / L_norm)
k(b) = k_0 × exp(-(b - b_min) / tau)
تلاش بیشتر فشار برای توقف زودهنگام را کم میکند. گزارش سطوح عمومی low، high و max را بهترتیب به ۵۰، ۷۵ و ۱۰۰ نگاشت میکند. مرجع رمزگذاری درخواست تلاش عددی را در قالب زیربنایی مستند میکند؛ از این نمیتوان نتیجه گرفت هر کتابخانه خدمت میزبانیشده، عدد دلخواه را در فیلد عمومی تلاش میپذیرد.
کارایی معماری و طول استدلال به هم وابستهاند. نصف شدن کار ورودی، ارزانتر شدن کار کامل را تضمین نمیکند اگر سطح انتخابشده خروجی بسیار بیشتری بسازد. ابتدا هزینه و تکمیل را در تلاش ثابت مقایسه کنید، سپس مرز کیفیت–هزینه را بسنجید و همه تغییرها را به طراحی حافظه نسبت ندهید.
از آرایههای مالکیت در پیکربندی شروع کنید. مسیر مالک را در Compressor، Indexer، Attention و وضعیت توجه مشترک دنبال کنید. مطمئن شوید انتخاب نمایه به مالک درست حافظه اشاره میکند و حساب موقعیتها میان قطعات فشردهشده صحیح میماند.
سپس معنای مرجع را از اجرای بهینه جدا کنید. نمایهگذار خوانا ابتدا امتیازها را میسازد و بعد دامنه نامزد را ماسک میکند؛ این شاهد هسته تولیدیای نیست که اصلاً موقعیتهای حذفشده را امتیاز ندهد. مسیر پیشروی مرجع هم بدنه را طی میکند و کل خط لوله تولیدیِ حذف محاسبه پیشپرکردن، بازپخش محدود و اجرای تفکیکشده را نشان نمیدهد. ذخیره بستهبندیشده و زمانبندی شواهد جدا میخواهند.
ماتریس آزمایش عملی باید پیشپرکردن سرد، اصابت کامل، اصابت فقط سراسری، ادامههای تکراری، بازیابی بلند با عوامل حواسپرتی، دنباله پُرتصویر و نشست همزمان را در بر بگیرد. زمان اولین توکن، فاصله توکنها، زمان کل تکمیل، بیشینه حافظه، بایت منتقلشده و نرخ کار پذیرفتهشده را ثبت کنید. راهنمای عملیات مدلهای باز انضباط نسخه و انتشار پیرامون این آزمونها را توضیح میدهد.
خود مقاله خطای انتخاب تنک و مرزهای بازپخش تقریبی را کاملاً شناختهشده نمیداند. دستاورد مهندسی آن مجموعه منسجمی از موازنهها میان محاسبه، حافظه و ذخیرهسازی است. بازتولید این دستاورد به حفظ همزمان بازنمایی و سیاست اجرا نیاز دارد؛ همراه با آزمایش جاهایی که تقریبهای آنها به هم میرسند.
بازبینی در ۱۱ سپتامبر ۲۰۲۶. شماره صفحهها همان شماره چاپشده گزارش است. شکلهای ۳ تا ۵ مستقیماً از PDF رندر شدهاند و نمودار حافظه فایل اصلی مخزن است. شکلهای اصلی اثر دیپسیک باقی میمانند؛ محاسبات، مقایسههای توضیحی و آزمایشهای پیشنهادی تحلیل ژرف هستند.
دیپسیک در ۱۰ سپتامبر مدل تازه خود را با بینایی بومی و هزینه کمتر معرفی کرد؛ بررسی نتایج، قیمت API و تغییر مهم مسیر درخواستها در ۱۴ سپتامبر.
ادامه مطلب
استرا با پیشرفت در کار علمی و استفاده از رایانه، قابلیتهای تازه برای عاملها و قیمت بالاتر معرفی شد؛ بررسی شواهد و راهنمای عملی ارزیابی این مدل.
ادامه مطلب
انتشار ۱۰ شهریور آنتروپیک کار عامل و پژوهش علمی را تقویت میکند، قیمت خواندن کش را ۷۵ درصد کاهش میدهد و قرارداد نگهداری استدلال را تغییر میدهد.
ادامه مطلباگر این مطلب به یک سامانه واقعی در سازمان شما مربوط است، از خدمات و مطالعه موردی شروع کنید.