آموزش هوش مصنوعی
مهندسی زمینه هوش مصنوعی: معماری، امنیت و ارزیابی
چگونه از سیاست، وضعیت کار، شواهد، حافظه و ابزار، کوچکترین زمینه قابل اعتماد را بسازیم و آن را در برابر تعارض، نویز و حمله بسنجیم.
ادامه مطلبخوانش برنامهنویسانه مستندات Jev شرکت TypeSafe؛ ساختار درخواست، انتخاب میان Choice و Score و Noul، پرسش موازی، امتیاز ترکیبی، مسیریابی با اطمینان، حالتهای شکست و ارزیابی.
فراخوانی Jev، نخستین مدل System One شرکت TypeSafe، ساده است و بد بهکاربردنش هم ساده. رابط برنامهنویسی فقط یک نقطه پایانی دارد که یک وضعیت و مجموعهای از پرسشهای نوعدار میگیرد. بخش دشوار معماری است: اینکه کدام داوری سهم مدل است، کدام سهم کد، و سامانه وقتی مدل مطمئن نیست چه میکند.
این راهنما مستندات رسمی TypeSafe را برای نسخه jev-1.13.0 دنبال میکند و از آن یک روش طراحی میسازد. اگر پیشتر با Jev آشنا نشدهاید، از معرفی ساده و تحلیل انتشار آن شروع کنید.
وضعیت شاهد: شکل رابط، محدودیتها و نتیجههای نمونههای آموزشی در ادامه از مستندات TypeSafe آمده که در ۳۱ شهریور ۱۴۰۵ بازبینی شده است. ما رابط را فراخوانی نکردهایم. شرایط TypeSafe استفاده از کشورهای تحت تحریم آمریکا، از جمله ایران، را ممنوع میکند؛ بنابراین بخش پایانی توضیح میدهد همین طراحی را چگونه با مدلهایی که تیم مجاز به استفاده از آنهاست پیاده کنید.
مستندات سه معماری را مقایسه میکند. نرمافزار سنتی درخت تصمیم بزرگی است که از قطعههای ساده و قابل اتکا ساخته شده است. عامل LLM دستورها را میخواند و گام بعدی را خودش انتخاب میکند؛ تا وقتی کسی نظارت کند خوب کار میکند، اما هر دور حلقه فرصت تازهای برای خارجشدن از مسیر است. در چیزی که TypeSafe آن را نرمافزار مجهز به هوش مصنوعی مینامد، جریان کنترل و کار قطعی در دست کد است و مدل فقط جایی فراخوانده میشود که سامانه به داوری عقل سلیم درباره ورودی بیساختار نیاز دارد.
Jev برای شکل سوم طراحی شده است. راهنمای ساخت آن را به چند قاعده خلاصه میکند: هر کاری را که کد دقیق انجام میدهد به کد بسپارید؛ ورودی را به بخشهای نامدار تقسیم کنید؛ هر داوری مبهم را به پرسشهای باریک بشکنید؛ پرسشهای زیادی را با هم بپرسید؛ پاسخها را در کد ترکیب کنید؛ و بر اساس عدم قطعیت مسیر را تعیین کنید. ادامه این راهنما همین قاعدهها را باز میکند.
سود این کار آزمونپذیری است. هر پرسش واحدی است که جدا ارزیابی میشود، هر آستانه عددی در کنترل نسخه است و تصمیم نهایی کدی معمولی است که بازبین میتواند بخواند.
همه فراخوانیها با یک توکن به POST https://api.typesafe.ai/v1/systemone فرستاده میشوند. بدنه درخواست یک model، یک state و نقشهای به نام questions دارد. هر پرسش شناسهای دارد که خودتان انتخاب میکنید، یک type، یک instructions و برای Choice و Score فیلد criteria که پاسخهای مجاز را تعریف میکند.
{
  "model": "jev-1.13.0",
  "state": "Hi, I've been trying to connect my Stripe account for 3 days and the integration keeps failing. I'm losing sales. Please help ASAP.",
  "questions": {
    "department": {
      "type": "choice",
      "instructions": "Which team should handle this",
      "criteria": {
        "billing": "Payment or subscription issues",
        "technical": "Bugs or integration problems",
        "sales": "Pricing or account questions"
      }
    },
    "is_urgent": {
      "type": "noul",
      "instructions": "The message conveys urgency or time-sensitivity"
    }
  }
}
پاسخ، نسخه دقیق مدلی را که جواب داده، یک پاسخ نوعدار برای هر شناسه پرسش و میزان مصرف توکن را برمیگرداند. در اجرای آغاز سریع TypeSafe، پرسش department با گزینه technical، احتمال ۰٫۸۵ برای فنی و ۰٫۱۵ برای مالی و اطمینان ۰٫۷۸ برگشت و is_urgent مقدار Noul برابر ۱٫۰ گرفت. توکن ورودی ۰٫۰۴۲ دلار برای هر یک میلیون حساب میشود و توکن خروجی رایگان است.
دو جزئیات عملیاتی از روز نخست مهم است. نخست، نام مستعار jev-latest با انتشار نسخه تازه جابهجا میشود؛ پس وقتی آستانهها را تنظیم کردید، نسخه jev-1.13.0 را ثابت کنید و فیلد model هر پاسخ را ثبت کنید. دوم، سقف درخواست (در زمان بازبینی ۲۵۰ هزار توکن در ثانیه و ۱٬۲۰۰ درخواست در دقیقه) با تقاضا تغییر میکند و SDKهای رسمی پاسخ 429 را با تأخیر فزاینده دوباره امتحان میکنند.
مرجع پرسشها قاعده سادهای میدهد: نوعی را انتخاب کنید که کد بتواند مستقیم بر اساس پاسخش عمل کند.
other یا «هیچکدام» بگذارید. Choice نسبی است: میگوید کدام گزینه بهترین است، نه اینکه آیا اصلاً گزینه خوبی وجود دارد.دامی که پیش از ساختن باید بشناسید: Jev همخوانی منطقی میان پرسشها را حفظ نمیکند. مثال خود TypeSafe نشان میدهد Noul «درخواست بازپرداخت» و نقیض آن روی هم ۱٫۱۹ میشوند و یک Noul و یک Choice بله و نه درباره همان پرسش با هم همخوان نیستند. هر تصمیم را فقط به یک شکل بپرسید و آستانهای را که روی یک نوع پرسش تنظیم کردهاید به نوع دیگر منتقل نکنید.
وضعیت همان مادهای است که Jev دربارهاش داوری میکند. میتواند یک رشته باشد، اما TypeSafe توصیه میکند هر جا تصمیم به مقایسه چند بخش بستگی دارد، از شیء JSON با نامهای گویا استفاده کنید؛ مثلاً یک تیکت، سفارش پشت آن و سیاستی که بر آن حاکم است.
پرسشها میتوانند با مسیر به بخشهایی از وضعیت اشاره کنند؛ مسیری که در دستور و میان علامتهای backtick نوشته میشود، مثل پرسیدن اینکه آیا refund_policy از بازپرداخت درخواستشده در ticket.messages[0].text با توجه به order.charges پشتیبانی میکند. مسیر صریح ابهام را کم میکند و ردیابی پاسخ اشتباه را آسانتر.
وضعیت را کوچک و مرتبط نگه دارید. با بزرگشدن مطالب نامربوط دقت افت میکند؛ حالتی که TypeSafe آن را فرسایش زمینه مینامد. اول در کد بازیابی و پالایش کنید، یا پیش از پرسش اصلی با یک Noul ارزان مرتبطبودن متنها را غربال کنید. سقف سخت، ۶۴ هزار توکن برای کل درخواست و ۳۲ هزار توکن برای وضعیت بهاضافه طولانیترین پرسش است. ورودی فقط متن است: تصویر، صدا و ویدیو باید پیشتر به متن یا فیلدهای ساختاریافته تبدیل شوند.
چون هر پرسش مستقل و موازی درباره همان وضعیت ارزیابی میشود، درخواستی با پرسشهای زیاد کمی بیشتر از درخواستی با یک پرسش هزینه دارد: هزینه وضعیت فقط یک بار پرداخت میشود. TypeSafe توصیه میکند هر پرسشی را که ممکن است کد لازم داشته باشد بپرسید، حتی پرسشهایی که فقط برای بعضی ورودیها مهماند، و بگذارید کد پاسخهای بیربط را نادیده بگیرد.
نمونه آموزشی پرسشهای موازی این را روی یک گزارش انطباق درباره مقاله حدوداً ۵۴ هزار نویسهای ویکیپدیا درباره GDPR میآزماید، با ۱۳ پرسش (۸ Noul، ۲ Choice و ۳ Score). فرستادن هر ۱۳ پرسش در یک درخواست ۱۲٫۲ برابر ارزانتر و ۱۰٫۰ برابر سریعتر از ۱۳ فراخوانی جداگانه بود و پاسخها تغییری نکردند؛ بیشترشان در هر پنج تکرار کاملاً یکسان بودند. (صفحه مرجع پرسشها از اجرای دیگری ۱۱٫۵ و ۹٫۶ برابر نقل میکند.)
همین استقلال یک پیامد طراحی دارد: پاسخ یک پرسش هرگز زمینه پرسش دیگری در همان درخواست نمیشود. درخواست دوم را فقط وقتی بفرستید که کد واقعاً بدون پاسخ نخست نمیتواند آن را بسازد؛ مثلاً وقتی پاسخ نخست تعیین میکند کدام سند را باید آورد.
هر پاسخ Choice و Score فیلد confidence دارد؛ عددی میان ۰ و ۱ که از میزان تمرکز توزیع احتمال به دست میآید. الگوی مسیریابی با اطمینان آن را محور دوم میبیند: پاسخ میگوید «چه»، اطمینان میگوید «آیا اقدام کنیم».
from typesafe_sdk import Choice, TypeSafeClient

client = TypeSafeClient(model="jev-1.13.0")

response = client.system_one(
    state=voice_command_transcript,
    questions={
        "intent": Choice(
            instructions="What is the user asking the bank to do?",
            criteria={
                "check_balance": "Hear the current account balance",
                "approve_transfer": "Approve the pending transfer",
                "other": "Anything else",
            },
        ),
    },
)

intent = response.answers["intent"]
if intent.confidence < 0.6 or intent.choice == "other":
    route_to_support_agent()
elif intent.choice == "check_balance":
    read_balance()                  # low stakes: 0.6 is enough
elif intent.confidence > 0.85:
    approve_transfer()              # high stakes, high confidence
else:
    ask_user_to_confirm_transfer()  # high stakes, moderate confidence
آستانهها از مثال بانکداری صوتی TypeSafe آمدهاند و نقطه شروعاند، نه توصیهای برای داده شما. اصل این است که آستانه با هزینه اقدام اشتباه بالا میرود: درخواست موجودی که اشتباه فهمیده شود جبرانپذیر است، انتقال پولی که اشتباه تأیید شود نه. مقاله ما درباره قرارداد خودداری و پوشش ریسک توضیح میدهد این نقطههای کار را چگونه از نرخ خطای اندازهگیریشده انتخاب کنید.
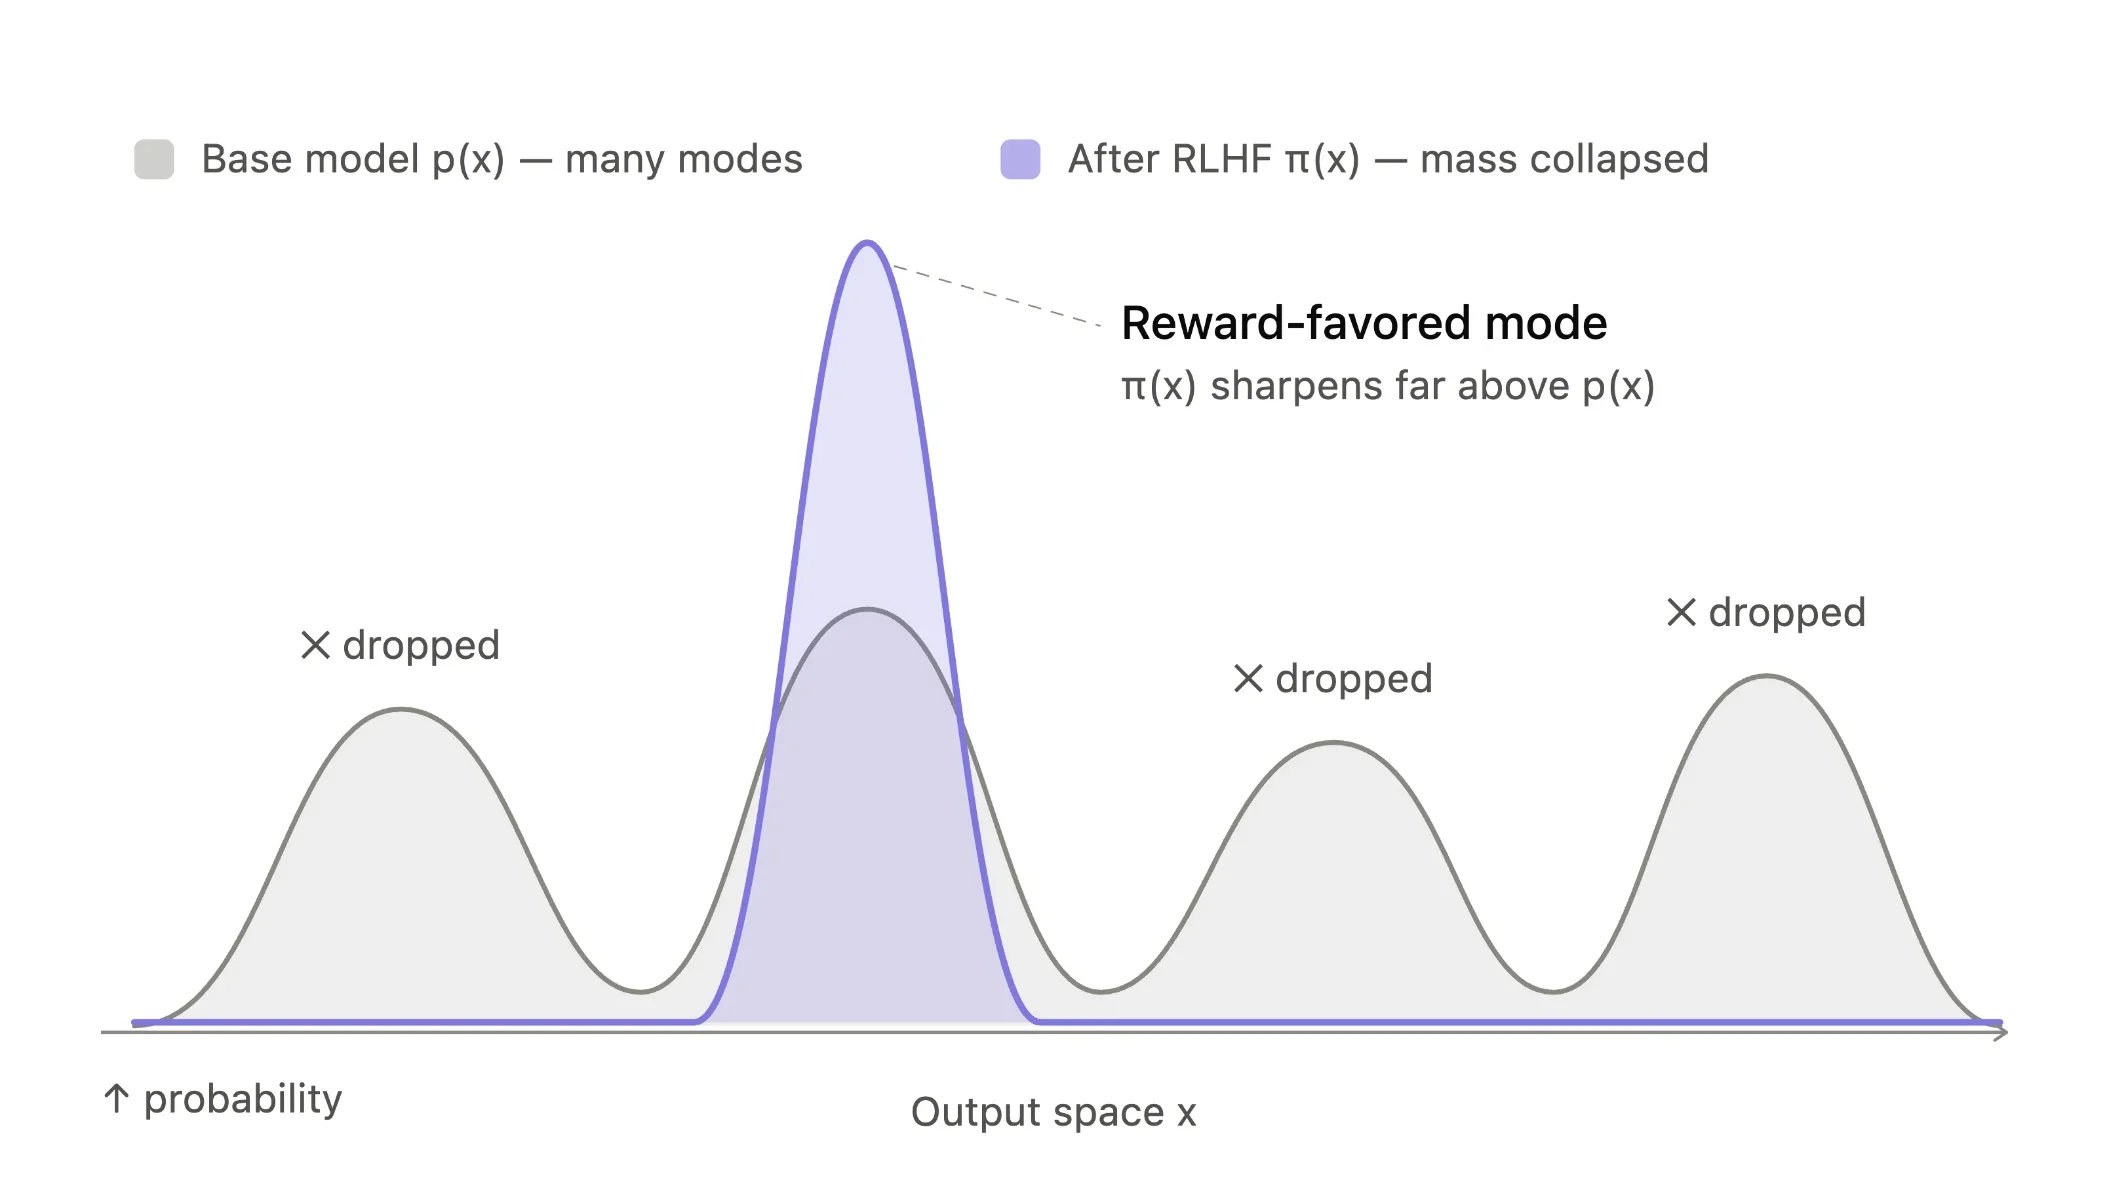 نمودار TypeSafe از باریکشدن توزیع خروجی مدل پایه با RLHF؛ همان «حذف حالتها» که اطمینان خوداظهاری LLM را غیرقابل اتکا میکند.
دلیل TypeSafe برای اعتماد بیشتر به این عددها نسبت به اطمینانی که LLM درباره خودش مینویسد، هدف آموزش است. این شرکت استدلال میکند آموزش ترجیحی توزیع مدل را به سمت پاسخهای مطمئننما و خوشایند باریک میکند، در حالی که RLCD به احتمالهایی پاداش میدهد که با دقت مشاهدهشده جور باشند. این ادعایی است که باید روی داده خودتان بسنجید، نه اینکه فرض بگیرید.
وقتی یک داوری به چند عامل مستقل بستگی دارد، برای هر عامل یک پرسش بپرسید و پاسخها را خودتان ترکیب کنید. مثال غربال رزومه TypeSafe عمق Python، رهبری تیم، طراحی سامانه و گستردگی مهارت را با چهار پرسش Score در یک درخواست میسنجد، هر کدام را به بازه ۰ تا ۱ نرمال میکند و سپس برای هر نقش وزن متفاوتی میگذارد: ۴۰ درصد طراحی و ۴۰ درصد Python برای مهندس ارشد، ۴۰ درصد رهبری برای مدیر مهندسی.
ثمره این کار کنترل است. وقتی رتبهبندی با تصمیم تیم نمیخواند، یک ضریب را عوض میکنید نه یک prompt را، و دقیقاً میبینید کدام بُعد هر نتیجه را رقم زده است. احتمالها میتوانند ورودی یک مدل کلاسیک هم باشند: یکی از نمونههای آموزشی پاسخهای Jev را ویژگی یک رگرسور تقویت گرادیانی میکند.
سرعت و قیمت Jev آن را برای مرحله نخست طبیعی میکند. در الگوی مسیریابی نیت، Jev هر پیام مشتری و پیچیدگی آن را در یک فراخوانی طبقهبندی میکند و بعد کد پرسشهای وضعیت سفارش را به جستوجوی قطعی، پرسشهای محصول و مرجوعی را به LLMهای تخصصی و شکایتهای پیچیده یا موارد کماطمینان را به انسان میسپارد. منابع گران فقط وقتی لازم است به کار میافتند. راهنمای ما درباره مسیریابی بر اساس هزینه و کیفیت توضیح میدهد چگونه بسنجید چنین آبشاری واقعاً صرفهجویی میکند یا نه.
چند نمونه آموزشی دیگر همین ایده را در حوزههای دیگر نشان میدهند. یک خط حفاظتی هر پیام ورودی و خروجی یک برنامه LLM را با پرسشهای Noul برای خطرهای مشخص و یک Score برای شدت آسیب غربال میکند و با آستانه تصمیم میگیرد پیام عبور کند، بازبینی شود، مسدود شود یا به پشتیبانی برود. یک نمونه رتبهبندی دوباره، فهرستهای کوتاه ۳۰ متنی حاصل از جستوجوی کلیدواژهای را برای ۴۰ پرسش حقوقی میگیرد و برای هر جفت پرسش و متن یک سؤال میپرسد؛ نتیجه، رساندن دقت رتبه اول از ۵ به ۱۸ درصد و دقت دهتای اول از ۳۸ به ۶۲ درصد است. یک آبشار استخراج داده ساختاریافته هم مدل کوچک را برای استخراج، Jev را برای راستیآزمایی و مدل استدلالی را فقط برای مواردی که راستیآزمایی را رد میکنند به کار میگیرد.
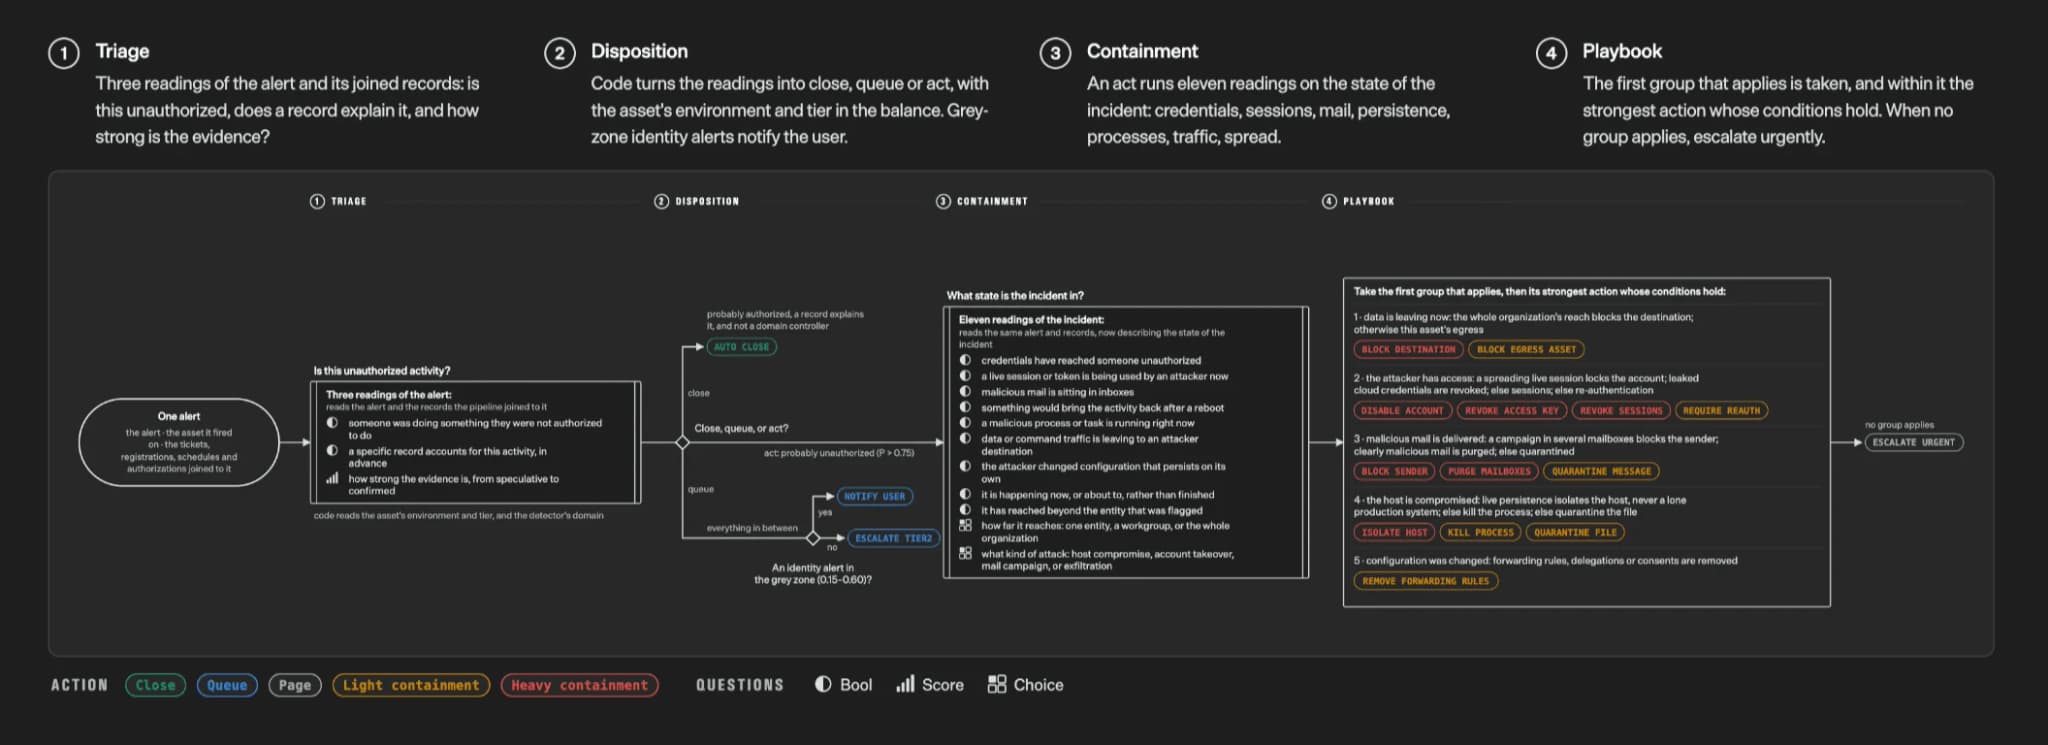 گردشکار حادثه امنیتی TypeSafe: سه خوانش برای تفکیک، تصمیم مبتنی بر کد، یازده خوانش مهار و دستورالعملی که قویترین اقدامِ دارای شرایط را برمیگزیند.
گردشکار حادثه امنیتی از ارزیابی انتشار TypeSafe شکل کامل را نشان میدهد: سه خوانش تعیین میکند آیا هشدار یک فعالیت غیرمجاز است، کد آنها را به بستن، صف یا اقدام تبدیل میکند، یازده خوانش دیگر حادثه را توصیف میکند و دستورالعملی که در کد نوشته شده پاسخ را برمیگزیند. مدل هرگز خودش اقدام را انتخاب نمیکند؛ فقط واقعیتهایی را فراهم میکند که سیاست به آنها نیاز دارد.
صفحه ناهمواریهای Jev 1.13 سودمندترین سند برای مهندس است، چون میگوید مدل کجا میشکند.
| حالت شکست | چه رخ میدهد | پاسخ طراحی |
|---|---|---|
| خوانش تحتاللفظی | به کلمهها پاسخ میدهد نه به منظور | شرط دقیق را بنویسید؛ موارد مرزی را در criteria بگذارید |
| حساب و شمارش | محاسبه و شمارش قابل اتکا نیست | در کد حساب کنید؛ برای هر مورد یک پرسش بپرسید و جمع بزنید |
| تاریخ | تاریخ را متن میبیند | اجزا را با Choice استخراج و در کد مقایسه کنید |
| غیرمستقیمگویی | پرسش چندمرحلهای دقت را کم میکند | فیلد مربوط را نام ببرید؛ گامها را کم کنید |
| وضعیت نامربوط | عوامل حواسپرتی دقت را پایین میآورند | پیش از فراخوانی پالایش کنید؛ با Noul غربال کنید |
| محتوای خصمانه | متن تزریقشده میتواند پاسخ را جابهجا کند | criteria دقیق؛ پیش از انتشار ورودی خصمانه را بیازمایید |
| عبارتبندی متناقض | دستور و criteria با هم نمیخوانند | criteria را ادامه دستور قرار دهید |
| ثابتهای ساختاری | پرسشهای مرتبط لزوماً همخوان نیستند | هر تصمیم را فقط به یک شکل بپرسید |
| تولید متن | برای نوشتن متن آموزش ندیده است | از مدل مولد استفاده کنید و بگذارید Jev از میان نامزدها انتخاب کند |
زبان هم به این فهرست تعلق دارد. مستندات مدل میگوید زبان اصلی آموزش انگلیسی است و زبانهای دیگر پذیرفته میشوند «ولی به همان خوبی نه»؛ از خطهای چینی، ژاپنی و کرهای نام میبرد و درباره فارسی چیزی نمیگوید.
TypeSafe هیچ امتیاز بنچمارک عمومی منتشر نمیکند و از کاربران میخواهد ارزیابی خودشان را بسازند؛ توصیهای درست برای هر مدلی. یک برنامه حداقلی چهار گام دارد.
نخست، برای هر پرسش چند صد ورودی واقعی را با پاسخی که تیم میپذیرد برچسب بزنید و موارد دشوار و خصمانه را هم بگنجانید. دوم، دقت و واسنجی را بسنجید: پاسخها را بر اساس احتمال گزارششده گروهبندی کنید و بررسی کنید دقت مشاهدهشده هر گروه به احتمالش نزدیک باشد. سوم، آستانهها را از موازنه اندازهگیریشده میان سهم موارد خودکار و نرخ خطای همان موارد انتخاب کنید. چهارم، نسخه مدل را ثابت کنید، فیلد model و اطمینان هر پاسخ را ثبت کنید و پیش از رفتن به نسخه تازه ارزیابی را دوباره اجرا کنید.
برای تصمیمهایی که تیم به آنها تکیه میکند، پس از انتشار هم نمونهای از تصمیمهای خودکار را زیر بازبینی انسانی نگه دارید. واسنجیای که روی داده ماه گذشته سنجیده شده، واسنجی روی ورودیهای ماه آینده را تضمین نمیکند.
قرارداد مشتری TypeSafe از مشتریان میخواهد در کشورهای تحت تحریم آمریکا مستقر یا تبعه آنها نباشند و این تیمهای ساکن ایران را کنار میگذارد. اما معماری به Jev وابسته نیست و بیشترش به مدلهایی منتقل میشود که تیم مجاز به استفاده از آنهاست.
جریان کنترل، حساب و تاریخ را در کد نگه دارید. هر داوری را به پرسشهای باریک با پاسخهای شمارششده بشکنید و نوع پاسخ را در مرز سامانه اعمال کنید، همانطور که راهنمای ما درباره اعتبارسنجی خروجی ساختاریافته با قرارداد شرح میدهد. جایی که مدل احتمال توکنها را در اختیار میگذارد، از آن بهعنوان امتیاز خام استفاده کنید و روی داده برچسبخورده واسنجیاش کنید، بهجای اعتماد به عددی که مدل در متن مینویسد. برای پرسشهای پرحجم و پایدار، یک طبقهبند کوچک تنظیمشده با خروجی واسنجیشده اغلب از هر مدل میزبانیشدهای ارزانتر است. و هر اقدام پیامددار را پشت آستانه اطمینان اندازهگیریشدهای بگذارید که یک انسان یا مدلی قویتر پشتش باشد.
آنچه بدون Jev از دست میدهید، تضمین همخوانی همیشگی پاسخ با طرح، ارزیابی موازی پرسشهای زیاد با یک قیمت و سرعت است. آنچه نگه میدارید همان بخشی است که سامانه را قابل اتکا میکند: تصمیمهایی آنقدر کوچک که آزمونپذیر باشند، و کدی که تصمیم میگیرد وقتی مدل مطمئن نیست چه باید کرد.
چگونه از سیاست، وضعیت کار، شواهد، حافظه و ابزار، کوچکترین زمینه قابل اعتماد را بسازیم و آن را در برابر تعارض، نویز و حمله بسنجیم.
ادامه مطلب
هوش مصنوعی ممکن است همه رقمها را درست بخواند و معنای جدول را گم کند. پیش از پذیرش گزارش، رابطه هر عدد با سرستون، واحد و یادداشت مربوط به آن را بررسی کنید.
ادامه مطلب
دستیار ممکن است پیش از پایان جستوجو هیچ نتیجهای نبیند. دامنه، صفحههای باقیمانده، خطاهای جزئی و زمان داده را بررسی کنید تا پاسخ منفی، پرونده را زود نبندد.
ادامه مطلباگر این مطلب به یک سامانه واقعی در سازمان شما مربوط است، از خدمات و مطالعه موردی شروع کنید.