فناوری هوش مصنوعی
کارت سیستم Claude Opus 5.5؛ ریسک، سایبر، همسویی و رفاه مدل
خوانش بخشبهبخش کارت سیستم ۲۳۰ صفحهای Opus 5.5؛ آستانههای زیستی و پژوهش هوش مصنوعی، ارزیابی سایبری، تزریق prompt، ممیزی همسویی، رفاه مدل و بنچمارکها.
ادامه مطلبJev بهجای نوشتن متن، پاسخ نوعدار با احتمال واسنجیشده برمیگرداند. نخستین مدل System One شرکت TypeSafe چه میکند، شواهد انتشارش چه میگوید و کجا کم میآورد.
شرکت TypeSafe AI در ۲۴ شهریور ۱۴۰۵ (۱۵ سپتامبر ۲۰۲۶) دسترسی زودهنگام به Jev، نخستین مدل عمومی خود، را باز کرد و طبق گزارش رسانهها در ۲۹ شهریور فهرست انتظار را برداشت. Jev چتبات نیست و رقیب تازه ChatGPT هم نیست. هرگز جملهای نمینویسد. شما مجموعهای از اطلاعات و فهرستی از پرسشهای نوعدار به آن میدهید و یکی از این سه را پس میگیرید: گزینهای از میان گزینههایی که خودتان تعریف کردهاید، امتیازی روی مقیاسی که خودتان ساختهاید، یا احتمال درستبودن یک جمله؛ هر کدام همراه با معیاری از میزان اطمینان مدل.
TypeSafe این را ردهای تازه به نام مدل System One مینامد و نوشته معرفیاش ادعاهای بزرگی دارد: تا ۲۰۰ برابر سریعتر و صدها برابر ارزانتر از مدلهای زبانی مرزی، و ناتوان از خطای نوع. خلاصه منصفانه شواهد خود TypeSafe محدودتر است: Jev در گردشکارهای منتشرشده، دقتی تقریباً همسطح مدلهای مرزی میانه دارد، با کسری کوچک از هزینه و زمان پاسخ آنها. دقیقتر از بهترین مدلها نیست.
مدلهای زبانی بزرگ (LLM) آموزش دیدهاند متنی بنویسند که آدمها از خواندنش راضی باشند. همین آنها را دستیارهای عالی کرد. اما بیشتر نرمافزارها به یک بند متن نیاز ندارند؛ به تصمیمی نیاز دارند که بشود بر اساسش عمل کرد: این تیکت به کدام تیم برود، آیا این فاکتور تکراری است، آیا این پیام درخواست بازپرداخت است. امروز برنامهنویس از LLM خروجی JSON میخواهد، پاسخ را تجزیه و اعتبارسنجی میکند و باید برای وقتی که مدل چیز دیگری برگرداند هم چارهای داشته باشد.
استدلال TypeSafe که در بیانیهاش آمده این است که این شکل برای خودکارسازی مناسب نیست. نرمافزار از قطعههای کوچک و آزمونپذیر با شاخههای قابل حسابرسی ساخته میشود. این شرکت میخواهد جزء هوش مصنوعی هم مثل یکی از همین قطعهها رفتار کند: سریع، ارزان، محدود و صادق درباره عدم قطعیت. TypeSafe هدف را در یک عبارت خلاصه میکند: «شرطهای هوشمند»؛ کدی معمولی که همانقدر راحت که روی عدد شاخه میزند، روی فهم و نیت هم شاخه بزند.
«System One» از کتاب تفکر، سریع و کند دانیل کانمن گرفته شده که میان داوری سریع و شهودی «سیستم ۱» و استدلال آهسته و سنجیده «سیستم ۲» فرق میگذارد. Jev برای نوع نخست ساخته شده است: داوری فوریای که یک فرد آگاه با زمینه درست در یکی دو ثانیه انجام میدهد. استدلال طولانی و چندمرحلهای صراحتاً بیرون از دامنه آن است.
«Jev» به نام ویلیام استنلی جوونز، اقتصاددان، است که دید کارآمدترشدن موتور بخار مصرف کل زغالسنگ را کم نکرد، بلکه بیشتر کرد. شرط TypeSafe برای هوش هم همین است: هر بار که هزینه یک تصمیم ده برابر ارزانتر شود، کاربردهای تازهای بیش از آنچه جایگزین میشود پدید میآید.
هر درخواست دو بخش دارد. وضعیت (state) همان چیزی است که باید داوری شود، مثل پیام مشتری، سابقه سفارش و سیاست بازپرداخت، که بهصورت متن یا یک شیء JSON فرستاده میشود. پرسشها داوریهاییاند که میخواهید، هر کدام با نوع و پاسخهای مجاز. Jev همه پرسشها را همزمان و موازی درباره همان وضعیت ارزیابی میکند و پاسخ ساختاریافته برمیگرداند؛ متنی برای تجزیه در کار نیست.
نمونه آغاز سریع خود TypeSafe یک پیام پشتیبانی درباره خرابشدن اتصال Stripe میفرستد و سه پرسش را با هم میپرسد. پاسخ به شکل داده برمیگردد: تیکت با احتمال ۰٫۸۵ مربوط به تیم technical است (تیم مالی ۰٫۱۵) و اطمینان ۰٫۷۸ دارد؛ میزان عصبانیت روی مقیاسی سهسطحی از آرام تا بسیار خشمگین، سطح ۱ میگیرد؛ و احتمال فوریبودن پیام ۱٫۰ داوری میشود. کد میتواند بیدرنگ روی همین مقدارها شاخه بزند.
چون پرسشها مستقل و موازی ارزیابی میشوند، افزودن پرسش بیشتر زمان پاسخ را تقریباً تغییر نمیدهد و پرسیدن سؤالی که شاید لازم نشود تقریباً هزینهای ندارد.
| نوع | چه میپرسد | چه برمیگرداند | محدودیت |
|---|---|---|---|
| Choice | کدام گزینه مناسب است؟ | گزینه انتخابشده، احتمال هر گزینه، اطمینان | حداکثر ۲۵۵ گزینه |
| Score | روی این مقیاس کجا قرار میگیرد؟ | جایگاهی میان سطحهای شما، احتمال هر سطح، اطمینان | ۲ تا ۱۰ سطح |
| Noul | آیا این جمله درست است؟ | احتمال «بله»، از ۰ تا ۱ | فیلد اطمینان جداگانه ندارد |
پاسخ همیشه فقط یکی از گزینهها یا سطحهایی است که خودتان دادهاید. هسته وعده «نوعامن» TypeSafe همین است: Jev نمیتواند مقدار بدشکل، دسته ساختگی یا امتناع را بهجای پاسخ برگرداند.
هر پاسخ Choice و Score عددی به نام اطمینان دارد که از میزان تمرکز احتمالها به دست میآید. TypeSafe، Jev را طوری آموزش میدهد که احتمالهایش واسنجیشده باشند: در میان تعداد زیادی پیشبینی، پاسخهایی که احتمال ۸۰ درصد گرفتهاند باید حدود ۸۰ درصد مواقع درست باشند. این ویژگی گروهی از پاسخهاست، نه تضمینی برای یک پاسخ منفرد.
کاربرد عملیاش مسیریابی بر اساس ریسک است. راهنمای اطمینان TypeSafe یک دستیار بانکی را نشان میدهد که هر درخواستی با اطمینان کمتر از ۰٫۵ را به انسان میسپارد، درخواست کمخطری مثل نمایش موجودی را با اطمینان متوسط میپذیرد و با انتقال پول سختگیرانهتر برخورد میکند: بالای ۰٫۹ از مسیر تأیید میگذرد و پایینتر از آن، پیش از هر اقدامی از کاربر میخواهد درخواست را تأیید کند. آستانهها را خودتان تعیین میکنید و باید با هزینه اشتباه فرق کنند. راهنمای ما درباره مسیریابی میان مدلها بر پایه هزینه و کیفیت همین ایده را در سطح کل ردههای مدل به کار میبرد.
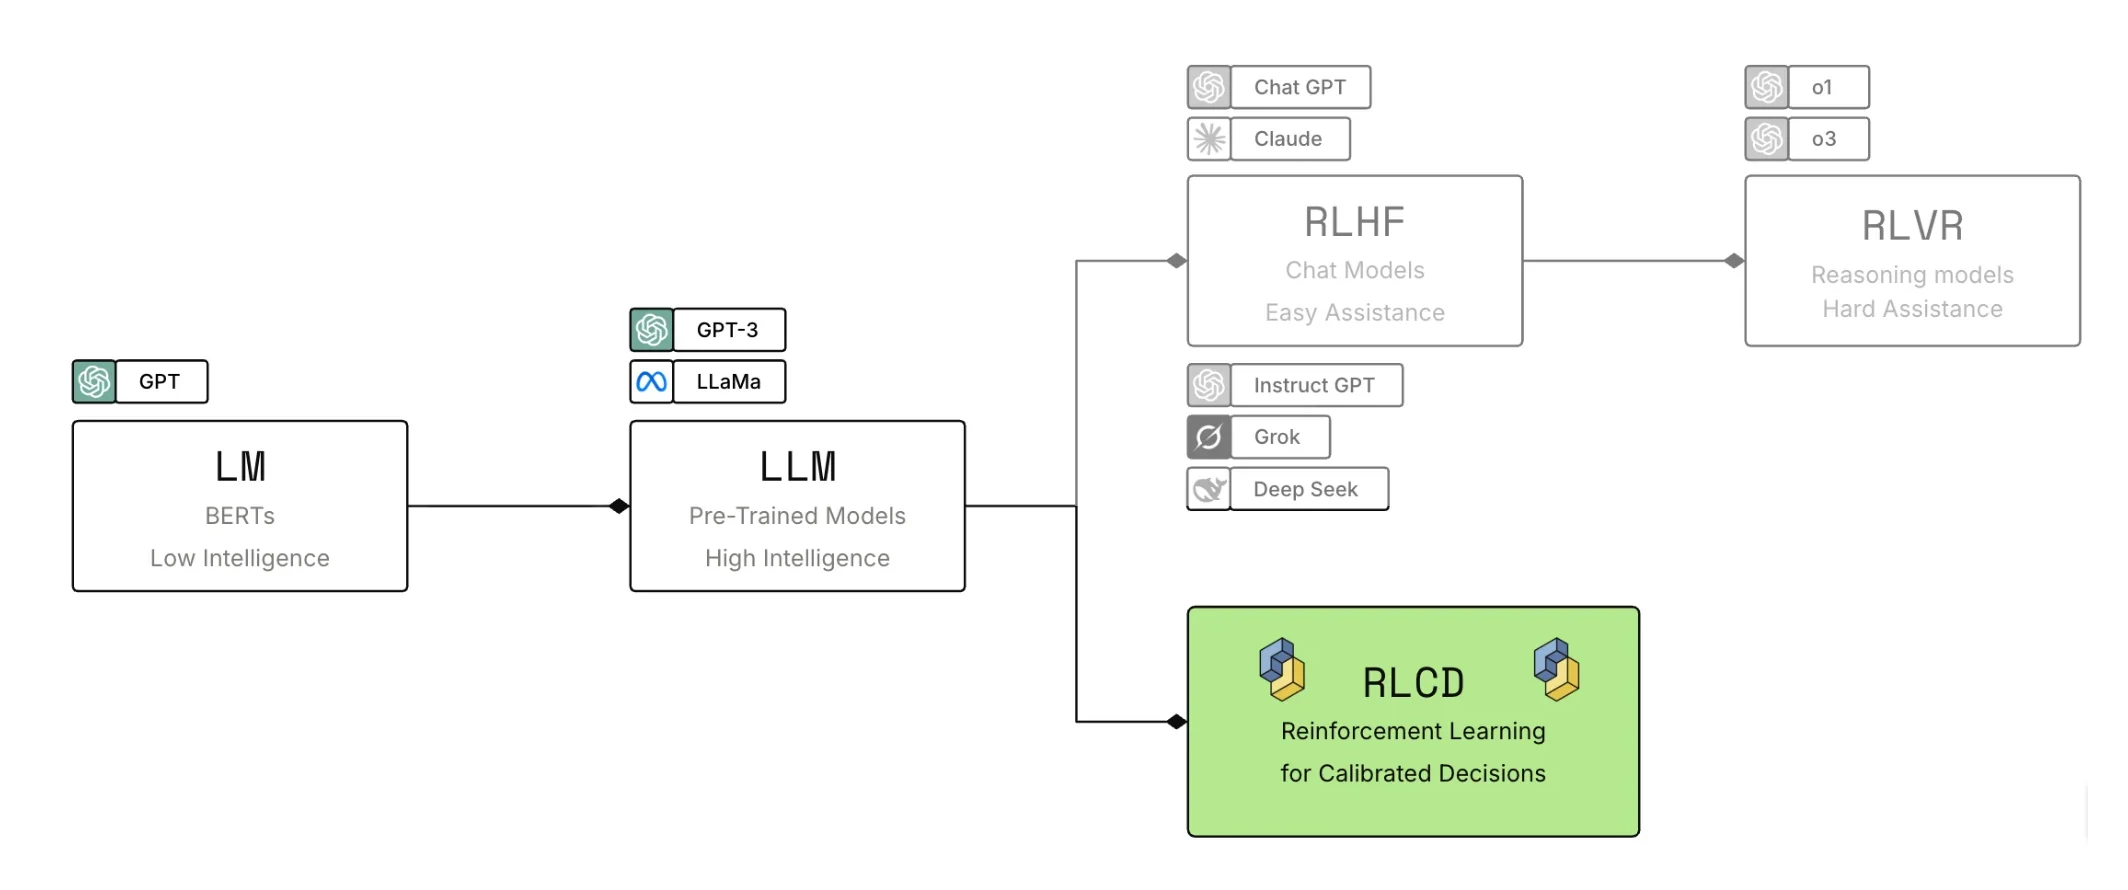 نمودار TypeSafe از مسیرهای پسآموزش: RLHF مدلهای گفتوگو، RLVR مدلهای استدلالی و RLCD مدلهای تصمیم واسنجیشده را ساختهاند.
نمودار دستاول از مستندات TypeSafe. این نمودار روایت TypeSafe از این حوزه است، نه یک تاریخچه مستقل.
دیوگو آلمیدا، مدیرعامل TypeSafe، در OpenAI روی یادگیری تقویتی از بازخورد انسانی (RLHF) کار کرده بود که پشتوانه InstructGPT و ChatGPT شد. این شرکت استدلال میکند RLHF به پاسخهایی پاداش میدهد که آدمها ترجیح میدهند و همین خروجی مطمئننما را تشویق میکند، و آموزش با پاداش قابل راستیآزمایی که پشت مدلهای استدلالی است، برای کارهایی مناسب است که خودکار بررسیپذیرند. راه جایگزین آن، یادگیری تقویتی برای تصمیمهای واسنجیشده (RLCD)، به احتمالهای صادقانه روی تصمیمهای نوعدار پاداش میدهد. TypeSafe از یک معماری تازه و یک نمونهبردار موازی هم نام میبرد که همه پاسخها را در یک گذر امتیاز میدهد، نه توکن به توکن.
خواننده باید حد این شواهد را بداند. TypeSafe نه مقاله فنی منتشر کرده، نه وزنهای مدل و نه اندازه آن را. میگوید همه داده آموزشیاش را خودش میسازد و روی درخواستهای مشتریان آموزش نمیدهد. هیچیک از ادعاهای معماری هنوز از بیرون قابل بررسی نیست.
TypeSafe عمداً هیچ امتیازی روی بنچمارکهای عمومی منتشر نکرده است. بهجای آن ارزیابیهای گردشکار ساخته است: چهار کار واقعی خودکارسازی (هشدارهای امنیتی، بازبینی رد عامل، پردازش فاکتور و خدمات مشتری) که هر کدام به دهها پرسش کوچک و قاعده کد شکسته شدهاند. پاسخ مرجع، میانگین پاسخهای GPT-6 Astra و Claude Fable 5.1 با تفکر زیاد است و هر مدل دیگر همان گردشکار را با تنظیم پیشفرضش اجرا میکند.
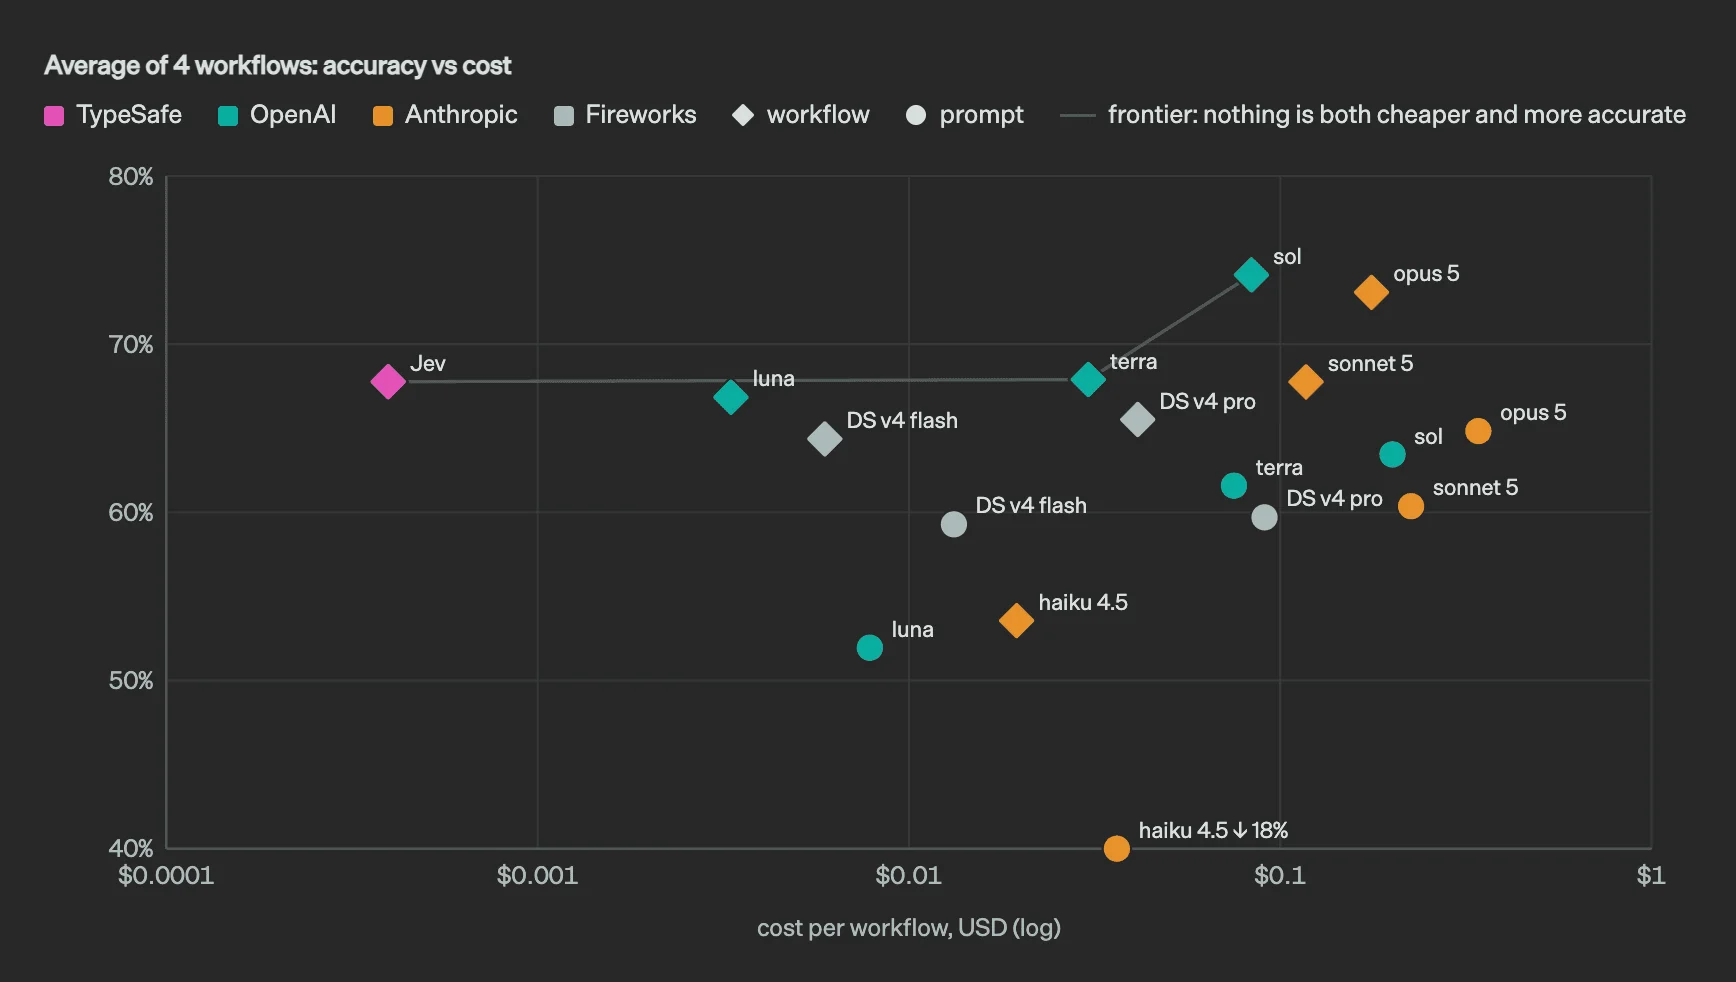 نمودار TypeSafe از دقت در برابر هزینه هر گردشکار، میانگین چهار گردشکار، که Jev را در کمهزینهترین سر محور نشان میدهد.
شاهد دستاول از نوشته معرفی TypeSafe. دقت یعنی میزان همخوانی با پاسخهای مرجع Astra و Fable 5.1 روی گردشکارهای خود TypeSafe.
اگر دقیق بخوانیم، این نمودار چیزی فروتنانهتر از تیترها میگوید. Jev حدود ۶۸ درصد همخوانی دارد؛ تقریباً همسطح GPT-5.6 Luna و Terra و Claude Sonnet 5 روی همان گردشکار، و پایینتر از GPT-5.6 Sol و Claude Opus 5 که حدود ۷۳ تا ۷۴ درصدند. برتریاش هزینه است: بسیار کمتر از یکدهم سنت برای هر گردشکار، در برابر حدود یکسوم سنت برای Luna و دهها سنت برای بزرگترین مدلها. هیچ نقطهای روی نمودار هم ارزانتر و هم دقیقتر از Jev نیست؛ منظور TypeSafe از «مالکیت مرز» همین است.
نمودار درس دومی هم دارد که برای همه مدلها صدق میکند: هر LLM وقتی گردشکار شکستهشده را اجرا کرد امتیاز بهتری گرفت تا وقتی که همان سیاست را یکجا در قالب یک prompt دریافت کرد.
عددهای پرتکرار TypeSafe، یعنی ۱۹۳٫۶ برابر سریعتر و ۴۴۴٫۶ برابر ارزانتر، از همین گردشکارها آمدهاند. خود شرکت میگوید این عددها «در سر بالای سود دنیای واقعی» هستند، گردشکارها را تیم خودش ساخته و استفاده از مدلهای OpenAI و Anthropic بهعنوان مرجع، مقایسه را به نفع همان مدلها کج میکند.
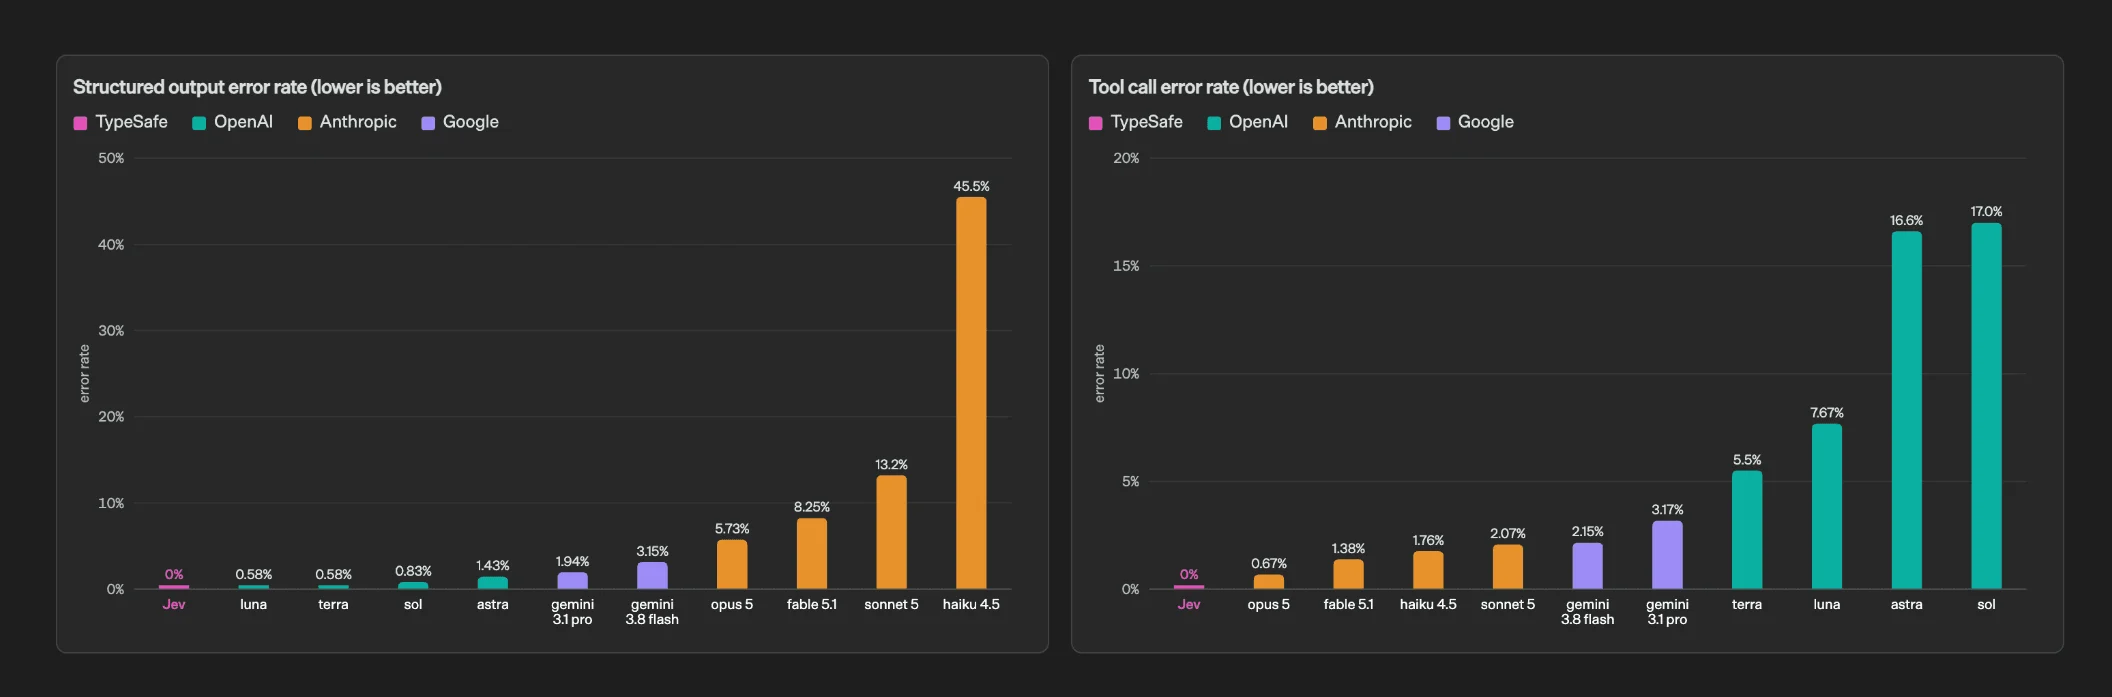 نمودارهای TypeSafe از نرخ خطای خروجی ساختاریافته و فراخوانی ابزار برای چند LLM، که Jev را با صفر درصد نشان میدهد.
نمودار دستاول از نوشته معرفی TypeSafe. نرخ خطای LLMها از ترافیک OpenRouter آمده و TypeSafe میگوید صفر درصد Jev اندازهگیری نیست، بلکه تضمین طراحی آن است.
نسخه دقیق این ادعا این است که Jev نمیتواند خطای نوع داشته باشد. خروجیاش همیشه با طرحی که تعریف کردهاید جور است و نرمافزار هرگز چیزی دریافت نمیکند که نتواند تجزیه کند. این ارزشمند است و TypeSafe یادآوری میکند که فقط یک مثال نقض کافی است تا ادعا رد شود.
اما معنایش این نیست که همه پاسخها درستاند. Jev میتواند گزینه اشتباه را انتخاب کند و فهرست ضعفهای شناختهشده نسخه ۱٫۱۳ که خود TypeSafe منتشر کرده، صریح است: دستورها را بسیار تحتاللفظی میخواند، در حساب، شمارش و مقایسه تاریخ قابل اتکا نیست، وقتی ورودی پر از مطالب نامربوط شود دقتش افت میکند، با غیرمستقیمگویی چندمرحلهای مشکل دارد و متن خصمانهای که در ورودی گذاشته شود میتواند پاسخش را جابهجا کند. عدد اطمینان برای همین است که کد موارد نامطمئن را بگیرد. نشریه آلمانی heise نگرانی منصفانهای هم میافزاید: Jev هیچ توضیحی برای تصمیمهایش نمیدهد و این هرچه سامانههای خودکار تصمیم بیشتری بگیرند، مهمتر میشود.
طبق صفحه مدل، نسخه فعلی jev-1.13.0 است که از راه نام مستعار jev-latest هم در دسترس است.
| مورد | Jev 1.13 |
|---|---|
| قیمت ورودی | ۰٫۰۴۲ دلار برای هر یک میلیون توکن (۴۲ دلار برای یک میلیارد) |
| قیمت خروجی | رایگان |
| زمان پاسخ معمول | ۷۰ تا ۵۰۰ میلیثانیه، اندازهگرفته از مقر TypeSafe در ساحل غربی آمریکا |
| زمینه | ۶۴ هزار توکن در هر درخواست؛ ۳۲ هزار برای وضعیت بهاضافه طولانیترین پرسش |
| سقف درخواست | ۲۵۰ هزار توکن در ثانیه و ۱٬۲۰۰ درخواست در دقیقه، متغیر با تقاضا |
| ورودی | فقط متن: رشته، شیء JSON یا آرایهای از متن |
| سفارشیسازی | بدون تنظیم دقیق؛ همان وزنها به همه حسابها خدمت میدهند |
برای مقایسه، Claude Opus 5.5 برای هر یک میلیون توکن ورودی ۴ دلار میگیرد، یعنی حدود ۹۵ برابر Jev، و Claude Fable 5.1 ده دلار. TypeSafe آشکارا میگوید نمیتواند ثابت کند قیمتهایش یارانهای نیست، هرچند انتظار دارد قیمت پایینتر هم بیاید.
TypeSafe سال ۲۰۲۴ در سانفرانسیسکو به دست دیوگو آلمیدا، اریک گافنی و ساشا شنگ بنیان گذاشته شد و دو سال در حالت پنهان کار کرد. همزمان با انتشار، جذب ۴۰ میلیون دلار سرمایه بذری به رهبری DCVC را اعلام کرد. گزارش TechCrunch میگوید تقاضا برای مدتی کوتاه از توان API بیشتر شد، Vercel از Jev برای طبقهبندهای بازبینی ایمنی استفاده میکند و آن را ۵ تا ۱۸ برابر سریعتر از GPT-5.6 Luna و با دقت بهتر یافته است، و استارتاپ Bryo AI آن را برای طبقهبندی ایمیل ۱۰ تا ۲۰ برابر ارزانتر از Gemini دیده است. اینها نتیجههای اولیه و خوداظهاری کاربران نخستیناند، نه ارزیابی مستقل.
دو واقعیت مقدم است. صفحه مدل میگوید زبان اصلی آموزش Jev انگلیسی است و زبانهای دیگر «پذیرفته میشوند ولی به همان خوبی نه»؛ TypeSafe از خطهای چینی، ژاپنی و کرهای نام میبرد و درباره فارسی چیزی منتشر نکرده است. هر کار فارسی پیش از اتکا به مجموعه آزمون مخصوص خودش نیاز دارد.
دوم، قرارداد اصلی مشتری TypeSafe در بند ۱۶٫۱۲ از هر مشتری میخواهد اعلام کند که در کشوری تحت تحریم دولت آمریکا مستقر نیست و تبعه چنین کشوری هم نیست. طبق این شرایط، شرکتها و افراد مستقر در ایران نمیتوانند از این سرویس استفاده کنند.
با این حال ایدهها ارزش بهکارگیری دارند. شکستن یک داوری مبهم کسبوکار به پرسشهای کوچک نوعدار، نگهداشتن حساب و منطق کنترل در کد و عملکردن فقط وقتی اطمینان از آستانهای متناسب با ریسک بگذرد، تصمیمهای طراحیاند که با هر مدلی که تیم مجاز به استفاده از آن است کار میکنند. راهنمای ما درباره اعتبارسنجی خروجی ساختاریافته هوش مصنوعی با قرارداد توضیح میدهد وقتی خود مدل نوع را تضمین نمیکند چگونه آن را اعمال کنید، و راهنمای برنامهنویسی الگوهای طراحی Jev کل این معماری را گامبهگام شرح میدهد.
Jev واقعاً نوع دیگری از محصول هوش مصنوعی است: موتوری برای تصمیم با شکل خروجی تضمینشده، احتمالهای واسنجیشده و قیمتی آنقدر پایین که میشود یک داوری هوش مصنوعی را در هر شاخه برنامه گذاشت. شواهد انتشار، روایت سرعت و هزینه را قوی و روایت دقت را در حد متوسط پشتیبانی میکند: کیفیت مرزی میانه، نه رده اول.
جایگزین مدل گفتوگو، دستیار کدنویسی یا مدل استدلالی نیست و تصمیمهایش را توضیح نمیدهد. بهترین کاربردش صافی یا مسیریاب سریع اولیه در سامانهای است که منطق در دست کد است و موارد نامطمئن به انسان یا مدلی قویتر سپرده میشوند. برای خواننده ایرانی، خود مدل طبق شرایطش در دسترس نیست؛ معماریاش اما هست.
خوانش بخشبهبخش کارت سیستم ۲۳۰ صفحهای Opus 5.5؛ آستانههای زیستی و پژوهش هوش مصنوعی، ارزیابی سایبری، تزریق prompt، ممیزی همسویی، رفاه مدل و بنچمارکها.
ادامه مطلب
دیپسیک در ۱۰ سپتامبر مدل تازه خود را با بینایی بومی و هزینه کمتر معرفی کرد؛ بررسی نتایج، قیمت API و تغییر مهم مسیر درخواستها در ۱۴ سپتامبر.
ادامه مطلب
استرا با پیشرفت در کار علمی و استفاده از رایانه، قابلیتهای تازه برای عاملها و قیمت بالاتر معرفی شد؛ بررسی شواهد و راهنمای عملی ارزیابی این مدل.
ادامه مطلباگر این مطلب به یک سامانه واقعی در سازمان شما مربوط است، از خدمات و مطالعه موردی شروع کنید.