فناوری هوش مصنوعی
کلود سونت ۵٫۵؛ چه چیزی بهتر شده و چه وقت اوپوس را انتخاب کنیم؟
قیمت خواندن حافظه نهان سونت ۵٫۵ در ۷ اکتبر کاهش یافت. هزینه کار، شواهد بازبینی کد، تغییرات API و موارد انتخاب اوپوس ۵٫۵ را بررسی میکنیم.
ادامه مطلب
گنجور حالا زیر تقریباً همه بیتهایش معنی تازهای به فارسی امروز دارد. ماجرای کار را از انتخاب مدل تا هزینه و نتیجه بخوانید، و اینکه کدام معنیها را هنوز باید با احتیاط خواند.
پژوهش ژرف۲۹ آبان ۱۴۰۵۱۹ دقیقهمنبع: آرمان جعفرنژاد
گنجور از این هفته زیر تقریباً همه بیتهایش معنی تازهای دارد. حدود ۱٫۶ میلیون بیت از ۲۴۵ شاعر، از رودکی تا شهریار، حالا معنیای به فارسی امروز دارند که مدل Claude Opus 5.5 نوشته است. این کار را آرمان جعفرنژاد انجام داد؛ همان که پیشتر «گنجورجور» را ساخته بود، موتور جستجویی که شعرهای گنجور را از روی معنا پیدا میکند. این فکر شب ۱۸ آبان ۱۴۰۵، وقتی خوابش نمیبرد، به سرش زد و ۲۵ آبان همه معنیها آماده بود. سه روز بعد حمیدرضا محمدی، سازنده گنجور، تغییرات را بررسی کرد و به دادههای گنجور اضافه کرد و ۲۹ آبان در وبلاگ گنجور خبر داد که معنیهای تازه روی خود سایت هم آمده است.
ژرف یکی از دو حامی این کار بود: کردیت مصرف مدلها را ژرف و mana.space دادند و بخشی از هزینه را هم خود آرمان داد. آرمان ماجرای کار را در وبلاگش نوشته و جزئیات فنیاش را در توضیحاتی آورده که همراه تغییراتش در گیتهاب برای گنجور فرستاد.
آذر ۱۴۰۳ گنجور برای همه بیتها و شعرهایی که آن موقع داشت معنی و خلاصه ماشینی گذاشت. هزینهاش را با اعتباری داد که از طرح حمایتی یک شرکت ایرانی هوش مصنوعی گرفته بود. محمدی در جواب یکی از خوانندهها گفته است که بیشتر این متنها را GPT-4o mini نوشته و بعضی را GPT-4o. هنوز هم فقط حدود ۱٫۵ درصد بیتها معنیای دارند که کاربران گنجور نوشتهاند.
محمدی همان موقع توضیح داد که چرا در ابتدای همه متنهای ماشینی عبارت «هوش مصنوعی:» آمده است: تا اگر روزی مدل بهتری در دسترس بود، بشود همین متنها را پیدا کرد و عوض کرد. و حالا همان روز رسیده است. آرمان کارش را روی دادههای گنجور به تاریخ ۱۷ آبان انجام داده و به گفته خودش، عددها اینهاست:
| تعداد | |
|---|---|
| معنی بیت که جای معنی ماشینی قبلی را گرفت | ۱٬۵۰۰٬۸۶۳ |
| معنی بیت برای بیتی که پیشتر معنی نداشت | ۸۶٬۸۴۶ |
| معنی بیتی که کاربران نوشته بودند و دست نخورد | ۲۴٬۶۷۸ |
| خلاصه شعر که جای خلاصه ماشینی قبلی را گرفت | ۱۲۸٬۴۴۲ |
| خلاصه شعر برای شعری که پیشتر خلاصه نداشت | ۶۴۵ |
| خلاصهای که کاربران نوشته بودند و دست نخورد | ۱٬۶۷۷ |
برای عوض کردن متنها سه قاعده رعایت شد. متن تازه فقط جای متنی را گرفت که با «هوش مصنوعی:» شروع میشد. هر متنی که کسی نوشته یا ویرایش کرده بود، همانطور ماند. متنهای تازه هم با همان «هوش مصنوعی:» شروع میشوند تا خواننده بداند کدام را ماشین نوشته است. یک استثنا هم بود: در بخشهای بلندی مثل بخشهای شاهنامه، معنی بیتها عوض شد ولی خلاصه نه. این بخشها تکهتکه به مدل داده شدند و برای کل بخش خلاصه تازهای نوشته نشد، پس خلاصه قبلی سر جایش ماند. کل کار حدود ۵۶۶ میلیون توکن مصرف کرد.
آرمان اسم این کار را «بزرگترین شرح در تاریخ شعر فارسی» گذاشته است و آن را با کار سودی مقایسه میکند. سودی حدود ۴۳۰ سال پیش، در ۱۵۹۴ میلادی، در استانبول دیوان حافظ را بیت به بیت شرح داد. به گفته آرمان، شارحان همیشه سراغ پنج شاعر بزرگ رفتهاند: حافظ، مولوی، سعدی، فردوسی و نظامی. آنطور که او شمرده، هیچکدام از ۱۲٬۳۱۲ بیت واقف لاهوری در گنجور تا این ماه حتی معنی ماشینی هم نداشت.
معنیهای ماشینی از همان اول منتقد زیاد داشت. به نظر خیلی از خوانندهها کیفیتشان پایین بود و بعضیشان خندهدار. معروفترین نمونه بیتی از داستان اسکندر در شاهنامه است:
دلارای برداشت چندان جهیزکه شد در جهان روی بازار تیز
دلارای اسم مادر روشنک است. مدل در این اسم «دلار» را دیده بود و نوشته بود ارزش دلار در دنیا آنقدر بالا رفته که در بازار به سرعت خرید و فروش میشود. این معنی در توییتر سوژه شوخی شد. فردوسی چیز دیگری میگوید: جهیزیه روشنک آنقدر زیاد بود که بازارهای دنیا را به جنبوجوش انداخت.
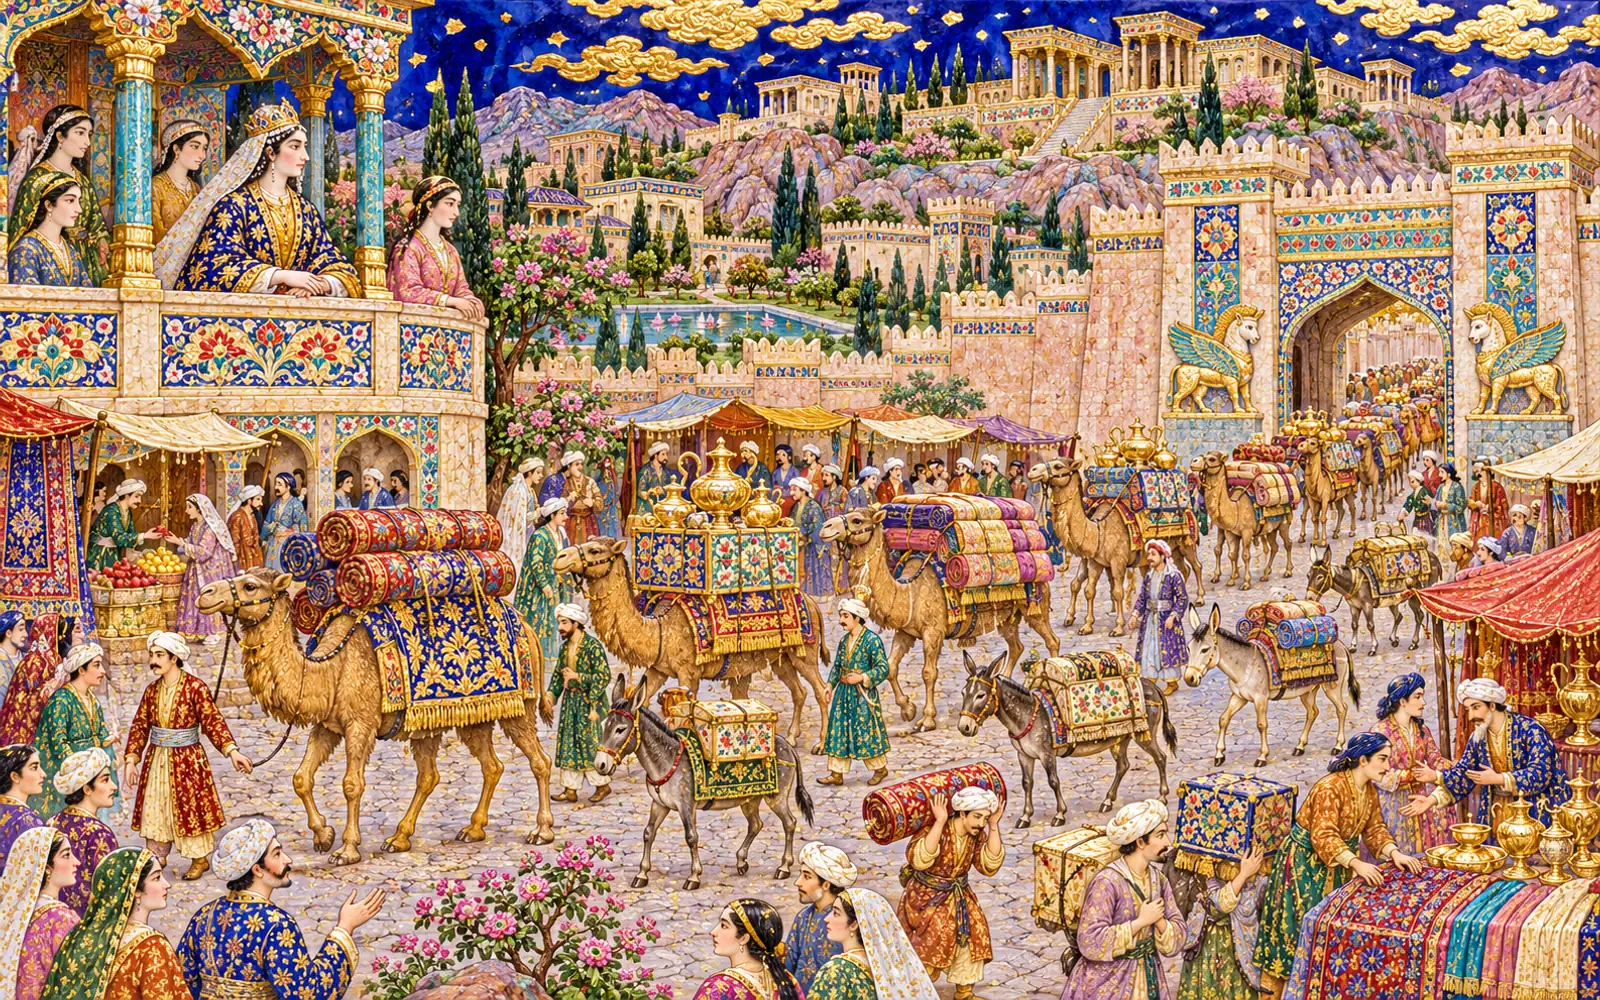 جهیزیه روشنک از دروازه کاخ بیرون میرود و بازار را شلوغ میکند؛ تصویری از همان بیتی که مدل قبلی در آن «دلار» دیده بود. تصویرسازی: ژرف، با هوش مصنوعی.
محمدی فروردین ۱۴۰۴ با لحنی شوخ به این انتقادها جواب داد و راهحلش را هم گفت: معنی غلط را ویرایش کنید، و اگر دیدید معنیای درست است، عبارت «هوش مصنوعی» را از اولش بردارید. اینطور هم معلوم میشود کسی آن را دیده و هم در دور بعدی جایگزینی دست نمیخورد. معنی بیت دلارای هم دیگر برچسب «هوش مصنوعی» ندارد، یعنی کسی آن را ویرایش کرده است، و این بار دست نخورد.
به نظر آرمان، مشکل اصلی ضعف مدل نبود. مدل هر بیت را جدا از بقیه میدید و نمیدانست بیت در کدام داستان است و بیت قبلی چه گفته است. مدلی که بداند این بیت در داستان اسکندر و روشنک است، سراغ دلار نمیرود. البته مدل هم قدیمی بود: GPT-4o پیش از مدلهایی ساخته شده بود که قبل از جواب دادن فکر میکنند.
پیش از اینکه به روش کار برسیم، چهار نمونه را ببینید تا تفاوت معلوم شود. معنیها همان متنی است که گنجور پیش و پس از این کار داشت.
در «لیلی و مجنون» نظامی، پیرمردی به اسم سلیم عامری با نان و لباس به دیدن مجنون میرود و او را در کوه، میان جانوران وحشی، پیدا میکند. نظامی به سلیم میگوید «خال مجنون»، یعنی داییاش. معنی قبلی «خال» را نشانهای بر پیشانی پیرمرد خوانده بود.
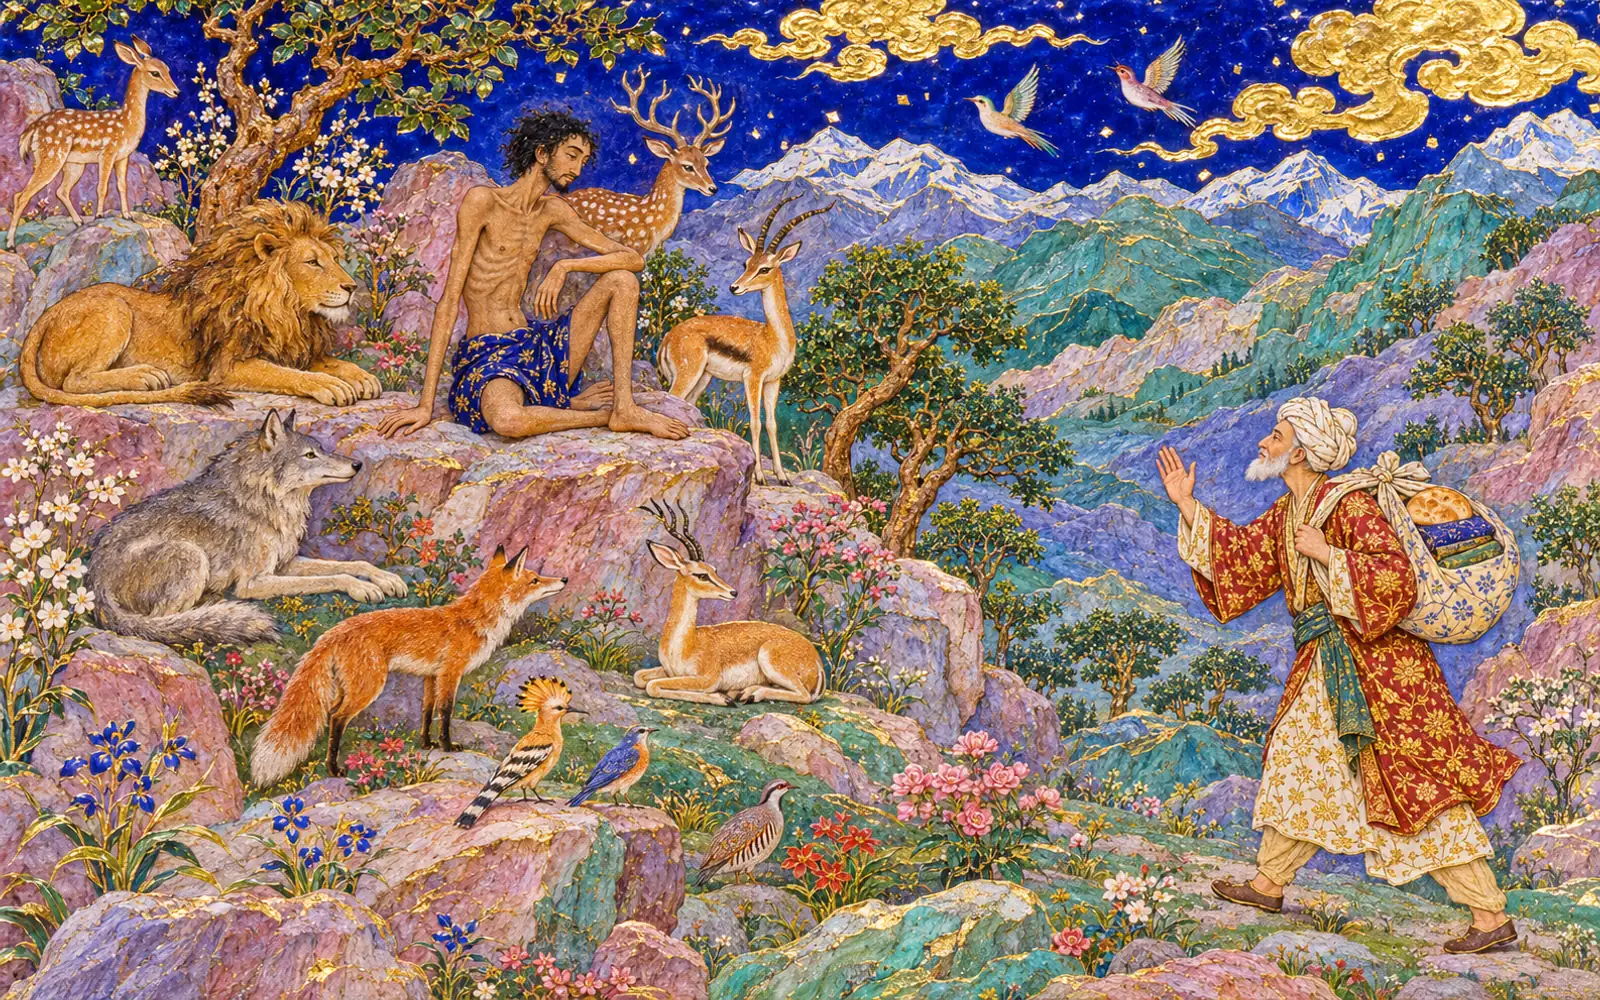 سلیم عامری، دایی مجنون، با بقچهای پر از نان و لباس به سراغ مجنون میرود که میان آهو و شیر و گرگ و روباه نشسته است. تصویرسازی: ژرف، با هوش مصنوعی.
کز نقد کنان حال مجنونپیری سره بود خال مجنون
معنی قبلی در گنجور
معنی تازه
آنکه در بین معاملهکنندگان با اندیشههایی پاک (نقد کنان) به حال مجنون نگریسته، در حقیقت پیر زکات و درستکاری است که نشانهاش (خال مجنون) بر پیشانی اوست.
از میان کسانی که احوال مجنون را میشناختند و از او خبر داشتند، پیرمردی نیک و پاکنهاد بود که دایی مجنون بود.
دوازده بیت بعد، نظامی با همین کلمه بازی میکند. سلیم خودش را اینطور معرفی میکند:
خال تو ولی ز روی تو فردروی تو به خال نیست در خورد
معنی قبلی در گنجور
معنی تازه
خال تو، اما از روی تو جداست و به تنهایی، زیباییات را نمیتواند وصف کند.
با بازی با واژهٔ «خال» میگوید: من خال (دایی) تو هستم، ولی از چهرهٔ تو جدا ماندهام؛ و چهرهٔ تو اکنون دیگر جای خال (نقطهٔ زیبایی) نیست.
در معنی تازه هر دو معنای «خال» آمده است. این بخش را در گنجور میشود از اول خواند.
در «هفت پیکر» نظامی، بهرام گور با کنیزکش فتنه به شکار رفته و دنبال گلهای گورخر میتازد.
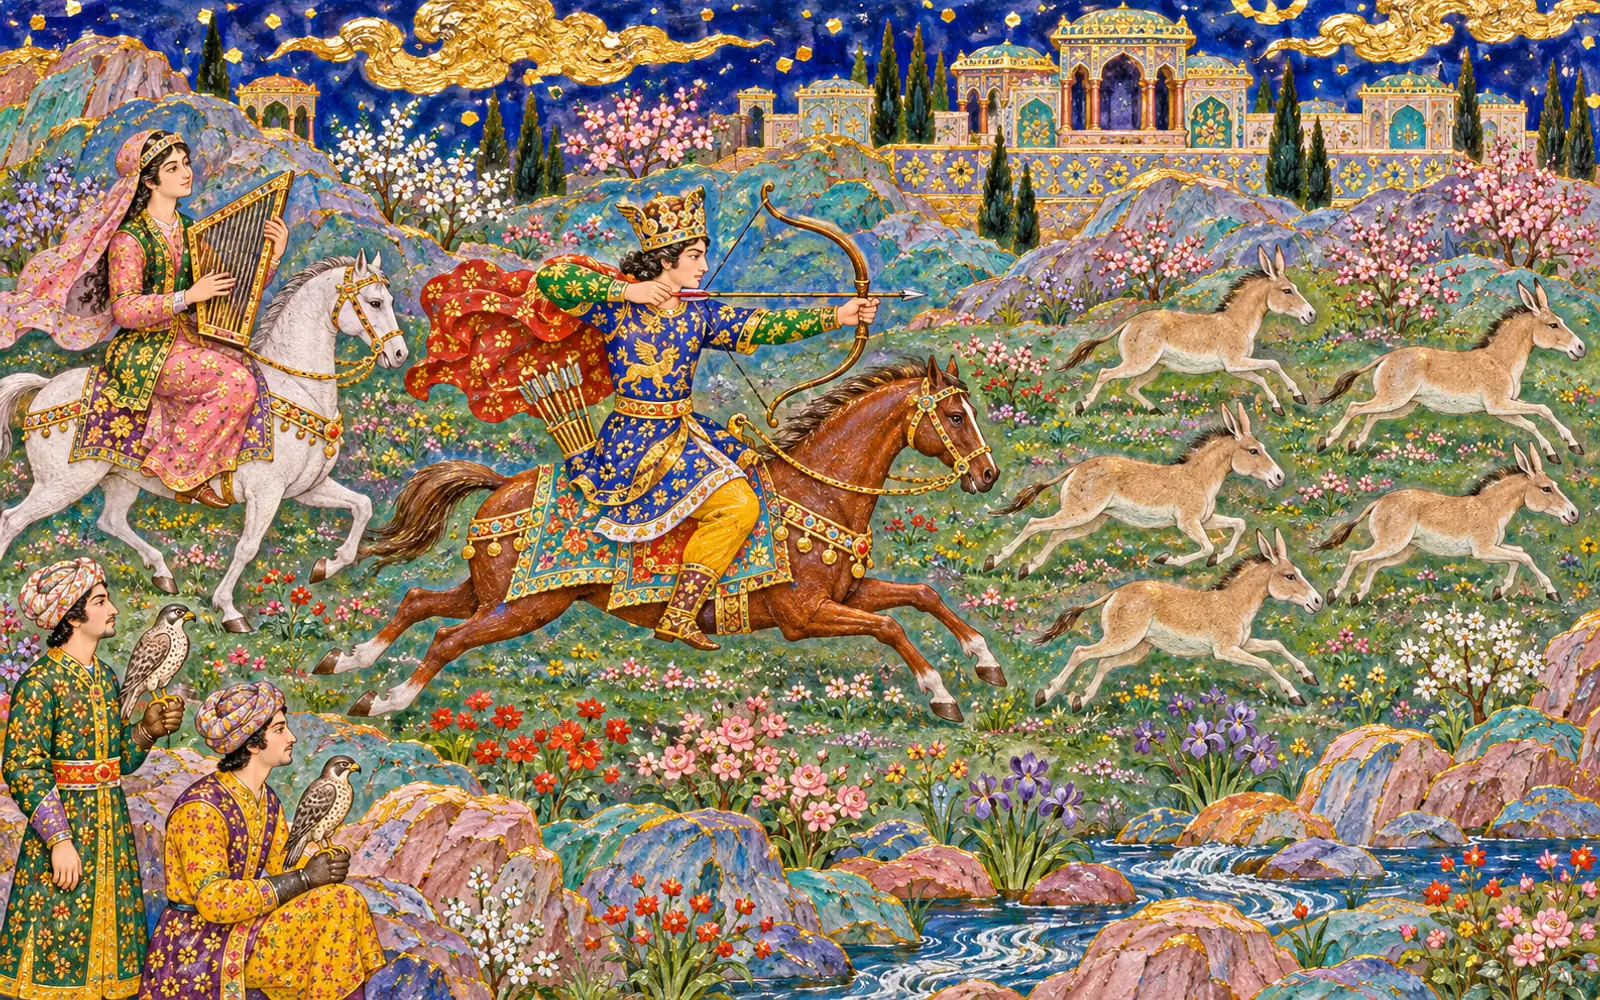 بهرام گور کمانبهدست به دنبال گورخرها میتازد و فتنه، چنگ در دست، تماشا میکند. تصویرسازی: ژرف، با هوش مصنوعی.
چون درآمد به گور تیز آهنگتند شیری کمان گرفته به چنگ
معنی قبلی در گنجور
معنی تازه
وقتی به قبر وارد شد، شیر تند و تیز که کمان را در دست داشت به سرعت به او نزدیک شد.
شاه مانند شیری تند و کمان به دست، با شتاب به سوی گورخرها درآمد.
مدل قبلی «گور» را قبر خوانده بود و «شیر» را جانوری جدا. مدل تازه دیده که گورخرها یک بیت پیشتر در شعر آمدهاند و «شیر» خود بهرام است. معنی تازه الان روی صفحه گنجور است.
منوچهری در مسمطی درباره پاییز، باغ را اینطور توصیف میکند: دهقان از تعجب انگشت به دندان گرفته که نه گلی مانده و نه گلناری، و میوهها یکییکی جلوه میکنند. در بیت قبلی، معنی قدیمی «نار» را به معنای آتش گرفته بود، نه انار؛ برای همین در معنی این بیت هم اثری از انار نیست.
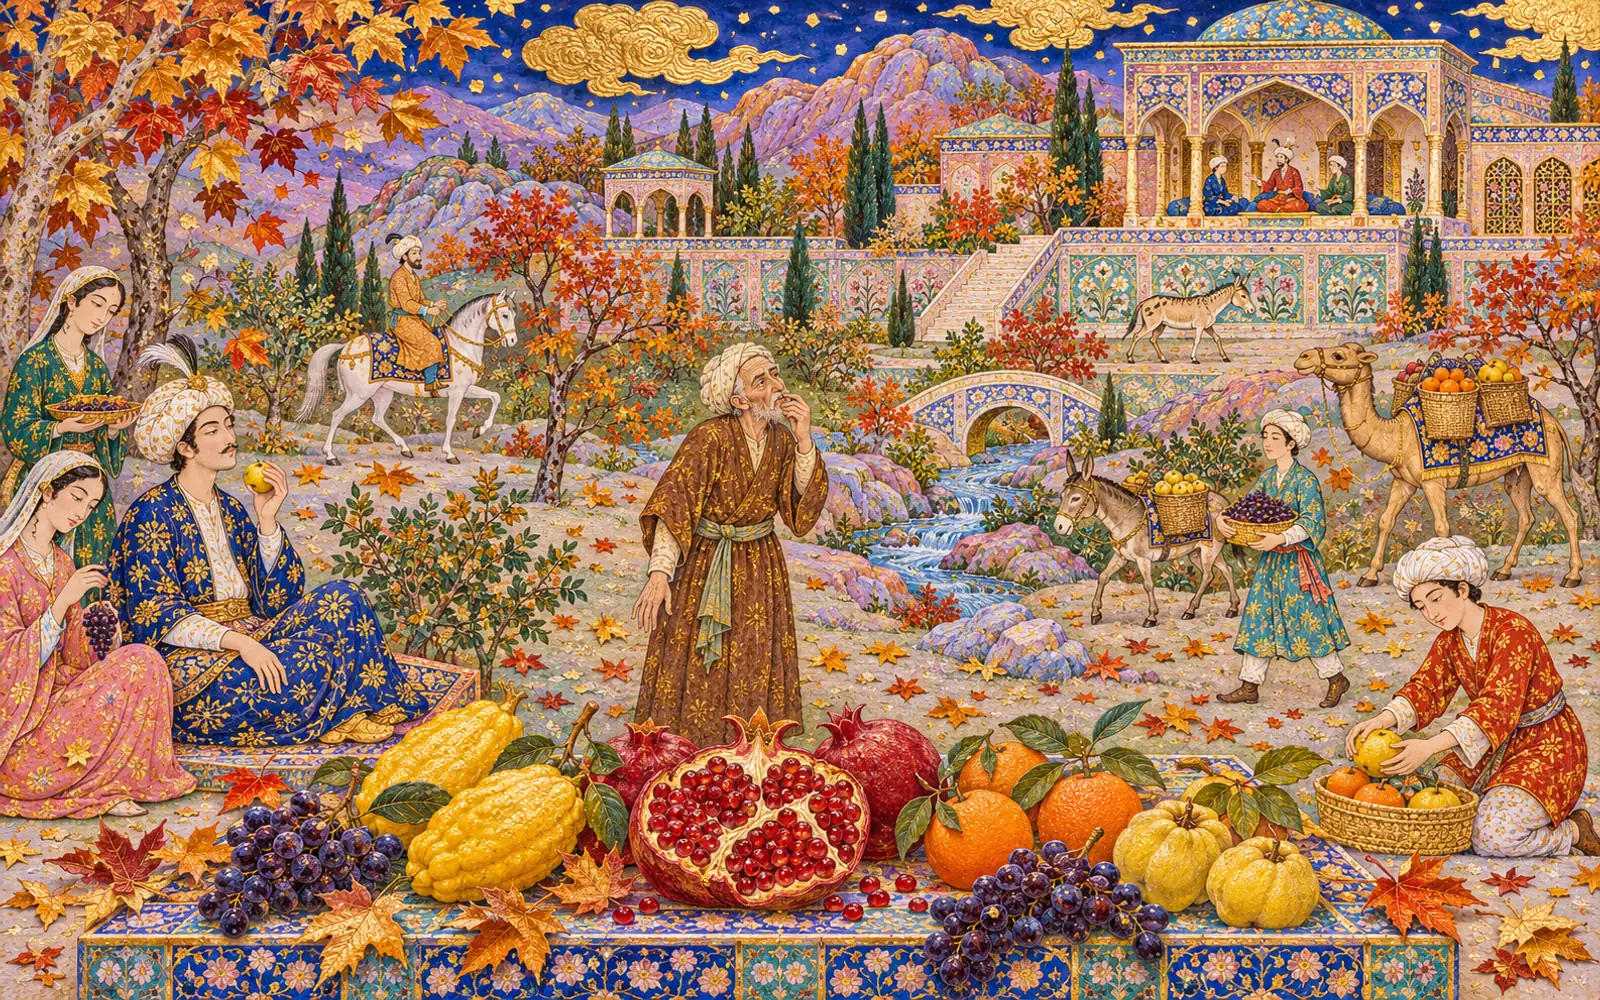 باغ پاییزی منوچهری: دهقان از تعجب انگشت به دهان گرفته و انارِ شکافته مثل جعبه جواهر کنار ترنج و نارنج و انگور است. تصویرسازی: ژرف، با هوش مصنوعی.
لختی گهر سرخ در آن حقه نهادهتوتو سلب زرد بر آن روی فتاده
معنی قبلی در گنجور
معنی تازه
یک دانه مروارید سرخ در آن پارچهٔ رنگی گذاشتهاند و نقاشی زردی بر آن درخشیدگی میافکند.
در آن جعبه مقداری گوهر سرخ (دانههای انار) نهادهاند و پردههای زرد لایهلایه بر روی آنها افتاده است.
همین شعر نکته دیگری هم دارد: معنی بیت سومش را یکی از کاربران نوشته یا ویرایش کرده بود و این بار دست نخورده است.
خیام در یکی از رباعیهایی که صادق هدایت از او انتخاب کرده از کسانی میگوید که عمرشان را بر سر بحث هستی و نیستی گذاشتند. بیت آخر این است:
رو با خبرا، تو آب انگور گُزینکآن بیخبران به غوره مِیْویز شدند!
معنی قبلی در گنجور
معنی تازه
با افرادی که از حقیقت آگاهند معاشرت کن و از لذتهای زودگذر دوری کن، زیرا دیگران که بیخبرند، تنها در کارهای سطحی و ناپایدار غرق شدهاند.
ای آگاه، برو و شراب را برگزین، زیرا آن بیخبران هنوز غوره بودند که مویز شدند. یعنی پیش از آنکه پخته شوند و از زندگی بهره ببرند، خشکیدند و پیر شدند. انگور اگر به شراب بدل شود به کمال میرسد، ولی غورهای که مویز شود نه شراب شده و نه انگور شیرین.
معنی قبلی «با خبرا» را «با» و «خبرا» خوانده بود، یعنی همنشینی با آگاهان، و از زبان خیام توصیه کرده بود که از لذت دوری کنیم. «با خبرا» یک کلمه است و منادا: ای آگاه.
قرار بود کل گنجور یکجا معنی شود، پس انتخاب مدل مهمترین تصمیم بود. آرمان برای ادبیات فارسی آزمون استانداردی (بنچمارک) پیدا نکرد و خودش یکی ساخت: Konkour-Bench، که مدلها را با سؤالهای کنکور ۱۴۰۵ محک میزند. به گزارش خبرگزاری مهر، امسال ۱٬۰۷۰٬۲۴۱ نفر برای کنکور ثبتنام کرده بودند و آزمون گروه انسانی صبح جمعه ۳۰ مرداد ۱۴۰۵ برگزار شد. کنکور برای این کار مناسب بود: سؤالهایش فارسی است، هر سال از نو نوشته میشود، آسان و متوسط و سخت دارد و از موضوعهای مختلف ادبیات سؤال میآورد. مهمتر از همه، به گفته آرمان اگر مدلها را چند روز بعد از کنکور امتحان کنی، پاسخ سؤالها نمیتواند در داده آموزشی هیچ مدلی باشد. بدون این شرط هیچ نمره آزمونی قابل اعتماد نیست. آرمان مدلها را بین ۲۶ مهر و ۹ آبان امتحان کرد، حدود دو ماه بعد از کنکور؛ پس مدلهایی که داده آموزشیشان مال پیش از کنکور است، نمیتوانستهاند جوابها را دیده باشند.
آزمون همان ۸۰ سؤال دفترچه اول کنکور انسانی است: ۲۰ سؤال ریاضی، ۳۰ سؤال زبان و ادبیات فارسی، ۱۵ سؤال علوم اجتماعی و ۱۵ سؤال روانشناسی. آرمان سؤالها را به فارسی و با یک دستور کوتاه یکسان به همه مدلها داد و از آنها خواست فقط شماره گزینه را جواب بدهند. هیچ مدلی به جستجوی وب یا ابزار دیگری دسترسی نداشت. هر مدل را در سه سطح استدلال امتحان کرد، یعنی با سه اندازه فکر کردن پیش از جواب: کم، متوسط و زیاد. مدلهای Claude را با ابزار خط فرمان Claude Code و با اشتراک Claude اجرا کرد و بقیه را از راه OpenRouter. در راهنمای (README) مخزن Konkour-Bench آمده که این دو روش یکسان نیست؛ مثلاً Claude Code ممکن است پیش از جواب دادن چند کار دیگر هم بکند. پس شرایط Claude و بقیه مدلها کاملاً یکی نبوده است.
از کل ۸۰ سؤال، Claude Opus 5.5 در سطح متوسط و Gemini 3.8 Flash در سطح زیاد هر کدام ۷۴ سؤال را درست جواب دادند. در ۳۰ سؤال ادبیات، Opus 5.5 در سطح متوسط ۲۷ جواب درست داشت و اول شد. Opus 5.5 در سطح کم و Gemini 4 Argon در سطح متوسط، هر کدام با ۲۶ جواب درست، پشت سرش بودند. جالب اینکه همین Opus 5.5 در سطح زیاد فقط ۲۵ سؤال را درست زد. آرمان Opus 5.5 را در سطح متوسط انتخاب کرد.
پاسخ درست به ۳۰ سؤال ادبیات فارسی کنکور ۱۴۰۵
هر ردیف یک مدل در یک سطح استدلال است؛ نقطه، درصد پاسخهای درست را نشان میدهد و خط، بازه اطمینان ۹۵ درصدی را.
| مدل | سطح استدلال | پاسخ درست از ۳۰ |
|---|---|---|
| Claude Opus 5.5 | متوسط | ۲۷ |
| Claude Opus 5.5 | کم | ۲۶ |
| Gemini 4 Argon | متوسط | ۲۶ |
| Claude Opus 5.5 | زیاد | ۲۵ |
| Gemini 3.8 Flash | زیاد | ۲۵ |
| Gemini 4 Argon | زیاد | ۲۵ |
| GPT-6.1 Sol | متوسط | ۲۴ |
| GPT-6.1 Sol | زیاد | ۲۴ |
| Gemini 3.8 Flash | متوسط | ۲۴ |
| Gemini 3.8 Flash | کم | ۲۳ |
| GPT-6.1 Sol | کم | ۲۲ |
| Gemini 4 Argon | کم | ۲۲ |
| DeepSeek V4.1 Flash | زیاد | ۲۱ |
| Grok 4.7 | کم | ۲۱ |
| DeepSeek V4.1 Flash | کم | ۲۰ |
| Claude Sonnet 5.5 | متوسط | ۱۹ |
| GPT-6 Luna | متوسط | ۱۹ |
| Qwen3.8 Max | کم | ۱۹ |
| Qwen3.8 Max | متوسط | ۱۹ |
| GPT-6 Luna | کم | ۱۷ |
| GPT-6 Luna | زیاد | ۱۶ |
| Claude Sonnet 5.5 | کم | ۱۳ |
| Qwen3.8 27B | کم | ۱۳ |
| Qwen3.8 27B | متوسط | ۱۰ |
منبع: فایل نتایج Konkour-Bench آرمان جعفرنژاد (دفترچه اول کنکور انسانی ۱۴۰۵). بازهها به روش ویلسون حساب شدهاند. اجراهایی که نیمهکاره ماندند یا از جدول کنار گذاشته شدند، در نمودار نیستند. مدلهای Claude از راه Claude Code و بقیه از راه OpenRouter اجرا شدند. کلید سؤالها با کلید رسمی مقایسه نشده است. نمودار: تیم ژرف.
به این نمودار زیاد تکیه نکنید. در آزمونی که فقط ۳۰ سؤال دارد، ردیف اول و دوم فقط یک سؤال با هم فرق دارند. بازه اطمینان ۹۵ درصدی ردیف اول هم با بازه اغلب ردیفهای بعدی روی هم میافتد. پس این آزمون نشان نمیدهد کدام مدل بهترین است، فقط نشان میدهد کدام مدلها جزو بهترینها هستند. در همان راهنما هم آمده که کلید سؤالها با کلید رسمی سازمان سنجش مقایسه نشده است. با این همه، انتخاب آرمان منطقی بود. Opus 5.5 در هر سه سطح بالای جدول بود و بهترین نتیجهاش را در سطح متوسط گرفت. برای کاری به این حجم، سطح متوسط یعنی فکر کردن کوتاهتر و هزینه کمتر.
برای انتخاب پرامپت، آرمان نمونههایی لازم داشت که جواب درستشان را از قبل بداند. آنها را در معنیهایی پیدا کرد که کاربران گنجور برای همان ۱٫۵ درصد بیتها نوشته بودند. اگر پرامپتی کاری کند که معنیهای مدل با معنیهای کاربران جور دربیاید، پرامپت خوبی است. آرمان ۱۶۰ شعری را انتخاب کرد که کاربران برایشان معنی نوشته بودند. پرامپتها را روی ۸۰ تای آنها امتحان کرد و ۸۰ تای دیگر را کنار گذاشت تا آخر کار، برنده را روی آنها هم امتحان کند.
دو مدل از دو شرکت مختلف داوری کردند: Claude Opus 5.5 و GPT-6.1 Sol. هر داور معنی مدل را برای هر بیت با معنی کاربران مقایسه میکرد و میگفت درست است، تا حدی درست یا غلط. نمره هر پرامپت درصد معنیهای درست بود (هر معنی تا حدی درست نصف حساب میشد) و نمره نهایی میانگین نمره دو داور بود.
۲۳ پرامپت وارد مسابقه شدند. تعدادی را خود آرمان نوشته بود: بعضی اطلاعات بیشتری درباره شعر به مدل میدادند، بعضی چند نمونه داشتند، بعضی آرایههای ادبی را توضیح میدادند، بعضی خیلی کوتاه بودند و در بعضی دستورها به فارسی بود. بعد توضیح همه این پرامپتها را به Gemini و GPT داد و از آنها خواست پرامپت بهتری بنویسند. بعد از دور اول، ۱۵ پرامپت ماند. پیش از دور اصلی هم نوشت که برنده را چطور انتخاب میکند: دقیقترین پرامپت برنده است، به شرط اینکه فاصلهاش با بقیه از حاشیه خطا بیشتر باشد؛ وگرنه ارزانترین برنده است.
نمره هر ۱۵ پرامپت بین ۹۷٫۴ و ۹۷٫۹ درصد بود. پس طبق همان قاعده ارزانترین پرامپت برد، و آن یکی از همان پرامپتهای ساده اول بود. این پرامپت شعر را به مدل میدهد و میگوید از کجا آمده است: شاعر، کتاب، بخش و بیتهای قبل و بعد. هر ترفندی که رویش اضافه شد، جواب را بلندتر کرد و بهتر نکرد. در ۸۰ شعری که کنار گذاشته شده بود، همین پرامپت ۹۷٫۸ درصد گرفت، یعنی همان نمره دور اصلی.
بزرگترین فرق متنهای قبلی و تازه در خلاصه شعرها بود. به نظر همین دو مدل داور، خلاصههای قبلی گنجور حدود ۴۳ درصد نمره گرفتند و خلاصههای تازه بین ۹۶ و ۹۹ درصد. آرمان نتیجه سادهای میگیرد: لازم نیست به مدل یاد بدهی شعر فارسی را چطور بخواند، کافی است بگویی شعر از کیست و کجای کتاب است. در پرامپتنویسی هم کلاً همینطور است: گفتن اینکه متن از کجا آمده بیشتر از ترفندهای پیچیده جواب میدهد.
آزمون پرامپتها دو روز طول کشید و حدود ۱۶۰ دلار خرج داشت. این آزمون تعداد واقعی توکنها را هم معلوم کرد و آرمان با آن هزینه کل را دوباره حساب کرد. هر درخواست یک هزینه ثابت دارد (برای دستورها، معرفی شاعر و خلاصه) و هر بیت هم کمی به آن اضافه میکند. کل کار حدود ۱۵۵٬۴۰۰ درخواست و ۱٫۶۱ میلیون بیت بود. قیمت پردازش دستهای ۲ دلار برای هر میلیون توکن ورودی و ۱۰ دلار برای هر میلیون توکن خروجی است. با این عددها، برآورد آرمان حدود ۳٬۱۰۰ دلار شد. همان شب اول، سرانگشتی ۳٬۰۰۰ دلار حساب کرده بود.
برآورد هزینه معنی کردن بیتهای گنجور، قسمت به قسمت
قیمت پردازش دستهای: ۲ دلار برای هر میلیون توکن ورودی و ۱۰ دلار برای هر میلیون توکن خروجی
محاسبه تیم ژرف با فرمول و عددهایی که آرمان جعفرنژاد در نوشتهاش آورده: حدود ۱۵۵٬۴۰۰ درخواست، هر کدام حدود ۱٬۷۰۰ توکن ورودی و ۶۰۰ توکن خروجی، و حدود ۱٫۶۱ میلیون بیت، هر کدام ۴۰ توکن ورودی و ۹۱ توکن خروجی. جمع ۳٬۰۵۵ دلار میشود که آرمان آن را حدود ۳٬۱۰۰ دلار گرد کرده است.
حدود ۸۰ درصد این مبلغ خرج توکنهای خروجی است، چون هر توکن خروجی پنج برابر توکن ورودی قیمت دارد. برای همین هر پرامپتی که جواب را بلندتر میکرد ولی بهتر نمیکرد، کنار گذاشته میشد. هر جمله اضافه در جواب مدل حدود ۱٫۶ میلیون بار تکرار میشد.
شعرهای کوتاه را کامل فرستاد. بخشهای بلندی مثل بخشهای شاهنامه را در تکههای ۳۰ بیتی یا کوتاهتر فرستاد و همراه هر تکه تا سه بیت قبلی را هم گذاشت؛ این بیتها فقط برای این بود که مدل بداند ماجرا به کجا رسیده و قرار نبود معنی شوند. اینها هم همراه متن میرفت: اسم و دوره شاعر و معرفی کوتاهی از او؛ نام کتاب و بخش؛ قالب و وزن؛ و عنوان بخش قبلی و بعدی. آرمان در نوشتهاش نمونهای از نبرد رستم و اسفندیار آورده است. تکه با بیت «چرا ساختی بند و مکر و فریب» شروع میشود و از خود بیت معلوم نیست چه کسی با چه کسی حرف میزند. سه بیت قبلی این را روشن میکند و مدل معنی را با «اسفندیار به رستم میگوید» شروع کرده است.
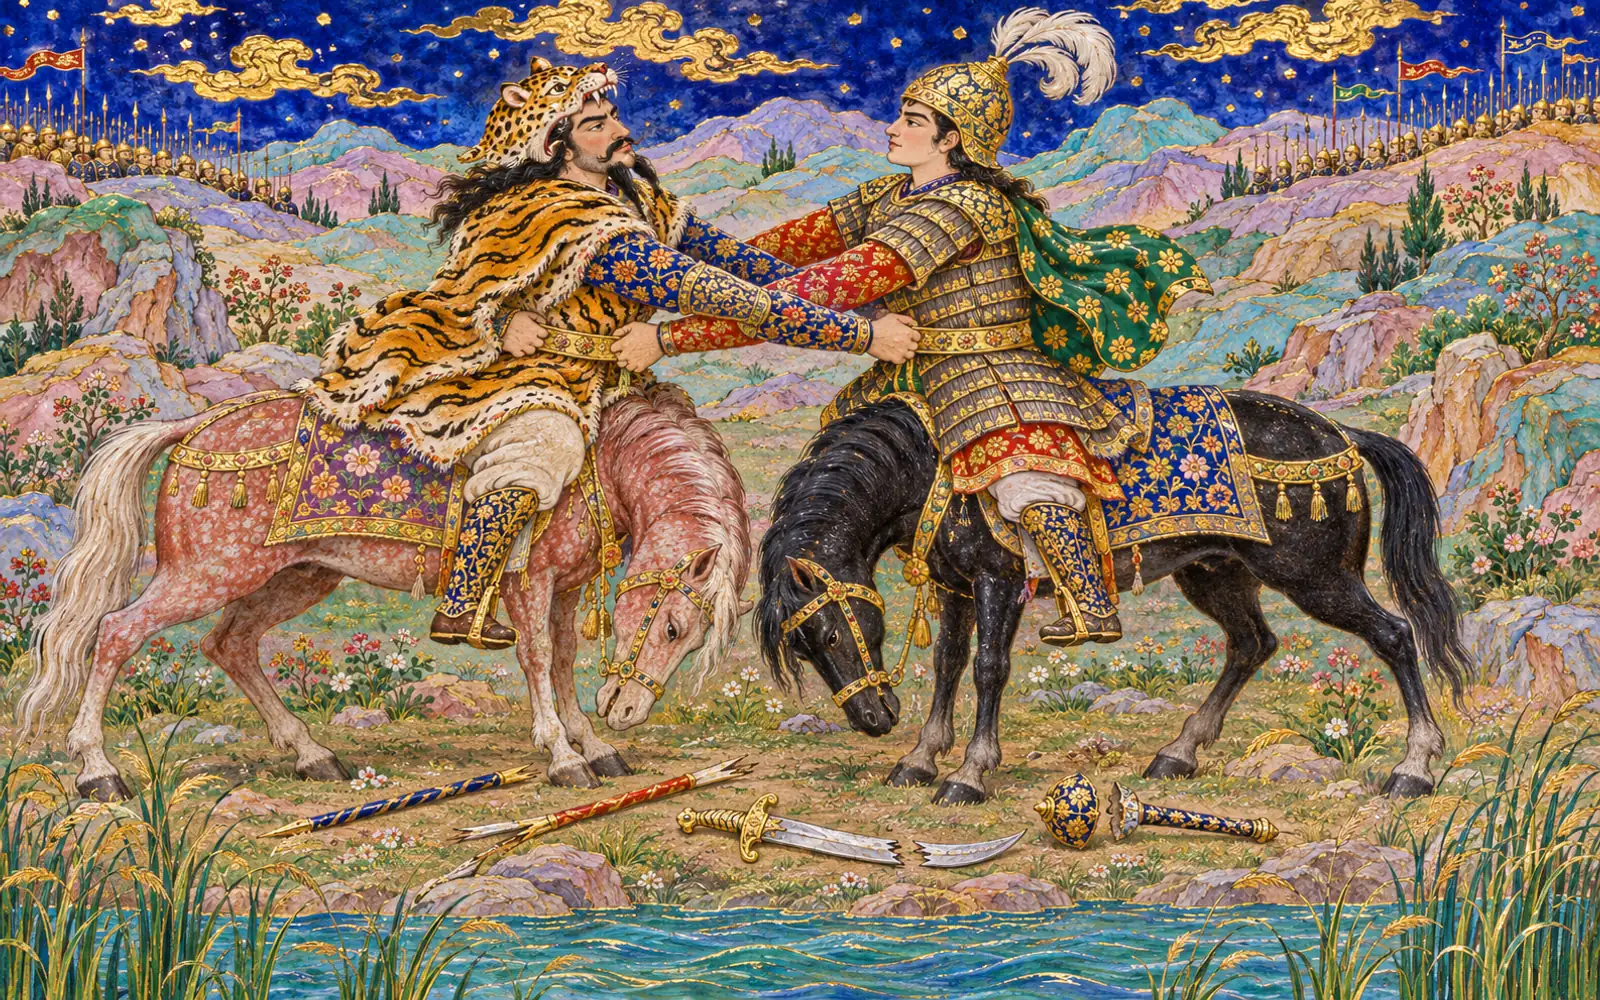 نبرد تنبهتن رستم و اسفندیار بر کرانه هیرمند: نیزه و شمشیر و گرز شکستهاند و دو پهلوان کمربند یکدیگر را گرفتهاند. تصویرسازی: ژرف، با هوش مصنوعی.
از مدل سه چیز خواست: برای هر بیت یک معنی در یک تا سه جمله به فارسی ساده، برای هر بیت علامتی که بگوید مطمئن است درست فهمیده یا نه، و برای کل تکه یا شعر یک خلاصه دو تا چهار جملهای. هر جواب را پیش از پذیرفتن بررسی کرد: هر بیت باید دقیقاً یک معنی داشته باشد، خلاصه دستکم ۴۰ حرف باشد، متن فقط به خط فارسی باشد و جواب مدل نیمهکاره نمانده باشد. اگر جوابی رد میشد، تا سه بار دوباره از مدل جواب میخواست. این همان قاعده همیشگی پردازش دستهای است: هیچ جوابی بدون بررسی وارد داده اصلی نمیشود. در کل ۱۵۵٬۶۵۱ شعر یا تکه پردازش شد و ۱٬۶۱۳٬۳۴۶ معنی بیت به دست آمد. به گفته آرمان، لازم نشد سراغ مدل دیگری برود و مدل هیچ درخواستی را بیجواب نگذاشت.
برای اینکه معلوم شود معنیهای تازه چقدر بهترند، آرمان در پنج نوبت جدا، هر بار ۱۰۰ بیت تصادفی انتخاب کرد. داورها هر بیت را با بیتهای قبل و بعدش خواندند، معنی تازه را کنار معنی قبلی گذاشتند و گفتند کدام بهتر است و چقدر: خیلی بهتر، کمی بهتر، یا تقریباً یکسان.
معنی تازه در برابر معنی قبلی، در ۵۰۰ بیت تصادفی
پنج نوبت جدا، هر بار ۱۰۰ بیت؛ داورها هر بیت را با بیتهای قبل و بعدش خواندند.
منبع: نوشته آرمان جعفرنژاد و درخواست ادغام شماره ۴ در مخزن دادههای گنجور. داورها مدلهای هوش مصنوعی بودند و میدانستند کدام معنی تازه است. نمودار: تیم ژرف.
در ۴۱۳ بیت از ۵۰۰، یعنی ۸۳ درصد، معنی تازه بهتر بود (بازه اطمینان ۹۵ درصدی: ۷۹ تا ۸۶ درصد). این درصد در هر پنج نوبت بین ۷۶ و ۸۹ بود. معنی قبلی فقط در چهار بیت بهتر بود و در هیچکدام خیلی بهتر نبود. البته به گفته خود آرمان، داورهای این مقایسه هم مدلهای هوش مصنوعی بودند و میدانستند کدام معنی تازه است.
خود آرمان چند محدودیت را صریح نوشته است که هر کسی از این معنیها استفاده میکند باید بداند:
اگر این علامت کنار معنیها دیده شود، یا این ۳۳۰ هزار بیت اول به ویراستاران گنجور سپرده شود، بازبینی از همان بیتهایی شروع میشود که بیشترین اشکال را دارند.
این نکتهها فقط به کار شعر نمیآید. هر سازمانی که میخواهد حجم زیادی متن فارسی را با مدل زبانی پردازش کند، مثلاً قرارداد، نامه یا فاکتور، باید همین تصمیمها را بگیرد:
گنجور از بزرگترین مجموعههای رایگان متن فارسی است و معنی بهتر بیتهایش به کار هر کسی میآید که برای جستجو، آموزش ادبیات یا خواندن متن فارسی ابزار میسازد. آرمان میخواهد حالا همین معنیها را در گنجورجور به کار ببرد.
آخرین بررسی: ۲۹ آبان ۱۴۰۵ (۲۰ نوامبر ۲۰۲۶)
برچسبهاگنجورشعر فارسیمعنی بیتپردازش زبان فارسیارزیابی مدل زبانیClaude Opus 5.5
قیمت خواندن حافظه نهان سونت ۵٫۵ در ۷ اکتبر کاهش یافت. هزینه کار، شواهد بازبینی کد، تغییرات API و موارد انتخاب اوپوس ۵٫۵ را بررسی میکنیم.
ادامه مطلب
اوپوس ۵٫۵ تعرفه ورودی و خروجی را کاهش داده است. نتایج آزمونها، هزینه واقعی، چهار تغییر ناسازگار در API و محدودیتهای تازه را بررسی میکنیم.
ادامه مطلب
خوانش بخشبهبخش کارت سیستم ۲۳۰ صفحهای Opus 5.5؛ آستانههای زیستی و پژوهش هوش مصنوعی، ارزیابی سایبری، تزریق prompt، ممیزی همسویی، رفاه مدل و بنچمارکها.
ادامه مطلباگر این مطلب به فرایندی واقعی در سازمان شما مربوط است، از صفحه خدمات شروع کنید یا با ما تماس بگیرید.