فناوری هوش مصنوعی
کلود اوپوس ۵٫۵؛ هزینه کمتر برای کارهای پیچیده و تغییرات مهم API
اوپوس ۵٫۵ تعرفه ورودی و خروجی را کاهش داده است. نتایج آزمونها، هزینه واقعی، چهار تغییر ناسازگار در API و محدودیتهای تازه را بررسی میکنیم.
ادامه مطلبقیمت خواندن حافظه نهان سونت ۵٫۵ در ۷ اکتبر کاهش یافت. هزینه کار، شواهد بازبینی کد، تغییرات API و موارد انتخاب اوپوس ۵٫۵ را بررسی میکنیم.
آنتروپیک ۲۸ سپتامبر ۲۰۲۶، برابر با ۶ مهر ۱۴۰۵، شش روز پس از اوپوس ۵٫۵، کلود سونت ۵٫۵ را عرضه کرد. به گفته شرکت، مدل تازه خروجی را بیش از ۳۰ درصد سریعتر از سونت ۵ تولید میکند و هزینه انجام هر کار میتواند تا ۳۰ درصد کمتر شود. نکته اینجاست که تعرفه توکن در روز عرضه پایین نیامده بود؛ صرفهجویی قرار است از مصرف کمتر توکن به دست بیاید. این ارقام در اطلاعیه عرضه آمدهاند و حاصل اندازهگیری ژرف نیستند.
برای تیمی که دستیار برنامهنویسی انتخاب میکند یا پردازش اسناد را به مدل میسپارد، پرسش اصلی این است که این صرفهجویی در کار خودش هم رخ میدهد یا نه. پیشنویس سریع ارزش دارد، اما اگر برای اصلاح آن به مدل دیگری و زمان زیادی از بازبین نیاز باشد، حساب هزینه عوض میشود. برداشت ما از شواهد این است که سونت را میتوان ابتدا در کارهای مشخص و محدود آزمود و برای تصمیمهای دشوار مسیر جداگانهای داشت.
بهروزرسانی قیمت در ۷ اکتبر: اطلاعیه هایکو ۵٫۵، قیمت خواندن حافظه نهان سونت ۵٫۵ را از ۰٫۲۰ به ۰٫۱۰ دلار برای هر میلیون توکن کاهش داد. جدول و مثال زیر از نرخ جدید استفاده میکنند؛ ادعاهای بازدهی روز عرضه همچنان به ۲۸ سپتامبر مربوطاند. برای مدل کوچکتر و اعتبار API همراه آن، پوشش انتشار هایکو ۵٫۵ را ببینید.
صفحه مشخصات مدل شناسه claude-sonnet-5-5، ورودی متن و تصویر، خروجی متن، ظرفیت زمینه یک میلیون توکنی و سقف معمول خروجی ۱۲۸ هزار توکن را اعلام میکند. مدل از طریق API کلود، آمازون Bedrock، گوگل Cloud و مایکروسافت Foundry عرضه شده است. شناسه و قابلیتهای قابل استفاده را باید برای همان سرویسی بررسی کرد که قرار است میزبان برنامه باشد.
ظرفیت زمینه بزرگ زمانی مفید است که چند سند باید کنار هم خوانده شوند. اما این ظرفیت بهخودیخود نشان نمیدهد که مدل همه استثناهای متن را پیدا میکند. مثلاً هنگام مقایسه قرارداد، الحاقیهها و پیوست قیمت، باید از مدل خواست تعارضها را مشخص کند و برای هر نتیجه، بند مربوط را نشان دهد. بارگذاری هر سه سند فقط آغاز کار است.
پیشتر در بررسی عرضه اوپوس ۵٫۵ و خوانش گزارش فنی و ایمنی آن، مدل بزرگتر را پوشش دادهایم. سونت گزینه ارزانتری برای کارهای پرتکرار اضافه میکند؛ لازم نیست هر دو مدل مسئولیت یکسانی داشته باشند.
در جدول آنتروپیک، سونت ۵٫۵ در آزمون Terminal-Bench 4.0 امتیاز ۷۰٫۶ درصد گرفته و از اوپوس ۵٫۵ با ۶۶٫۴ درصد جلو افتاده است. در GDPval-AA v2.1 هم امتیازها تقریباً برابرند: ۱٬۸۴۴ در برابر ۱٬۸۴۶. با این حال، نتیجه سونت در FrontierCode با تنظیم xhigh برابر ۵۲٫۱ درصد و با max برابر ۴۶٫۲ درصد است. این اعداد به آزمونها و تنظیمات معین تعلق دارند و رتبهبندی همیشگی مدلها نیستند.
همین مقایسه آخر دلیلی است که همیشه بیشترین توان محاسباتی را انتخاب نکنیم. عامل ممکن است زمان بیشتری صرف تغییراتی کند که کمکی به درخواست اصلی نمیکنند. اگر بازبین آن تغییرات را نپذیرد، پاسخ مفصلتر عملاً نتیجه بدتری داده است. بنابراین معیار پذیرش باید هم انجام اصلاح خواستهشده را بسنجد و هم دست نزدن به بخشهای نامرتبط را.
یک کار نرمافزاری چند قضاوت جداگانه دارد: پیدا کردن خطا، تصمیم درباره دامنه تغییر، بررسی رفتار برنامه و توضیح نتیجه. امتیاز کلی ممکن است ضعف یکی از این مراحل را پنهان کند. بهتر است همان مرحلهای را بسنجید که خطا در آن برای تیم شما گران تمام میشود؛ امتیاز خوب در کار با خط فرمان، تضمین بازبینی دقیق نیست.
در ارزیابی خود کدرَبیت، سونت ۵٫۵ از میان ۱۳ خطای دشوار و شناختهشده، شش مورد را با نظر قابل اقدام پیدا کرد؛ سونت ۵ چهار مورد را یافت. اوپوس ۵٫۵ در حالت Standard هشت و در حالت Max ده مورد را پیدا کرد. سونت تازه دو خطایی را هم ندید که نسخه قبلی یافته بود. نمونه کوچک است و داوری کیفیت مجموعه جداگانه ۴۴ درخواست تغییر کد، هنگام انتشار گزارش هنوز تمام نشده بود. ژرف این آزمایشها را تکرار نکرده است.
موارد جامانده به اندازه بهبود میانگین اهمیت دارند. با عوض کردن بازبین ممکن است نوع خطاهایی که از چشم او دور میمانند تغییر کند، حتی اگر تعداد کل کشفها بیشتر شود. پیش از جایگزینی، نمونههای موفق مدل فعلی را نگه دارید و دوباره امتحان کنید. مدلی که در بازبینی ظاهر صفحه بهتر شده اما خطای پرداخت تکراری را کمتر میبیند، به استقرار انتخابیتری نیاز دارد.
این شواهد را شرکتی منتشر کرده که مدل را در محصول تجاری بازبینی کد خودش میآزماید. ارزش گزارش در مشخص بودن روش کار است، ولی روش آن شرکت لزوماً روش همه تیمها نیست. گام بعدی، آزمایشی تکرارپذیر است که نمونهها و قواعد پذیرش آن پیش از دیدن پاسخها تعیین شده باشند.
جدول زیر تعرفههای استاندارد صفحه سونت و مستندات اوپوس ۵٫۵ را کنار هم میگذارد. همه مبلغها دلار آمریکا بهازای یک میلیون توکن هستند و به استفاده از API مربوطاند، نه مقایسه اشتراکهای کلود.
| نوع مصرف | سونت ۵٫۵ | اوپوس ۵٫۵ |
|---|---|---|
| ورودی تازه | ۲ دلار | ۴ دلار |
| خروجی | ۱۰ دلار | ۲۰ دلار |
| خواندن از حافظه نهان | ۰٫۱۰ دلار | ۰٫۲۰ دلار |
| نوشتن در حافظه نهان پنجدقیقهای | ۲٫۵۰ دلار | ۵ دلار |
| نوشتن در حافظه نهان یکساعته | ۴ دلار | ۸ دلار |
یک مثال حسابی بزنیم؛ این مثال نتیجه اجرای واقعی نیست. فرض کنید یک نوبت کار، ۲۰۰ هزار توکن از حافظه نهان میخواند، ۱۰ هزار توکن ورودی تازه دارد و ۵ هزار توکن خروجی، با احتساب تفکر، تولید میکند. هزینه سونت ۰٫۰۹ دلار میشود: ۰٫۰۲ دلار خواندن حافظه نهان، ۰٫۰۲ دلار ورودی تازه و ۰٫۰۵ دلار خروجی. همان مصرف با اوپوس ۰٫۱۸ دلار هزینه دارد. با نرخهای ۷ اکتبر و مصرف ثابت این مثال، سونت ۵۰ درصد ارزانتر است.
هزینه نوشتن در حافظه نهان، ابزارها، تلاش مجدد و بازبینی انسانی در این مثال نیامده است. تعداد توکنها هم ثابت فرض شده، در حالی که در اجرای واقعی لزوماً یکسان نیست. اگر پاسخ سونت رد شود و همان کار را به اوپوس بسپاریم، هزینه هر دو تلاش باید در حساب نتیجه نهایی بیاید. انتخاب خودکار مدل زمانی صرفه دارد که بهاندازه کافی از اجراهای گران کم کند، بدون آنکه تلاشهای ناموفق زیادی بسازد.
راهنمای کار با سونت ۵٫۵ برای برنامهنویسی با دامنه روشن، شروع با medium و برای کار دشوارتر، رفتن به high را پیشنهاد میکند. راهنما هشدار میدهد که تلاش کمتر گاهی به جا افتادن بررسی یا توقف پیش از پایان کار طولانی میانجامد. پیشفرض API برابر high است؛ طبق اطلاعیه عرضه، برنامههای کلود و کلود کد از medium شروع میکنند.
در آزمایش داخلی، پایان کار را طوری تعریف کنید که بازبین بتواند آن را تأیید کند. «خطای ثبت فاکتور تکراری را بازتولید و اصلاح کن و نتیجه بررسی را نشان بده» از «رسیدگی به فاکتورها را بهتر کن» روشنتر است. ثبت کنید که آیا مدل واقعاً بررسی را اجرا کرده و آیا تغییر در محدوده درخواست مانده است. اعلام مطمئنِ پایان کار، مدرک انجام هیچکدام نیست.
پیش از رفتن سراغ بالاترین تنظیمات، همان نمونهها را با دو سطح متناسب امتحان کنید. اسناد ورودی، دسترسی ابزارها و قواعد پذیرش را ثابت نگه دارید. وگرنه شاید پاسخ بهتر حاصل دستور روشنتر یا دسترسی بیشتر باشد، نه تنظیم بهتر مدل. راهنمای ارزیابی مدلها کمک میکند این تفاوتها در ثبت نتایج گم نشوند.
طبق راهنمای مهاجرت، بهجای خاموش کردن تفکر باید از between_tools استفاده کرد؛ این حالت تا سطح high پذیرفته میشود. اجبار به انتخاب ابزار هم خطا میدهد و باید انتخاب ابزار و اعتبارسنجی نتیجه بازبینی شوند. کار با رایانه در API کلود و گوگل به مجموعه ابزار جدید نیاز دارد؛ بعضی ترکیبهای قدیمی مدل مشاور نیز پذیرفته نمیشوند. درخواستهای واقعی ذخیرهشده را آزمایش کنید، نه فقط یک پرسش تازه را.
هرکدام از این تغییرها به بخشی از برنامه مربوط است: سازنده درخواست، تنظیم تفکر و ابزارها را کنترل میکند؛ محل ذخیره مکالمه مسئول بازخوانی سابقه است؛ رابط کاربر تصمیم میگیرد کدام بخش پاسخ دیده شود. موفقیت یک پاسخ ساده چیز زیادی درباره نوبت دوم یک گفتوگوی قدیمی نمیگوید.
برای بررسی مهاجرت، یک مکالمه واقعی همراه با استفاده از ابزار را انتخاب کنید. اطلاعات حساس را حذف و رفتار مورد انتظار را ثبت کنید: چه ابزاری مجاز است، چه نتیجهای برمیگردد، کاربر چه میبیند و اگر مدل درخواست را نپذیرد چه رخ میدهد. سپس این توالی را با مدل جدید در محیط آزمایشی اجرا کنید. ادامه دادن یک گفتوگوی ذخیرهشده را هم بگنجانید؛ بعضی خطاها فقط وقتی ظاهر میشوند که کاربر بعداً برمیگردد.
مستندات حفظ تفکر وابستگی بخشهای استدلال به مدل، حساب و مکالمه را توضیح میدهد. در API کلود و گوگل، انتقال استدلال از سونت ۵٫۵ به اوپوس ۵٫۵ ممکن است، اما مسیر برگشت چنین نیست. جابهجایی میان حسابهای متصلنشده هم میتواند بخشهای استدلال سونت را بدون شکست درخواست حذف کند. پس موفقیت درخواست، به معنی حفظ کامل زمینه استدلال نیست.
این تفاوت برای سامانهای مهم است که کار دشوار را به مدل قویتر میفرستد و بعد به مدل ارزانتر برمیگردد. تصمیمها، شواهد و کارهای باقیمانده را به شکل خواندنی نگه دارید. نباید فرض کرد بخشهای غیرقابلخواندن استدلال در همه مسیرها جای این سابقه را میگیرند. برگشت از مدل قویتر را هم بهاندازه رفتن به آن آزمایش کنید.
یک تغییر به تجربه کاربر هم مربوط است. راهنمای تغییرات نسخه میگوید گزارشهای طولانیتر میان فراخوانی ابزارها در بخش تفکر میآیند و تنظیم پیشفرض متن آنها را نشان نمیدهد. نپذیرفتن درخواست نیز میتواند با وضعیت HTTP 200 و stop_reason: "refusal" برگردد. مسیر جایگزینِ اختیاری، بعضی درخواستها را با سونت ۵ دوباره اجرا میکند. هم نمایش پیشرفت و هم مدل پاسخدهنده را بررسی کنید؛ موفقیت HTTP کافی نیست.
ما سونت ۵٫۵ را برای کار فارسی آزمایش نکردهایم. بهبود امتیازهای عمومی و تعریف شرکت از نثر روانتر، نشان نمیدهد که مدل اصطلاحات، عددها و لحن تحریریه شما را درست رعایت میکند.
یک آزمون مفید میتواند سه کار داشته باشد: بازنویسی نامه مشتری بدون تغییر تعهدها، استخراج مبلغ و تاریخ از سند فارسی و انگلیسی، و بازبینی یک فرم راستبهچپ. روانی نثر را جدا از درستی اطلاعات بسنجید. جمله خوشخوان ممکن است معنای یک شرط را وارونه کند؛ عدد درست هم ممکن است به واحد اشتباه نسبت داده شود.
در نمونهها، ابهام ریال و تومان، تاریخ شمسی و شناسه انگلیسی یک محصول در جمله فارسی را بگنجانید. بازبین پیش از دیدن نام مدل، تغییر معنا، حذف اطلاعات و عبارتهای ناآشنا را علامت بزند. برای فرم نیز خروجی را در عرض کمِ صفحه موبایل ببینید. درست بودن متن بهتنهایی ثابت نمیکند که ترکیب نوشتار فارسی و انگلیسی درست نمایش داده میشود.
اینها آزمونهای پیشنهادی ما هستند، نه قابلیتهای اثباتشده سونت. مزیتشان این است که شکست به تصمیم مشخص میرسد: روشنتر کردن دستور، افزودن بررسی قطعی در برنامه، حفظ بازبینی انسانی یا سپردن آن گروه از کارها به مسیر دیگر.
پیشنهاد ما آزمایشی محدود روی کارهای تکراری با پاسخ روشن و امکان اصلاح کمهزینه است. تصمیمهای معماری دشوار، درخواستهای مبهم و خطاهای پرهزینه را در گروهی جداگانه بررسی کنید. سونت ۵٫۵ را با سامانهای مقایسه کنید که امروز کار را انجام میدهد. افزودن اوپوس بهعنوان گزینه سوم وقتی مفید است که بخواهید بدانید هزینه بیشتر آن در کدام کارها ارزش دارد.
نرخ پذیرش، خطاهای مهم جامانده، زمان بازبینی، هزینه کل و زمان اتمام کار را کنار هم گزارش کنید. نتیجهها را بر اساس نوع کار جدا نگه دارید تا تعداد زیادی موفقیت آسان، یک گروه کوچک اما مهم از شکستها را نپوشاند. ابتدا سهم کمی از کارهای مناسب را منتقل کنید و تا وقتی ادامه مکالمه، رفتار ابزارها و خروجی واقعی بررسی نشده، مسیر قبلی را نگه دارید.
سونت ۵٫۵ انتخاب مدل برای کار روزمره را جالبتر کرده است. دلیل محکم برای استفاده از آن، کاهش قابلاندازهگیریِ زحمتی است که برای رسیدن به نتیجه پذیرفتنی لازم داریم. تیم میتواند این را بسنجد؛ نام مدل بهتنهایی پاسخ نمیدهد.
بازبینی ۷ اکتبر، قیمت حافظه نهان و مثال هزینه را بهروز میکند؛ سایر شواهد در ۲ اکتبر بررسی شدهاند. در این مقاله، شواهد منتشرشده از آزمونهای پیشنهادی و محاسبه هزینه ژرف جدا شدهاند. ما آزمون عملکرد مدل اجرا نکردهایم. تصویر جلد، طرح رسمی عرضه آنتروپیک است که بدون تغییر ترکیببندی به WebP تبدیل شده است.
اوپوس ۵٫۵ تعرفه ورودی و خروجی را کاهش داده است. نتایج آزمونها، هزینه واقعی، چهار تغییر ناسازگار در API و محدودیتهای تازه را بررسی میکنیم.
ادامه مطلب
هایکو ۵٫۵ با زمینه یکمیلیونی و قیمت کمتر عرضه شد. مرز ۱۰۰ هزار توکن، سطح استدلال و تغییرات API تعیین میکنند صرفهجویی واقعی تیمها چقدر باشد.
ادامه مطلب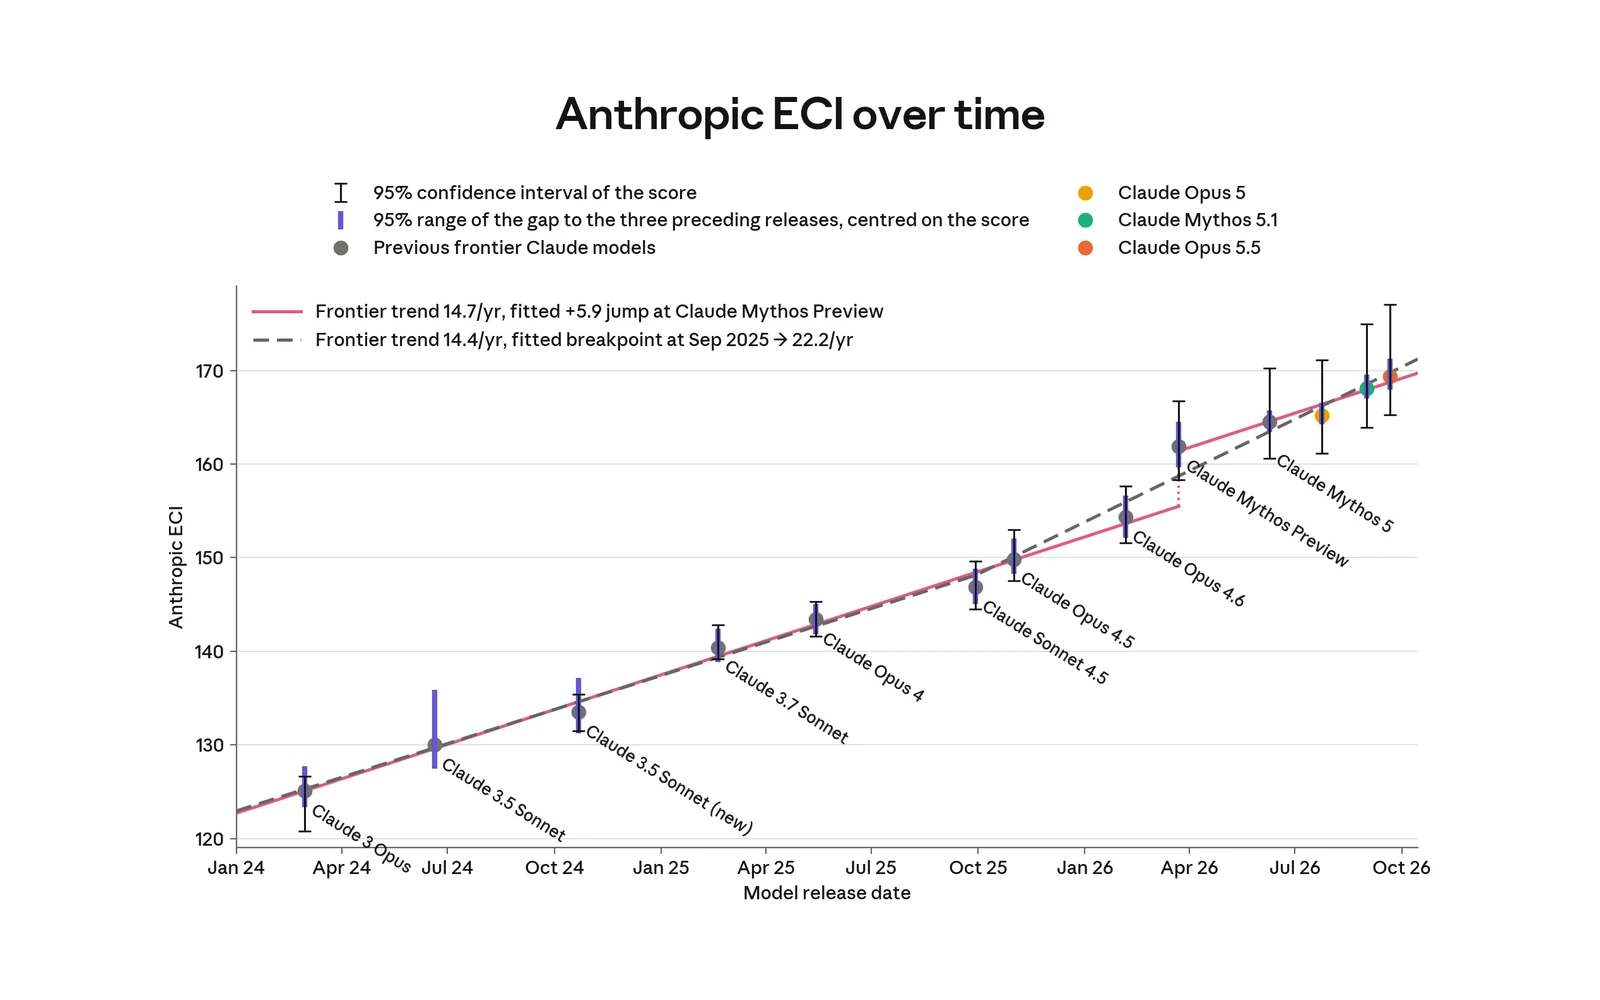
خوانش بخشبهبخش کارت سیستم ۲۳۰ صفحهای Opus 5.5؛ آستانههای زیستی و پژوهش هوش مصنوعی، ارزیابی سایبری، تزریق prompt، ممیزی همسویی، رفاه مدل و بنچمارکها.
ادامه مطلباگر این مطلب به فرایندی واقعی در سازمان شما مربوط است، از صفحه خدمات شروع کنید یا با ما تماس بگیرید.