فناوری هوش مصنوعی
انتشار Claude Haiku 5.5؛ قیمت، معیارها و راهنمای مهاجرت API
هایکو ۵٫۵ با زمینه یکمیلیونی و قیمت کمتر عرضه شد. مرز ۱۰۰ هزار توکن، سطح استدلال و تغییرات API تعیین میکنند صرفهجویی واقعی تیمها چقدر باشد.
ادامه مطلبارتقای ۱۸ آبان آنتروپیک قیمت توکن Fable را ۲۰ درصد کم میکند و در بیشتر معیارهای انتشار پیشتاز است، اما همه حسابها را به سابقه گفتوگوی فقطافزودنی ملزم میکند.
آنتروپیک در ۹ نوامبر ۲۰۲۶، برابر با ۱۸ آبان ۱۴۰۵، مدلهای Claude Fable 5.2 و Claude Mythos 5.2 را منتشر کرد. مانند دو نسل قبل، این دو نام یک مدل زیرین با دو شیوه دسترسیاند. Fable 5.2 در اختیار همه مشتریان Claude API است و طبقهبندهایی دارد که کار پرخطر امنیت سایبری و زیستشناسی را مسدود میکنند. حفاظت Mythos 5.2 در این دو حوزه آزادتر است و فقط سازمانهایی به آن دسترسی دارند که در برنامههای احراز صلاحیت سایبری و علوم زیستی آنتروپیک تأیید شده باشند.
اطلاعیه انتشار سه تغییر را برجسته میکند: کدنویسی، استدلال و بینایی قویتر؛ تولید خروجی تا ۳۰ درصد سریعتر از مدلهای ۵٫۱؛ و قیمت کمتر، یعنی ۸ دلار برای هر میلیون توکن ورودی و ۴۰ دلار برای هر میلیون توکن خروجی بهجای ۱۰ و ۵۰ دلار. در جدول خلاصه کارت سیستم، Fable 5.2 در ۱۴ نتیجه از ۱۶ نتیجه گزارششده بهترین امتیاز را دارد. هر دو استثنا امتیاز Elo کار دانشیاند و در آنها Opus 5.5 همچنان جلوتر است.
این مقاله به تصمیم استقرار میپردازد: مشخصات، قیمت، شرایط معیارها، تغییرات API و سازوکار حفاظت. در تحلیل همراه کارت سیستم، گزارش ۲۶۴صفحهای ایمنی و توانایی را بخشبهبخش میخوانیم. برای نسل قبل، تحلیل Fable 5.1 و Mythos 5.1 را ببینید.
وضعیت شواهد: همه معیارها و نمایشهای این مقاله را آنتروپیک یا آزمایشگران اولیهای که آنتروپیک از آنها نقل میکند گزارش کردهاند. ژرفایآی هیچ ارزیابیای را دوباره اجرا نکرده است. نمونههای هزینه، محاسبه بر پایه تعرفهاند، نه صورتحساب اندازهگیریشده.
این مشخصات از صفحه رسمی مدل و راهنمای تغییرات تازه آمدهاند. Fable 5.2 و Mythos 5.2 جز در دسترسی و سقف نرخ درخواست، مشخصات یکسانی دارند.
| مشخصه | Claude Fable 5.2 |
|---|---|
| تاریخ انتشار | ۹ نوامبر ۲۰۲۶ (۱۸ آبان ۱۴۰۵) |
| شناسه Claude API | claude-fable-5-2 (برای Mythos: claude-mythos-5-2) |
| شناسه آمازون Bedrock | anthropic.claude-fable-5-2 |
| ورودی و خروجی | ورودی متن و تصویر؛ خروجی متن |
| پنجره زمینه | یک میلیون توکن |
| سقف خروجی | ۱۲۸ هزار توکن در هر درخواست |
| تفکر | تفکر تطبیقی، همیشه روشن |
| سطوح تلاش | low، medium، high، xhigh و max؛ پیشفرض API برابر high |
| پایان دانش قابل اتکا و داده آموزشی | ژوئن ۲۰۲۶ |
| زودترین زمان بازنشستگی | نه زودتر از ۹ نوامبر ۲۰۲۷ |
Fable 5.2 روی Claude API، آمازون Bedrock، Claude Platform on AWS، هر دو سرویس گوگل کلاد و مایکروسافت Foundry با زیرساخت آنتروپیک عرضه شده است. Mythos 5.2 جز Claude Platform on AWS روی همین بسترها فهرست شده است. Fable 5.2 سقف نرخ جداگانه دارد و با سقف مشترک Fable 5.1 و Fable 5 جمع نمیشود؛ Mythos 5.2 اما با Mythos 5.1 و Mythos 5 یک سقف مشترک دارد. راهنمای مهاجرت اضافه میکند که سقف توکن Fable 5.2 در هر سطح کاربری از Opus 5.5 کمتر است؛ پس پیش از جابهجایی ترافیک، سهمیه را بررسی کنید.
مستندات قیمتگذاری نرخهای زیر را به دلار برای هر میلیون توکن ثبت کردهاند. قیمت Fable 5.2 و Mythos 5.2 یکی است.
| نوع توکن | Fable 5.2 | Fable 5.1 | Opus 5.5 |
|---|---|---|---|
| ورودی پایه | ۸ دلار | ۱۰ دلار | ۴ دلار |
| خروجی | ۴۰ دلار | ۵۰ دلار | ۲۰ دلار |
| خواندن حافظه نهان | ۰٫۲۰ دلار | ۰٫۲۵ دلار | ۰٫۲۰ دلار |
| نوشتن حافظه نهان پنجدقیقهای | ۱۰ دلار | ۱۲٫۵۰ دلار | ۵ دلار |
| نوشتن حافظه نهان یکساعته | ۱۶ دلار | ۲۰ دلار | ۸ دلار |
| ورودی و خروجی پردازش دستهای | ۴ و ۲۰ دلار | ۵ و ۲۵ دلار | ۲ و ۱۰ دلار |
| ورودی و خروجی حالت سریع | ۱۶ و ۸۰ دلار | — | ۸ و ۴۰ دلار |
نرخ خواندن حافظه نهان همچنان ۰٫۰۲۵ برابر قیمت پایه ورودی است، همان ضریب مدلهای ۵٫۱. چون قیمت پایه کم شده، این نرخ از ۰٫۲۵ به ۰٫۲۰ دلار رسیده و اکنون با نرخ Opus 5.5 برابر است. ورودی تازه و خروجی اما هنوز دو برابر Opus 5.5 قیمت دارند.
یک نوبت طولانی عامل را در نظر بگیرید: پیشوند ۲۰۰ هزار توکنی در حافظه نهان، ۱۰ هزار توکن ورودی تازه و ۵ هزار توکن خروجی، بدون نوشتن حافظه نهان، ابزار یا تلاش مجدد. با تعرفه رسمی، هزینه آن روی Fable 5.2 برابر ۰٫۳۲ دلار، روی Fable 5.1 برابر ۰٫۴۰ دلار و روی Opus 5.5 برابر ۰٫۱۸ دلار است. این مثال تعداد توکن را ثابت فرض میکند. در عمل تعداد توکنها برابر نیست؛ پیشفرض تلاش Fable برابر high و پیشفرض Opus 5.5 برابر medium است و هر مدل برای یک کار مقدار متفاوتی فکر میکند.
طبق مستند حالت سریع، این حالت سرعت تولید توکن خروجی را تا ۲٫۵ برابر بالا میبرد. بهبود در سرعت تولید است، نه زمان رسیدن نخستین توکن، و هزینه آن دو برابر نرخ عادی است. در مایکروسافت Foundry، حالت سریع استقرار جداگانهای با نام claude-fable-5-2-fast دارد. حالت سریع Mythos فقط برای سازمانهای عضو برنامههای احراز صلاحیت در دسترس است.
جدول زیر جدول اطلاعیه را با جدول 8.1.A کارت سیستم ترکیب میکند. جز در موارد ذکرشده، نتایج Fable با بیشترین سطح تلاش، تنظیم پیشفرض نمونهبرداری، پنج بار اجرا و حفاظتهای فعال تولید شدهاند. ردیف Terminal-Bench-Science از صفحه انتشار و بخش ۸٫۶ کارت آمده که در آن هر کار ده بار اجرا شده است.
| ارزیابی | Fable 5.2 | Fable 5.1 | Opus 5.5 | GPT-6 Astra |
|---|---|---|---|---|
| SWE-bench Pro | ۹۳٫۰٪ | ۸۱٫۲٪ | ۸۹٫۹٪ | — |
| FrontierCode 2.0 (بهترین سطح تلاش) | ۴۹٫۱٪ | ۳۲٫۴٪ | ۴۵٫۵٪ | ۴۲٫۸٪ |
| FrontierSWE v2 | ۶۹٫۹٪ | ۵۶٫۳٪ | ۶۲٫۳٪ | ۶۵٫۵٪ |
| Terminal-Bench-Science 0.1 | ۷۴٫۶٪ | ۵۲٫۶٪ | ۵۸٫۷٪ | ۶۸٫۱٪ |
| AutomationBench | ۵۱٫۴٪ | ۳۱٫۴٪ | ۴۲٫۵٪ | ۴۱٫۴٪ |
| شاخص کار از راه دور (RLI) | ۴۱٫۳٪ | ۱۷٫۹٪ | ۲۱٫۳٪ | ۲۰٫۸٪ |
| آزمون نهایی بشریت (HLE)، با ابزار | ۷۴٫۲٪ | ۶۵٫۶٪ | ۶۷٫۷٪ | ۵۷٫۲٪ |
| OSWorld 2.1 (مجموعه آفلاین، امتیاز جزئی) | ۸۹٫۳٪ | ۸۳٫۵٪ | ۸۷٫۲٪ | ۷۹٫۵٪ |
| Chartography، بدون ابزار | ۷۳٫۴٪ | ۴۴٫۸٪ | ۶۴٫۴٪ | ۷۱٫۰٪ |
| GDPval-AA v2.1 (Elo) | ۱۸۳۱ | ۱۷۶۳ | ۱۸۶۶ | ۱۵۸۴ |
| AA-Briefcase v1.1 (Elo) | ۱۷۸۵ | ۱۶۶۹ | ۱۸۰۰ | ۱۵۶۹ |
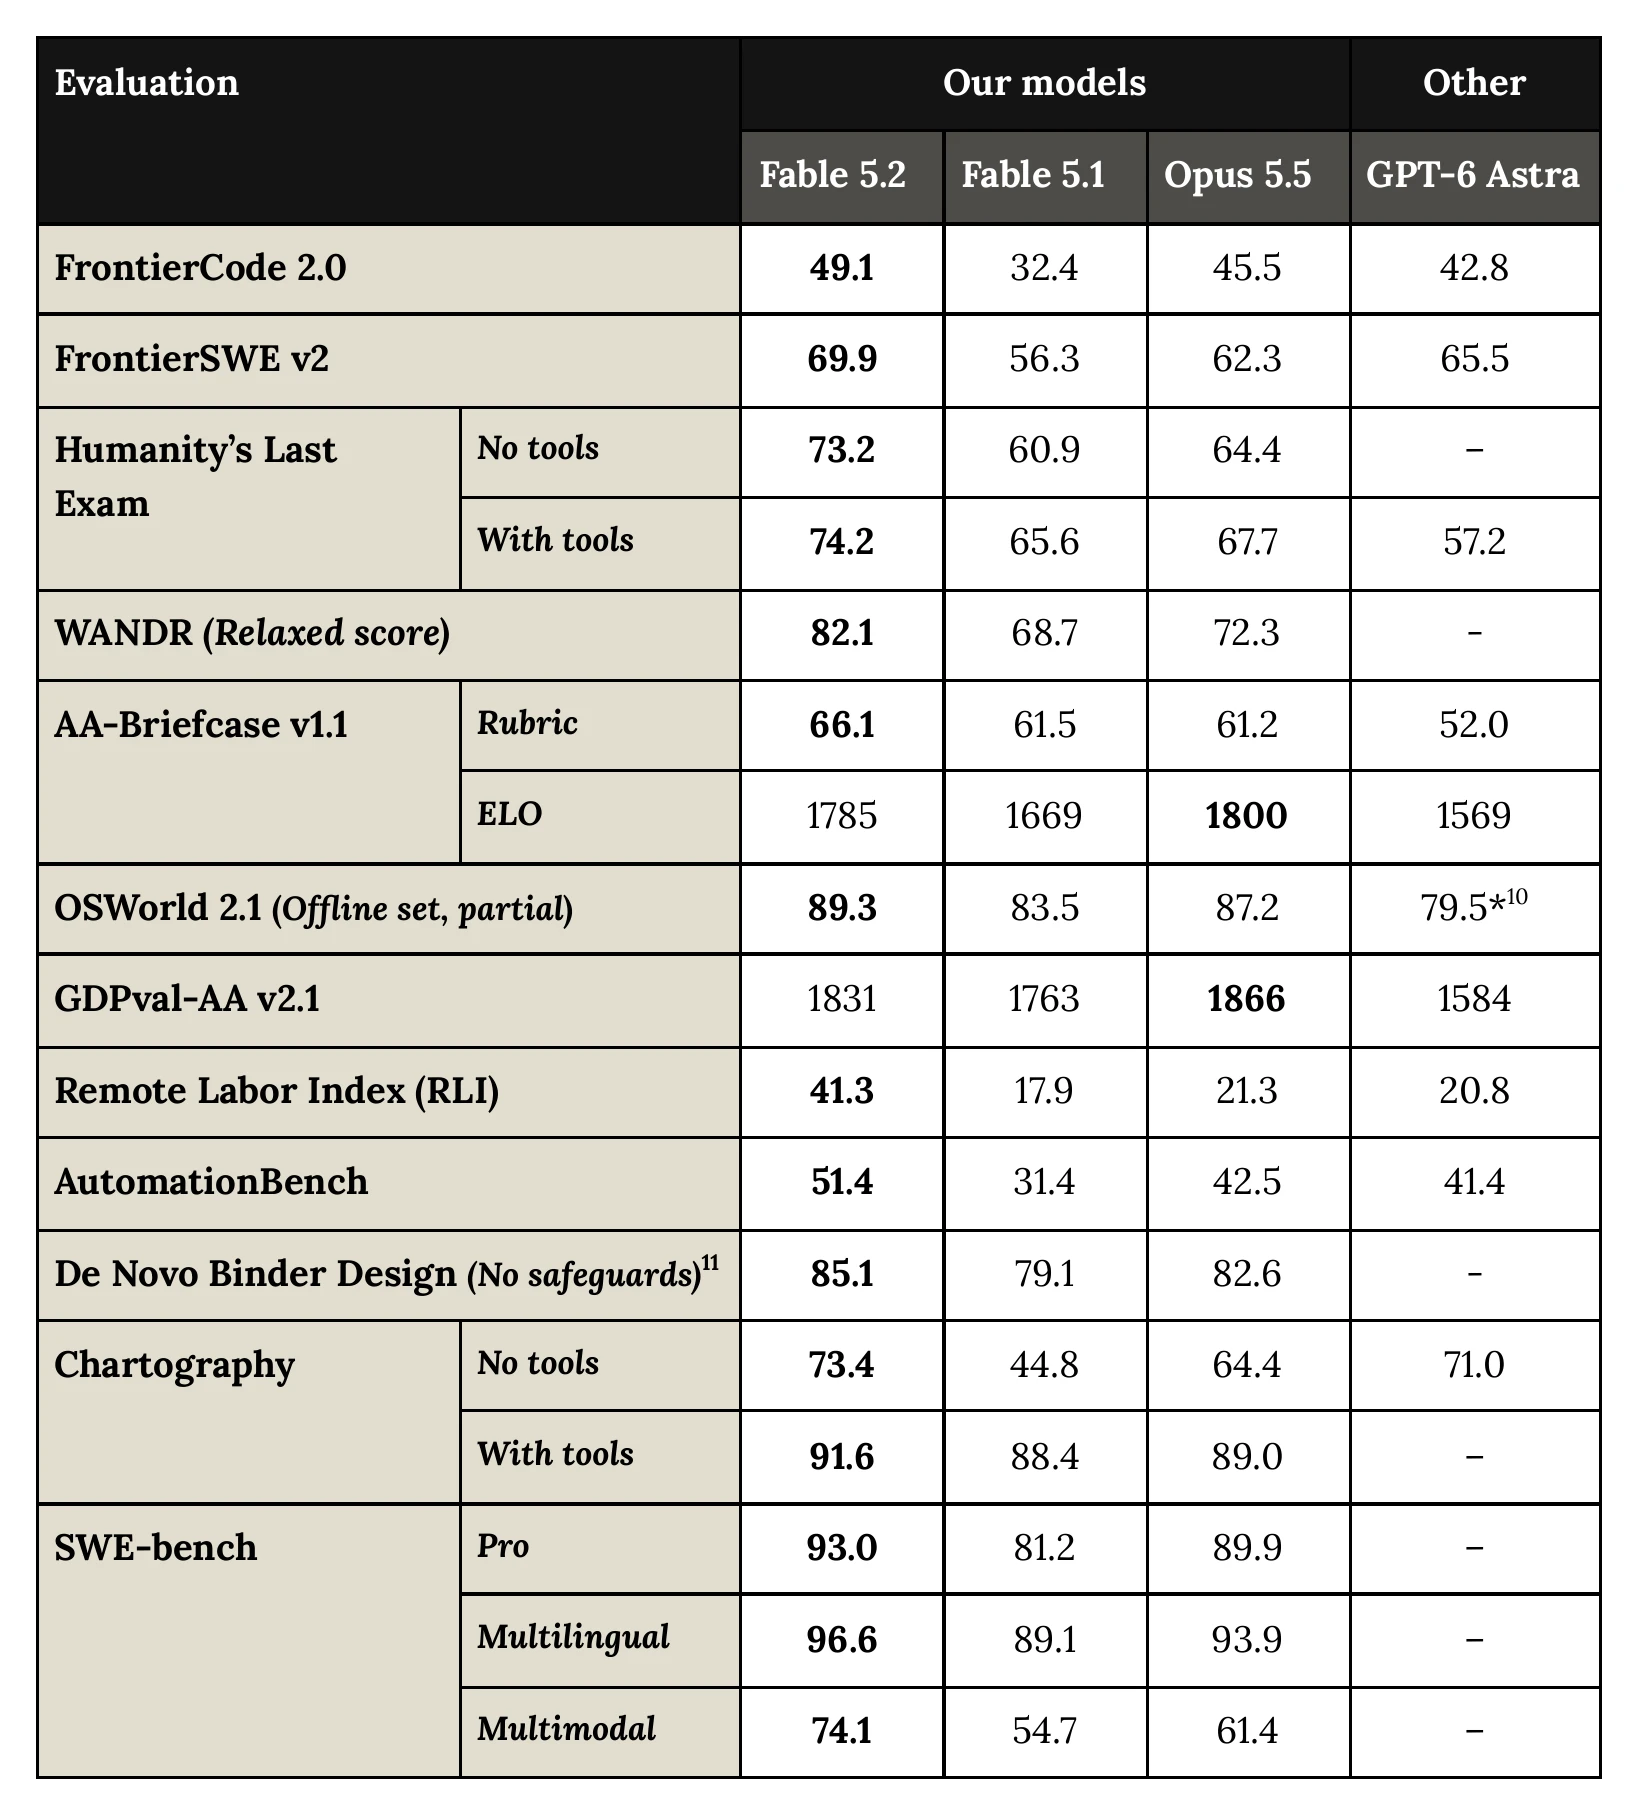 جدول 8.1.A از کارت سیستم Fable 5.2 و Mythos 5.2 آنتروپیک؛ مقایسه Fable 5.2 با Fable 5.1، Opus 5.5 و GPT-6 Astra.
شاهد دستاول: جدول 8.1.A، صفحه ۲۰۷ کارت سیستم. ردیف De Novo Binder Design که زیر ستونهای Fable چاپ شده، نتیجه Mythos 5.2 بدون حفاظت است؛ ردیف پایانی CVE Rediscovery از همین نوع در صفحه ۲۰۸ ادامه دارد. اینها اجرای انتشار سازندهاند، نه رتبهبندی مستقل.
سه شرط در خواندن جدول مهم است. نخست، FrontierCode بهترین سطح تلاش هر مدل را گزارش میکند: xhigh برای هر دو مدل Fable و max برای Opus 5.5 و GPT-6 Astra. شاخص RLI با تلاش پیشفرض اجرا شده است. دوم، اطلاعیه ستونی برای Gemini 4 Carbon دارد که در جدول خلاصه کارت سیستم نیست، و امتیاز ۵۳٫۹ درصدی Gemini در AutomationBench از ۵۱٫۴ درصد Fable 5.2 بالاتر است. سوم، ردیفهای امنیت سایبری و طراحی پروتئین در صفحه انتشار مربوط به Mythos 5.2 بدون حفاظت هستند. طبقهبندهای Fable 5.2 بیشتر کارهای امنیت سایبری را مسدود میکنند؛ پس این ردیفها توان یک حساب عمومی Fable را نشان نمیدهند.
بزرگترین جهشها در کارهای طولانی و قابل بررسی دیده میشوند. SWE-bench Pro نسبت به Fable 5.1، ۱۱٫۸ واحد بالا رفته است. شاخص RLI که میسنجد آیا یک پروژه آزادکاری دستکم همسطح یک متخصص انسانی انجام شده یا نه، از ۱۷٫۹ به ۴۱٫۳ درصد رسیده و بیش از دو برابر شده است. Terminal-Bench-Science نیز ۲۲ واحد افزایش دارد. تیمهایی که Fable را برای کار دانشی سندمحور ارزیابی میکنند باید توجه کنند که Opus 5.5 هنوز در هر دو امتیاز Elo جلوتر است.
در بخشهای عمیقتر کارت، Fable 5.2 در ProgramBench، آزمون بازسازی برنامه با زمینه طولانی، نیز از Opus 5.5 عقب است: ۸۵٫۶ درصد در برابر ۹۱٫۲ درصد. مدل در ۶۸ درصد کارها پیش از ارسال پاسخ، زمینهاش تمام شد. وقتی پوسته پس از هر گام مقدار زمینه باقیمانده را نشان داد، امتیاز به ۹۱٫۶ درصد رسید. درس این نتیجه به همان اندازه که درباره مدل است، درباره پوسته است: عامل طولانیمدت باید بودجه خودش را ببیند.
اطلاعیه آنتروپیک دقت را در برابر هزینه هر کار برای چند ارزیابی رسم میکند. در FrontierCode 2.0، Fable 5.2 با تلاش high امتیاز ۴۵٫۳ درصد میگیرد، تقریباً همسطح بهترین امتیاز ۴۵٫۵ درصدی Opus 5.5، با حدود نصف هزینه هر کار. در معیار جستوجوی WANDR از Perplexity، Fable با تلاش medium به بهترین امتیاز Opus 5.5 میرسد و هزینهاش حدود ۴۰ درصد آن است. در HLE با ابزار، Fable با تلاش low به بهترین امتیاز Opus 5.5 میرسد، با کمتر از یکدهم هزینه. در Chartography نیز Fable با medium امتیاز ۶۶٫۴ درصد میگیرد، در برابر ۶۴٫۴ درصد Opus 5.5 با max.
این مقایسهها یک تنظیم Fable را در برابر گرانترین تنظیم Opus 5.5 میگذارند. نشان میدهند مدل تازه میتواند همان امتیاز را با توکن کمتر بگیرد. نشان نمیدهند Fable در تلاش پیشفرض Opus از آن ارزانتر است. تصمیم مسیریابی به اندازهگیری هر دو مدل در همان سطح تلاشی نیاز دارد که سامانه تولیدی واقعاً به کار میبرد.
مستند سطح تلاش شروع با پیشفرض API یعنی high را توصیه میکند، چون بیشتر بهبود توانایی همانجا دیده میشود، و max را برای سنجش سقف توان نگه میدارد. راهنمای دستوردهی اضافه میکند که xhigh امتیاز کدنویسی داخلی را اندکی بالا برد اما توکن بسیار بیشتری مصرف کرد، و امتیاز Fable 5.2 با تلاش low نزدیک امتیاز Fable 5.1 در سطوح بالاتر بود. اپلیکیشنهای Claude و Claude Code بهطور پیشفرض با medium کار میکنند؛ پس نتیجهای که در اپلیکیشن میبینید لزوماً همان پیشفرض API نیست.
اطلاعیه چند پروژه پیش از انتشار را شرح میدهد. گروهی حدود هزارتایی از عاملهای Fable 5.2 اثبات قضیه آخر فرما را در ۳۰ ساعت در زبان Lean صوریسازی کردند. نخستین صوریسازی آنتروپیک با یک مدل پژوهشی منتشرنشده، پوسته اختصاصی و راهنمایی انسانی ۱۱ روز طول کشیده بود. Opus 5.5 در همان چیدمان هزارعاملی، ۲۶ درصد کار را در ۱۸ ساعت تمام کرد و تا ساعت ۳۰ پیشرفت چندانی نداشت. کارت سیستم اضافه میکند که این اجرا با نسخهای زودتر از مدل انجام شد و بر تعریفها و نتیجههای کوچکتر اثباتشده از صوریسازی قبلی بنا شد.
نمونههای دیگر Fable عبارتاند از: نمونه اولیه یک سیستمعامل که بیش از هزار عامل فرعی هماهنگ در هشت روز نوشتند؛ مهاجرت یک سرویس تولیدی از Python به Rust که اکنون حدود ۲۶ برابر سریعتر راهاندازی میشود؛ طراحی سه دستگاه الکترونیکی کارا با همکاری سازنده برد مدار Diode؛ و حل دو مسئله باز در فیزیک سیاهچالهها که بهصورت پیشچاپ منتشر شدهاند. Mythos 5.2 در زیستشناسی روشی برای پیشبینی ساختار پروتئین ارائه کرد که از ۳۴ کپسید ویروسی، ۲۸ مورد را دقیق مدل کرد. در شبیهسازی کنترل ربات RoboDojo، امتیاز Fable 5.2 در اجرای داخلی آنتروپیک ۶۴٫۹ درصد بود، در برابر ۲۹٫۸ درصد GPT-6 Astra و ۲۷٫۶ درصد Fable 5.1.
بیشتر این موارد یکبار اجرا شدهاند و سازنده آنها را انتخاب کرده است. نشان میدهند مدل با نظارت، پوسته قوی و بودجه محاسباتی بزرگ چه کاری را میتواند تمام کند. نرخ پذیرش کار در هر مخزن کد یا آزمایشگاهی نیستند. این نرخ را روی کارهای خودتان و با همان دروازههای شواهدی بسنجید که برای یک همکار انسانی میگذارید.
راهنمای تغییرات تازه چهار تغییر را فهرست میکند که میتوانند کد سالم را از کار بیندازند.
۱. بررسی پیشوند اکنون برای همه حسابها اجرا میشود. اگر هر چیزی پیش از یک بلوک تفکر Fable 5.2 تغییر کند، مانند دستور سیستم، آرایه ابزارها یا یک پیام قبلی، درخواستی که آن بلوک را برمیگرداند خطای ۴۰۰ با پیام The block is bound to a different conversation میگیرد. در Fable 5.1 فقط حسابهایی که از ۳۱ اوت ۲۰۲۶ به بعد ساخته شده بودند این خطا را میدیدند؛ پس حسابهای قدیمیتری که سابقه را ویرایش میکنند ممکن است تازه پس از مهاجرت دچار خطا شوند.
۲. فقط Fable 5.2 و Mythos 5.2 بلوکهای تفکر Fable 5.2 را میخوانند. Fable 5.2 بلوکهای مدلهای قبلی را میخواند، اما هیچ مدل دیگری بلوکهای آن را نمیخواند؛ از جمله Opus 5.5، Fable 5.1 و دو مدل جایگزین خود Fable 5.2، یعنی Opus 4.8 و Opus 5. API بلوکهای ناخوانا را بدون دریافت هزینه حذف میکند؛ پس نوبتی که به مدل جایگزین میرود موفق است، اما استدلال قبلی را ندارد.
۳. ابزار computer_20251124 خطای ۴۰۰ برمیگرداند، در همه بسترها جز آمازون Bedrock. بهجای آن از مجموعهابزار computer_toolset_20260801 استفاده کنید.
۴. ابزار مشاور به مشاور همسطح نیاز دارد. مجری Fable 5.2 یا Mythos 5.2 فقط Fable 5.2 یا Mythos 5.2 را بهعنوان مشاور میپذیرد. تغییر مدل مشاور ویرایش آرایه tools حساب میشود؛ پس آن را در گفتوگوهای تازه اعمال کنید.
چند قاعده از Fable 5.1 باقی مانده است: تفکر تطبیقی خاموش نمیشود، اجبار به ابزار خاص خطای ۴۰۰ میدهد، پیشنویس پاسخ دستیار پذیرفته نمیشود و پارامترهای temperature، top_p و top_k را باید حذف کرد. در سازمانهایی که کلید رمزنگاری را خودشان مدیریت میکنند، خروجی ساختیافته در دسترس نیست. هیچکدام از دو مدل از Priority Tier پشتیبانی نمیکنند. بلوکهای تفکر به حسابی که آنها را تولید کرده نیز وابستهاند؛ اگر گفتوگوی ذخیرهشده را از حساب دیگری بازپخش کنید، استدلال آن از دست میرود.
الگوی امن، سابقه فقطافزودنی است. system و tools را ثابت نگه دارید، فقط پیام اضافه کنید و هر نوبت دستیار را دقیقاً همانطور که دریافت شده برگردانید. برای تغییر دستور یا ابزار در میانه گفتوگو، از پیامهای سیستمی میانه گفتوگو و تغییر ابزار در حالت بتا استفاده کنید. برای کوتاهکردن سابقه طولانی، فشردهسازی بههنگام درخواست یا ویرایش زمینه را به کار ببرید. تنظیم drop_block از خطای ۴۰۰ جلوگیری میکند، اما راهنما آن را راهحل موقت میداند، چون حذف استدلال میتواند توکن خروجی را بالا ببرد.
راهنمای دستوردهی رفتارهایی را ثبت میکند که بدون تغییر کد ظاهر میشوند. جملهای مانند «مستقیم و بدون تأمل پاسخ بده» دیگر در medium و بالاتر جلوی تفکر را نمیگیرد. در high مدل پیش از تقریباً هر پاسخی فکر میکند، حتی پاسخ به یک سلام. بنابراین درخواستی با max_tokens کوچک ممکن است پس از بلوک تفکر و بدون هیچ متنی تمام شود.
در کارهای طولانی با تلاش low و medium، مدل گاهی نوبت را با فهرست کارهای باقیمانده یا پیشنهاد ادامه کار میبندد. دستور پیشنهادی آنتروپیک برای «تمامکردن کار»، در بازپخش جلسههای کدنویسی این پایانهای زودهنگام را نصف کرد، اما توکن خروجی را حدود ۳۰ درصد بالا برد. آنچه دستور درباره مالکیت کد میگوید نیز مهم است. وقتی دستور میگفت این کد متعلق به خود مدل است، مدل در حدود نیمی از کارهای کوچک کدنویسی کد تکراری را ادغام کرد؛ بدون آن جمله این نرخ کمتر از یکدهم بود. در عوض حدود ۱٫۵ برابر توکن خروجی مصرف کرد و در یک تلاش از هر شش تا ده تلاش، رفتار یک قابلیت موجود را تغییر داد.
دو مشاهده برای سامانههای چندعاملی مهم است. در xhigh و max، Fable 5.2 گاهی عاملهای فرعی را برای بازبینی کار خودش راه میاندازد و این عاملها میتوانند سهم بزرگی از هزینه جلسه داشته باشند. یادداشتها و قواعد محتاطانه نیز در فایلهای حافظه و پیامهای میان عاملها انباشته میشوند. در یکی از آزمونهای آنتروپیک، یک قاعده تأیید درباره پیامدادن به افراد بیرون از گفتوگو باعث شد مدل تقریباً نیمی از درخواستهای عادی خود به همکاران را نگه دارد. پیش از مهاجرت، دستورهای بهارثرسیده را بازبینی کنید و دقیقاً بنویسید کدام اقدامها تأیید لازم دارند.
طبقهبندهای Fable 5.2 فعالیت سایبری پرخطر، از جمله آزمون نفوذ، تولید اکسپلویت و کار روی آسیبپذیری فایلهای باینری، و بیشتر کارهای پژوهشی زیستشناسی را مسدود میکنند. در محصولات آنتروپیک، درخواست مسدودشده در حوزه سایبری از Opus 4.8 و در زیستشناسی از Opus 5 پاسخ میگیرد. آنتروپیک در آزمون اولیه در claude.ai، Claude Code و Cowork حدود ۵۵ درصد مسدودسازی کمتر از Fable 5.1 دید: حدود ۶۰ درصد کمتر در امنیت سایبری و ۴۰ درصد کمتر در زیستشناسی.
در API، درخواست ردشده پاسخ HTTP 200 با stop_reason: "refusal" و یکی از این دستهها را برمیگرداند: cyber، bio، frontier_llm، reasoning_extraction یا general_harms. راهنمای رد درخواست و مدل جایگزین سازوکار جایگزینی سمت سرور را شرح میدهد که در حالت بتاست و برای Fable 5.2 فقط Opus 4.8 و Opus 5 را بهعنوان مقصد مجاز میداند. رد درخواست در دسته reasoning_extraction مدل جایگزین ندارد. ثبت کنید هر پاسخ را کدام مدل داده است؛ درخواست مسدودشدهای که به مدل جایگزین میرود ممکن است پاسخی روان از مدلی دیگر و قدیمیتر بگیرد.
آنتروپیک همچنین در آموزش، تواناییهای پژوهشیای را محدود کرده که میتوانند مستقیماً توسعه هوش مصنوعی را شتاب دهند. به گفته آن، Fable 5.2 در حوزههایی مانند بهینهسازی کرنل شتابدهنده و معماری مدل زبانی تقریباً همسطح Opus 5.5 است و مجموعه کوچکی از این موضوعها بهطور شفاف به Opus 5 سپرده میشوند. روشهای ضدتقطیر آن، دادهای را که تقطیرکنندگان جمع میکنند ۹۰ تا ۹۹ درصد کاهش دادهاند و تفکر حفظشده اکنون برای همه حسابها اعمال میشود.
هر دو مدل نگهداری ۳۰روزه داده را الزامی میکنند و بدون مجوز صریح آنتروپیک در قرارداد «عدم نگهداری داده» در دسترس نیستند. بدون این نگهداری، هر درخواست Claude API خطای ۴۰۰ میگیرد. سرویس Enterprise Frontier Safeguards که اکنون در بتای خصوصی است، پایش ایمنی را روی درخواستها و پاسخهایی اجرا میکند که در زیرساخت خود مشتری ذخیره شدهاند، و مشتریان واجد شرایط میتوانند در دوره راهاندازی آن، عدم نگهداری داده را حفظ کنند. تیمهایی که داده محرمانه یا مشمول مقررات دارند، باید پیش از بارگذاری مجموعه ارزیابی، شرایط نگهداری داده را روشن کنند.
خود آنتروپیک توصیه میکند بیشتر کارهای کدنویسی و دانشی را با Opus 5.5 شروع کنید و فقط وقتی کار واقعاً لازم دارد به Fable یا Mythos بروید. راهنمای تغییرات تازه هم همین را تکرار میکند: وقتی ارزیابیهای شما روی Opus با تلاش بالاتر هنوز کافی نیست، مهاجرت کنید. Fable 5.2 میتواند نقش مشاوری را داشته باشد که مدلهای ارزانتر با آن مشورت میکنند، یا نقش هماهنگکنندهای که گامهای سادهتر را واگذار میکند.
بنابراین یک طرح مسیریابی عملی، کارهای دشوار، طولانی و قابل بررسی را به Fable میفرستد و ترافیک عادی را روی Opus، Sonnet یا Haiku نگه میدارد. هزینه هر کار پذیرفتهشده را بسنجید، نه هزینه هر توکن، و زمان بازبین، اجراهای ناموفق و پاسخهای مدل جایگزین را هم در آن بگنجانید. تحلیل انتشار Opus 5.5 مدلی را بررسی میکند که همچنان توصیه پیشفرض است.
مستندات انتشار هیچ نتیجهای ویژه زبان فارسی گزارش نمیکنند و ژرفایآی نیز Fable 5.2 را به فارسی آزمایش نکرده است. پیش از استفاده برای اسناد فارسی، مجموعه پذیرشی با متن ترکیبی فارسی و انگلیسی، تاریخ شمسی، مبالغ ریال و تومان، یکسانسازی رقمها و ارجاع در اسناد راستبهچپ بسازید. درستی واقعیتها را جدا از روانی نثر بسنجید.
با یک بسته آزمون قابل بازپخش شروع کنید: یک تغییر کد همراه آزمون، یک صفحهگسترده یا گزارش با اعداد قابل بررسی، یک جریان کاری کار با رایانه یا API، و یک دستور که متن نامطمئن چسباندهشده دارد. ثبت کنید کدام مدل پاسخ داد، سطح تلاش، نسخه پوسته، نرخ برخورد حافظه نهان، توکنها، زمان اجرا و اینکه بازبین نتیجه را پذیرفت یا نه. فقط دسته کارهایی را گسترش دهید که در آنها Fable هزینه هر نتیجه پذیرفتهشده را نسبت به مسیر فعلی بهتر میکند. ادغام کد، استقرار، پرداخت و تغییر مجوز را پشت تأیید صریح انسانی نگه دارید.
هایکو ۵٫۵ با زمینه یکمیلیونی و قیمت کمتر عرضه شد. مرز ۱۰۰ هزار توکن، سطح استدلال و تغییرات API تعیین میکنند صرفهجویی واقعی تیمها چقدر باشد.
ادامه مطلب
قیمت خواندن حافظه نهان سونت ۵٫۵ در ۷ اکتبر کاهش یافت. هزینه کار، شواهد بازبینی کد، تغییرات API و موارد انتخاب اوپوس ۵٫۵ را بررسی میکنیم.
ادامه مطلب
اوپوس ۵٫۵ تعرفه ورودی و خروجی را کاهش داده است. نتایج آزمونها، هزینه واقعی، چهار تغییر ناسازگار در API و محدودیتهای تازه را بررسی میکنیم.
ادامه مطلباگر این مطلب به فرایندی واقعی در سازمان شما مربوط است، از صفحه خدمات شروع کنید یا با ما تماس بگیرید.