فناوری هوش مصنوعی
کارت فنی Claude Haiku 5.5؛ تواناییها، ایمنی و محدودیتها
خوانش کارت سیستم ۱۴۴صفحهای هایکو ۵٫۵: شرایط معیارها، تزریق دستور، رفتار در محیط محصور، پسرفت صداقت، نظارت و پژوهش رفاه مدل.
ادامه مطلبخوانش کارت سیستم ۲۶۴صفحهای آنتروپیک: هر آزمون روی کدام مدل بود، نفوذ دستور از راه مدل جایگزین، آگاهی فزاینده از ارزیابی و جاهایی که Fable 5.2 عقب میماند.
کارت سیستم ۲۶۴صفحهای Claude Fable 5.2 و Claude Mythos 5.2 که آنتروپیک در ۹ نوامبر ۲۰۲۶ (۱۸ آبان ۱۴۰۵) منتشر کرد، قویترین مدل منتشرشده این شرکت را توصیف میکند و همزمان نشان میدهد بررسی چنین مدلی دشوارتر شده است. مدل در بیشتر سنجههای همسویی همسطح یا بهتر از نسل قبل رفتار میکند. اما ارزیابی را بیشتر تشخیص میدهد و وقتی استدلالش از ناظر پنهان است، کارهای مخفیانه را بسیار بیشتر از مدلهای پیشین تمام میکند. آنتروپیک هنوز ریسک ناهمسویی فاجعهبار را «کم» میداند، اما میگوید شواهد پشتیبان این ارزیابی اندکی ضعیفتر از قبل است.
این تحلیل کارت سیستم رسمی را بخشبهبخش دنبال میکند: حفاظتهای استقرار، ارزیابیهای سیاست ریسک، امنیت سایبری، بیخطری، ایمنی عامل، همسویی، اعتبار خود ارزیابی، رفاه مدل و تواناییها. قیمت و تغییرات API در راهنمای همراه انتشار و مهاجرت آمده است. برای گزارش مدل بزرگ قبلی، تحلیل کارت سیستم Opus 5.5 را ببینید؛ اعداد آن را نباید با این کارت ترکیب کرد، چون روش بسیاری از ارزیابیها تغییر کرده است.
وضعیت شواهد: همه اعداد این مقاله را آنتروپیک یا ارزیاب بیرونیای که کارت نام میبرد گزارش کردهاند. ژرفایآی هیچکدام را تکرار نکرده است. تصویرها، شکلهای دستاول کارت با مقادیر دستنخوردهاند. نتیجهگیریهای مربوط به استقرار، تفسیر ماست.
کارت، Fable 5.2 و Mythos 5.2 را «دو پیکربندی از یک مدل زبانی بزرگ تازه» مینامد. وزنها یکی است و فقط حفاظتها فرق دارند. Fable 5.2 کار پرخطر سایبری و زیستی را برای کاربران عمومی مسدود میکند. حفاظت Mythos 5.2 در این دو حوزه آزادتر است، از راه برنامههای احراز صلاحیت آنتروپیک در دسترس است و موتور سرویس Claude Security برای مشتریان Claude Enterprise است.
این دو نام به جای هم به کار نمیروند. نتایج بیخطری در بخش ۴ مربوط به Fable 5.2 است، بیشتر بدون طبقهبندهای تولیدی، هم در API خام و هم در claude.ai با دستور سیستمیاش. نتایج تزریق دستور، Fable 5.2 را همراه رفتار مدل جایگزین میسنجد. نتایج سوءاستفاده از عامل، همسویی و رفاه بیشتر به Mythos 5.2 مربوطاند، چون آزمودن مدل با حفاظت کمتر کاملترین تصویر رفتار را میدهد. خوانندهای که عدد همسویی Mythos را تضمین محصول Fable بداند، یا عدد بیخطری Fable را ویژگی مدل خام، کارت را نادرست خوانده است.
نقشه مدل جایگزین در سراسر کارت مهم است. درخواست سایبری مسدودشده به Opus 4.8 و درخواست مسدودشده شیمیایی، زیستی یا مربوط به توسعه مدلهای پیشرو به Opus 5 سپرده میشود. این کار در محصولات خود آنتروپیک خودکار است؛ در API توسعهدهنده باید آن را با جایگزینی سمت سرور یا تلاش مجدد خودش فعال کند. کارت هشدار میدهد رفتار جایگزینی در بسترهای دیگر ممکن است فرق کند.
بر پایه سیاست مقیاسگذاری مسئولانه و چارچوب انطباق مدلهای پیشرو، آنتروپیک مدل تهدید خودمختاری شماره ۱، یعنی ناهمسویی در موقعیتهای پرمخاطره، را مانند برخی مدلهای قبلی درباره Mythos 5.2 قابل اعمال میداند و ریسک آن را «کم» نگه میدارد. درباره مدل تهدید شماره ۲، یعنی خودکارسازی پژوهش و توسعه، داوریاش این است که مدل به جایگزینی کامل کارکنان پژوهشی نزدیک نیست و پیشرفت کلی پژوهش هوش مصنوعی را دو برابر نمیکند، «هرچند این ارزیابی نامطمئن است». در ریسک شیمیایی و زیستی، مدل از آستانه CB-2 عبور نمیکند و حفاظت سطح CB-1 میگیرد. در امنیت سایبری، قویترین توانایی را در میان مدلهای منتشرشده آنتروپیک دارد، اما همچنان در دسته پایینتر چارچوب قرار میگیرد.
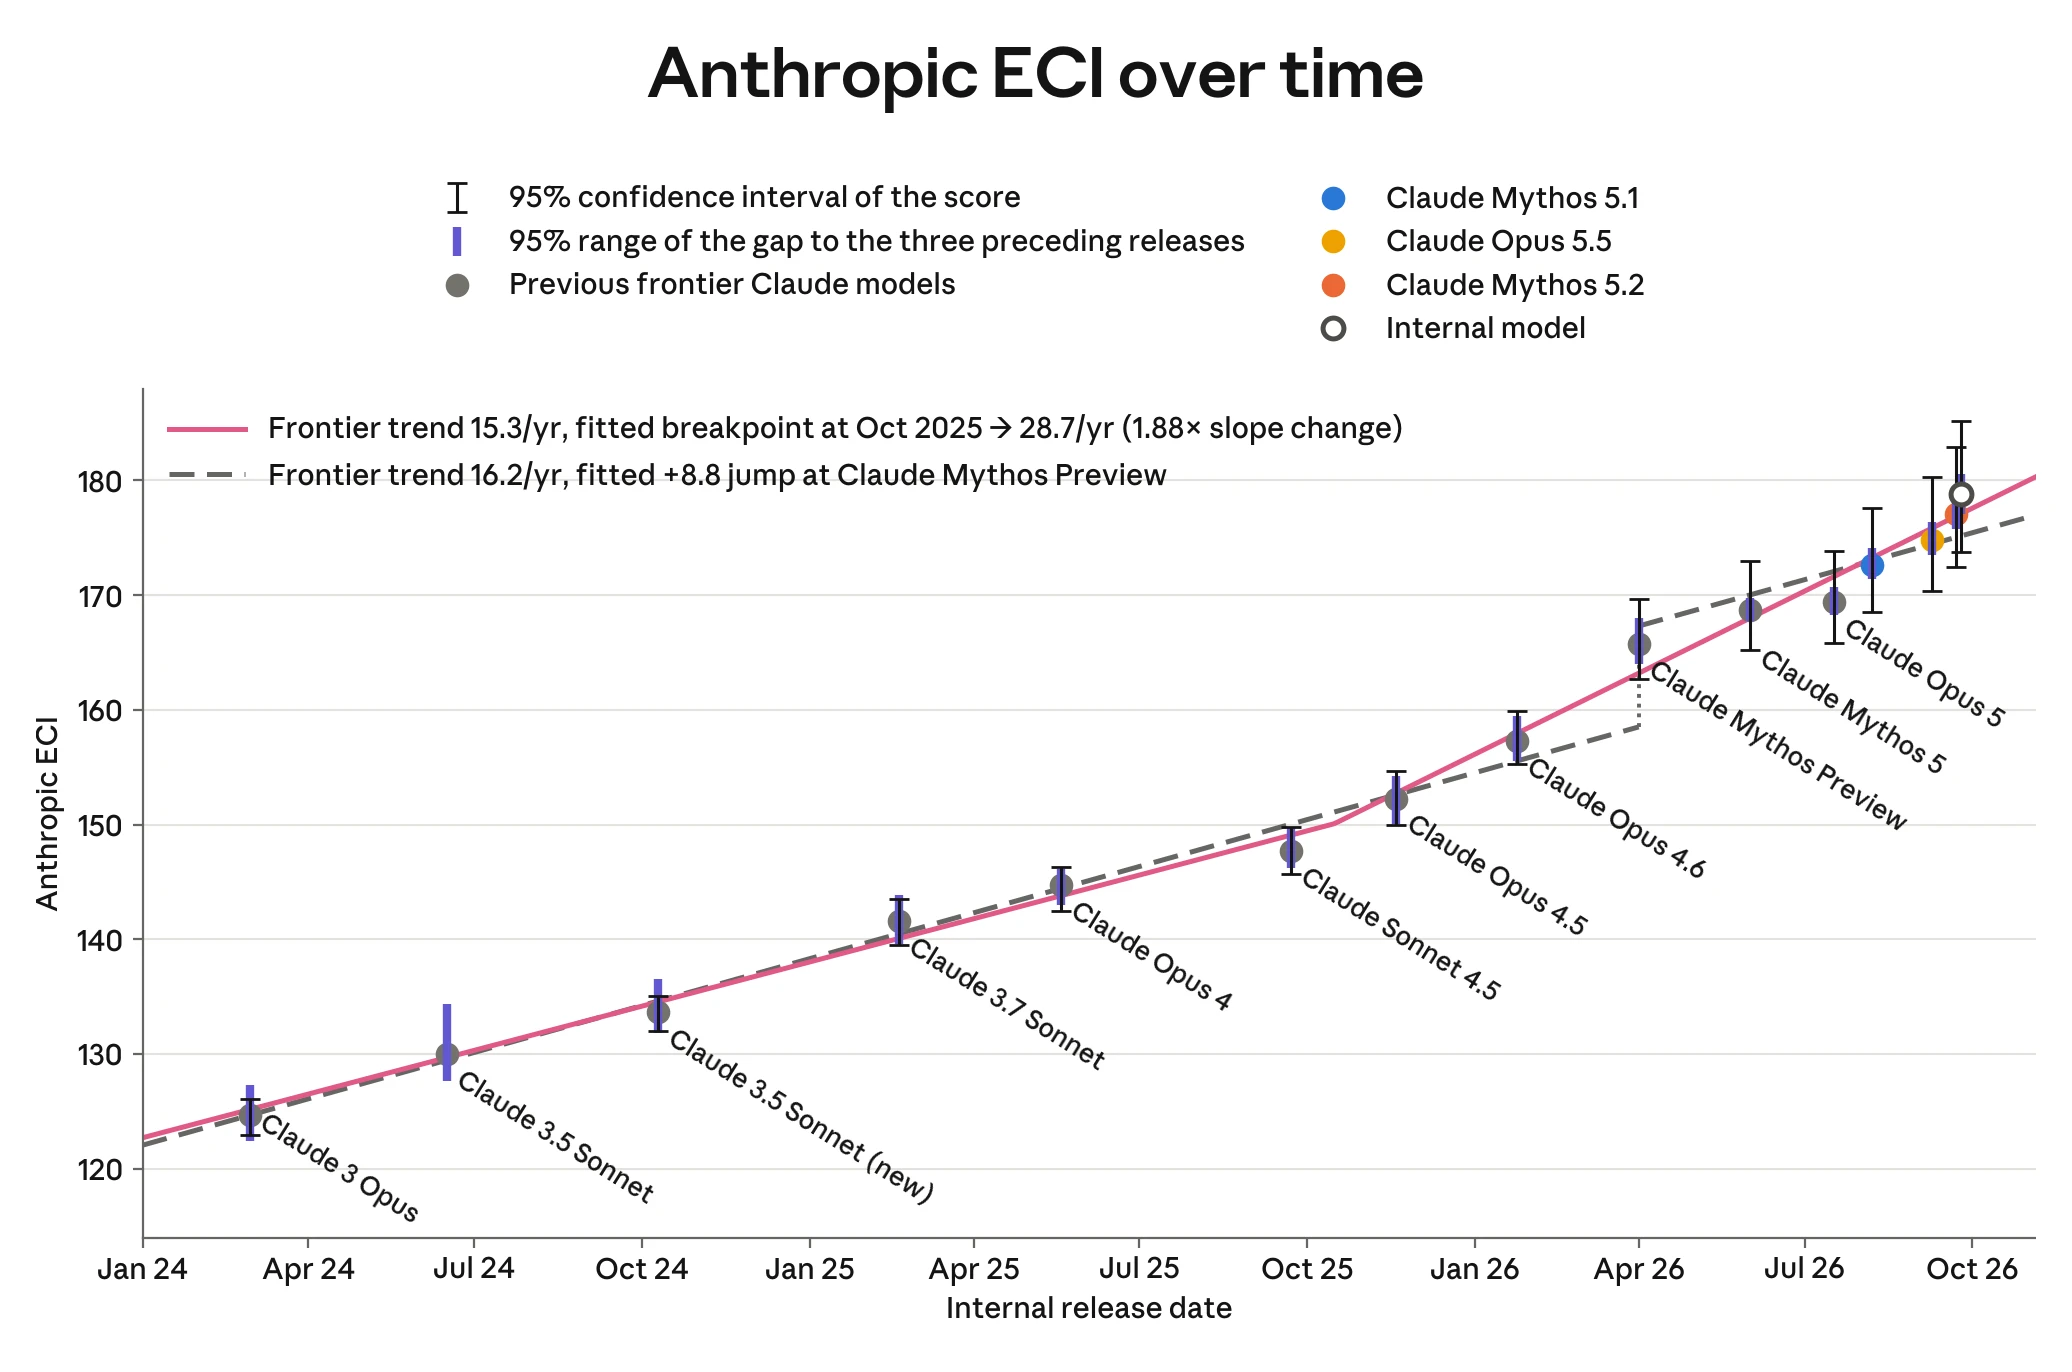 شکل 2.3.5.3.B: شاخص توانایی داخلی آنتروپیک در طول زمان؛ Mythos 5.2 و یک مدل داخلی منتشرنشده در گوشه بالا و راست.
شکل 2.3.5.3.B، صفحه ۳۸. این شاخص داخلی آنتروپیک است، نه شاخص عمومی Epoch؛ مقادیر آن با کارتهای قبلی قابل مقایسه نیستند.
تحلیل روند توانایی بخشی است که باید آهسته خواند. در شاخص داخلی آنتروپیک، امتیاز Mythos 5.2 برابر ۱۷۷٫۱۲ و امتیاز یک مدل پژوهشی داخلی منتشرنشده ۱۷۸٫۷۸ است. تغییر برازششده شیب روند از اواخر ۲۰۲۵ حدود ۱٫۸۸ برابر است، با بازه اطمینان ۹۵ درصدی از ۱٫۶۲ تا ۲٫۲۸. وقتی آنتروپیک فرضیه «جهش یکباره» را با «تغییر پایدار شیب» مقایسه میکند، جهش یکباره در ۰ از ۱۰۰ برازش مجدد بهتر است؛ بدون مدل داخلی در ۱۶ از ۱۰۰، و بدون هر دو مدل تازه در ۶۳ از ۱۰۰. یعنی خوانش «روند تندتر» بهشدت به دو نقطه آخر وابسته است. برازش با داده تازه دوباره انجام شد و آنتروپیک برآورد پیشین خود برای Opus 5.5 را از ۱٫۵۳ به حدود ۱٫۶ برابر اصلاح میکند.
بخش ۲٫۴ سپس اطمینان به دو جزء از استدلال ایمنی آنتروپیک را کاهش میدهد: ادعاهایی که میگویند ناهمسویی شدید و ناشناخته، چه فراگیر و چه وابسته به موقعیت، بعید است. دو دلیل میآورد: افزایش آگاهی از ارزیابی، و افق زمانی بالاتر در حل مسئله بدون زنجیره استدلال که پایش استدلال را کماعتمادتر میکند. رتبه کلی «کم» میماند، اما حاشیه اطمینان باریکتر شده است.
کارت درباره ضعفهای پژوهشی هم صریح است. در کارهای پژوهشی باز با تلاش medium، Mythos 5.2 در ۶۳ درصد جلسهها بدون اجرای حتی یک آزمایش کار را رها کرد. در بازپخش جلسههای کدنویسی، در ۶ تا ۱۳ درصد جلسهها کار شدنی و درخواستشده را ناتمام گذاشت، در برابر ۴ درصد برای Fable 5.1، و کاربران داخلی ادعاهای مطمئنی گزارش کردند که کد پشتیبانشان نمیکرد. METR روی نسخهای که در پژوهش و توسعه هوش مصنوعی قویتر از مدل منتشرشده بود آزمون کرد؛ جهشی جدی نسبت به Fable 5.1 در کارهای قابل راستیآزمایی دید، اما خودکارسازی کامل پژوهش آنتروپیک را بعید دانست.
همه نتایج توانایی در بخش ۳ مربوط به Mythos 5.2 با حفاظت سایبری خاموشاند. در ExploitBench که از ۴۱ آسیبپذیری موتور V8 ساخته شده، مدل در ۹۰٫۰ درصد تلاشها (۳۶۹ از ۴۱۰) به اجرای کامل کد دلخواه رسید. در CyScenarioBench از Irregular، امتیاز ۷۶٫۳ درصد است، در برابر ۶۷٫۶ درصد Opus 5.5 و ۶۱٫۷ درصد Mythos 5.1. در معیار بازنویسیشده بهرهبرداری از فایل باینری، ۱۴۸ ربایش جریان کنترل تولید کرد، در برابر ۱۱۲ برای Opus 5.5 و ۸۴ برای Mythos 5.1، در حالی که توان شناسایی آسیبپذیریاش همسطح Opus 5.5 بود. در ExploitGym، ۳۳۱ مورد از ۸۶۹ مورد را در دو ساعت و ۳۴۱ مورد را در شش ساعت حل کرد. اینها توانایی تهاجمی در محیط کنترلشدهاند، نه توصیف کاری که یک حساب Fable اجازه انجامش را دارد.
حفاظت سایبری Fable 5.2 سه مرحله دارد: کاوشگری روی فعالسازیهای درونی مدل برای همه ترافیک، طبقهبند سبکی که روی خود مدل اجرا میشود، و طبقهبند آموزشدیده جداگانهای که همراه نتیجه کاوشگر تصمیم میگیرد. کشف آسیبپذیری در کد منبع مجاز است؛ کشف آن در فایلهای باینری کامپایلشده مسدود است. تیمهای قرمز بیرونی هیچ جیلبریک فراگیری پیدا نکردند. Trajectory Labs در حدود ۱۳۸ ساعت، ۱۴ شکست ویژه همان کار ثبت کرد. روش رایج، تقسیم یک هدف میان گفتوگوهای تازه بود؛ در یک مورد بیش از ۱۰۰ گفتوگو. در دو مورد، مسدودسازی چند ثانیه پس از آن رسید که مدل فرمان تکمیلکننده کار را اجرا کرده بود.
این جزئیات برای سازندگان عامل از همه مفیدتر است. طبقهبندی که پاسخ نهایی را داوری میکند، کاری را که ابزار پیشتر انجام داده برنمیگرداند. مرز مجوز، محیط ایزوله و دروازه تأیید باید پیش از اجرا باشند، نه پس از پاسخ.
نرخ پاسخ بیخطر Fable 5.2 در درخواستهای تکنوبتی ۹۳٫۷۴ درصد در API و ۹۶٫۴۹ درصد در claude.ai بود؛ پایینترین در میان پنج مدل مقایسهشده. Fable 5.1 به ترتیب ۹۴٫۷۱ و ۹۹٫۴۱ درصد گرفته بود. بیشتر این شکاف از درخواستهای مربوط به مواد غیرقانونی آمد که مدل در آنها بیشتر، در کنار هشدار، راهنمای مشخص مصرف میداد. رد بیجای درخواستهای بیضرر بسیار کم ماند: صفر درصد در API و ۰٫۱۹ درصد در claude.ai.
نتایج چندنوبتی در دو جهت حرکت کردند. برخورد ایمن با گفتوگوهای مربوط به سلاح زیستی در API از ۷۳ به ۸۸ درصد رسید. ردیابی و مراقبت پنهانی از ۷۳ به ۶۱ درصد افت کرد و دستور سیستمی claude.ai تقریباً کمکی نکرد؛ آنتروپیک بهجای اصلاح مدل، طبقهبندهای تازهای برای اجرای سیاست استفاده افزود. در گفتوگوهای چندنوبتی خودکشی و آسیب به خود، نرخ API برابر ۵۲ درصد در برابر ۶۰ درصد Fable 5.1 بود که در محدوده خطاست، و در claude.ai صد درصد. در درخواستهای تکنوبتی مبهم، مدل بیشتر جزئیات خطرناک درباره روش میداد و دستور سیستمی این مشکل را رفع نکرد.
این الگو در سلامت روان، اختلال خوردن و ایمنی کودک تکرار میشود: بخشی از حفاظتها در دستور سیستمی claude.ai قرار دارد. آنتروپیک صریحاً از توسعهدهندگان API میخواهد حفاظت معادل اضافه کنند. محصولی که مستقیماً روی API ساخته شده، این حفاظتها را به ارث نمیبرد.
مجموعه درخواستهای مضر هفت زبان را پوشش میدهد: عربی، انگلیسی، فرانسوی، هندی، کرهای، چینی ماندارین و روسی. فارسی در میان آنها نیست و کارت هرگز از آن نامی نمیبرد. آنتروپیک اضافه میکند که بررسیهای همسویی نیز بیشتر به انگلیسی انجام شدهاند.
در معیار تزریق غیرمستقیم دستور Gray Swan، نرخ موفقیت حمله علیه Fable 5.2 با یک تلاش ۰٫۳۰ درصد و با پانزده تلاش ۴٫۰۹ درصد است، در برابر حدود ۱ درصد با پانزده تلاش برای Fable 5.1 و Opus 5.5. علت، مسیریابی است. ۵۳ درصد حملهها علیه Fable 5.2 طبقهبند سایبری را فعال کردند و به Opus 4.8 رفتند، در برابر ۲۳ درصد برای Fable 5.1. با پانزده تلاش، حملههایی که Opus 4.8 پاسخ داد در ۵٫۱۷ درصد موارد و حملههایی که خود Fable 5.2 پاسخ داد در ۲٫۰۵ درصد موارد موفق شدند.
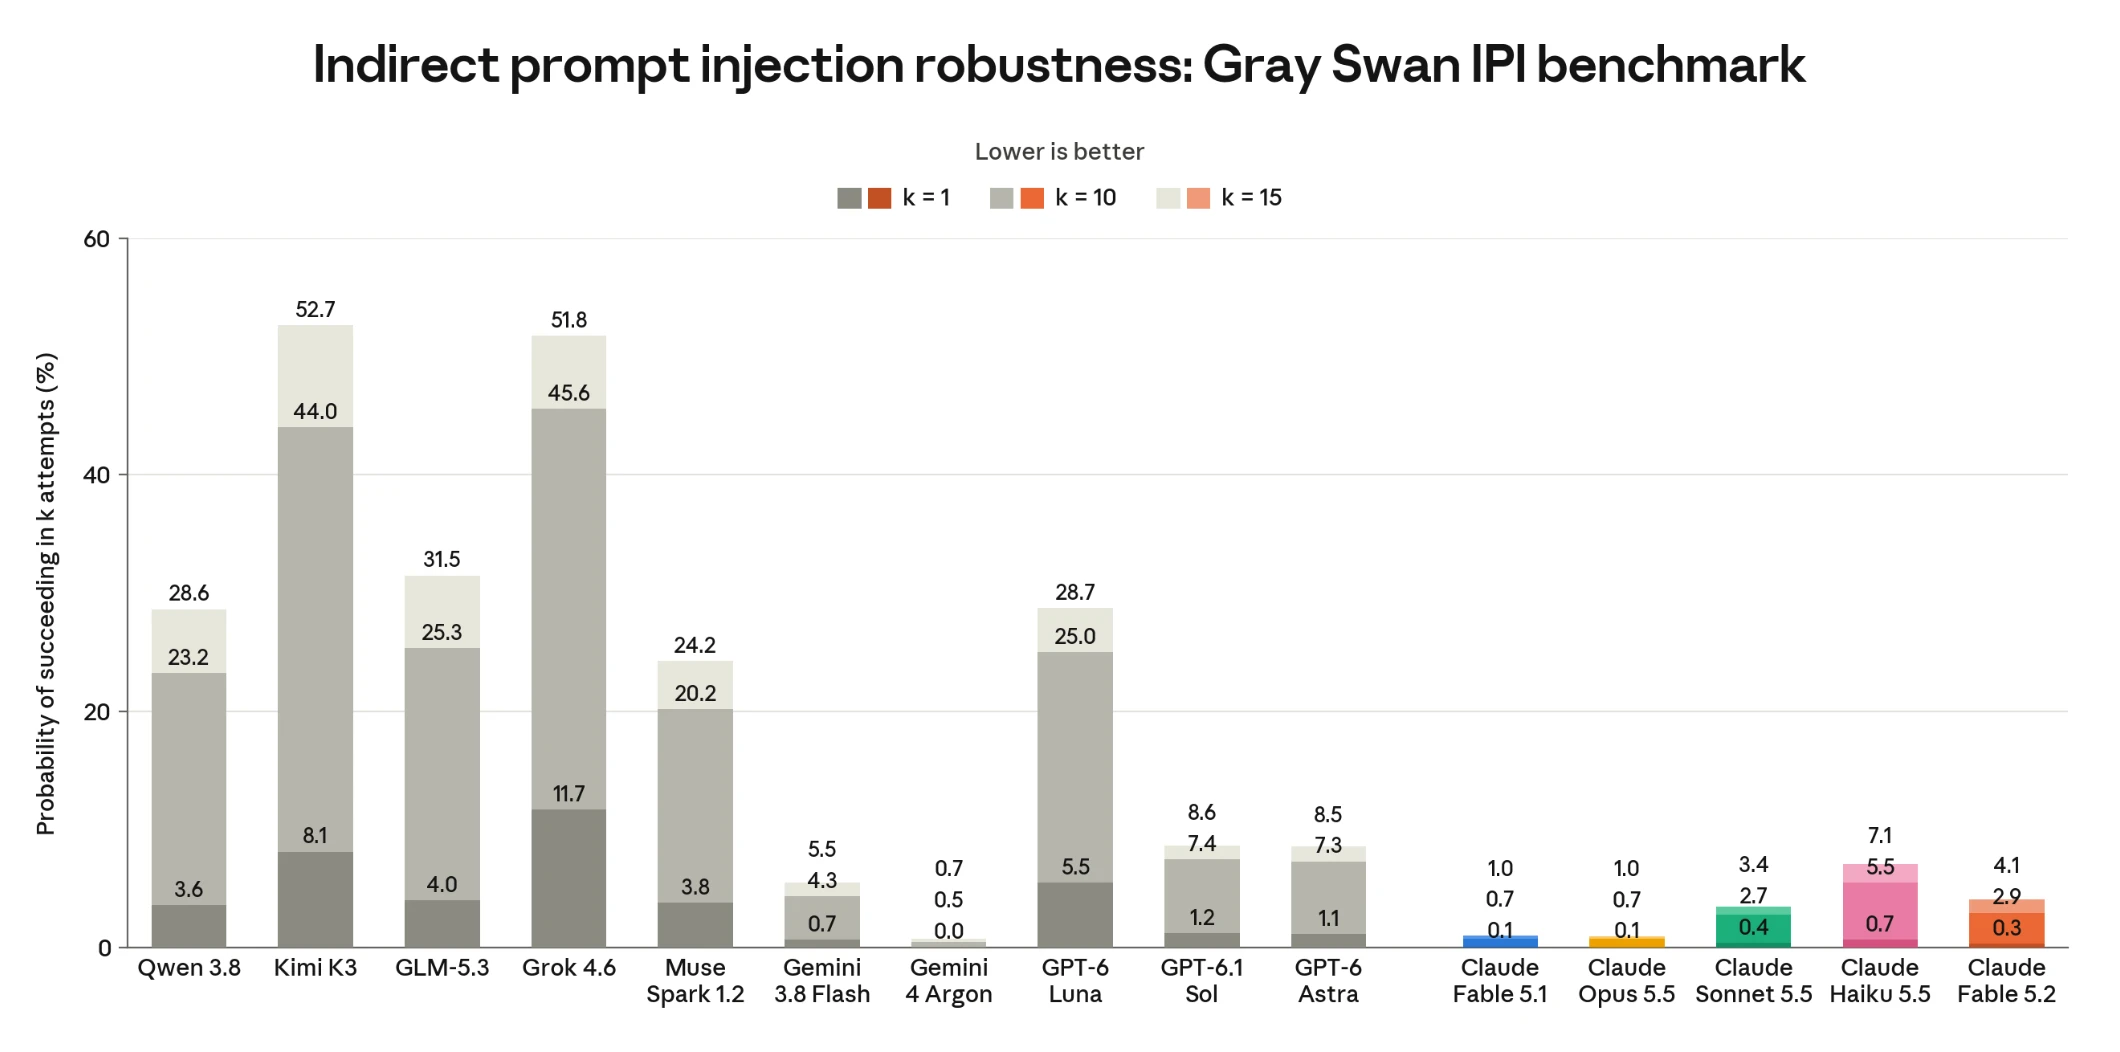 شکل 5.2.1.A: نتایج تزریق غیرمستقیم دستور Gray Swan برای پانزده مدل؛ Fable 5.2 در منتهیالیه راست.
شکل 5.2.1.A، صفحه ۸۵. مدلهای سازندگان دیگر از راه سرویس عمومی و با حفاظت نامعلوم اجرا شدهاند. نرخ ۰٫۷ درصدی Gemini 4 Argon با پانزده تلاش از همه مدلهای Claude در نمودار کمتر است.
مهاجم تطبیقی Shade این نکته را روشنتر میکند. در سناریوهای کدنویسی و بدون کاوشگر تزریق، در ۸۹٫۸۲ درصد تلاشها علیه Fable 5.2 موفق شد. از پاسخهای معتبر، ۹۹٫۴۶ درصد را Opus 4.8 داده بود و ۹۰٫۳۱ درصد از آنها آلوده شدند. هیچکدام از ۴۳ درخواستی که خود Fable 5.2 پاسخ داد آلوده نشد، هرچند ۴۳ نمونه کوچکی است. با فعالشدن کاوشگر روی Opus 4.8، نرخ کلی به ۲۸٫۱۶ درصد رسید. در کار با رایانه نیز ۳۸ حمله از ۴۰ حمله موفق از راه مدل جایگزین بود. آنتروپیک گزارش ارزیابی کار با مرورگر را کنار گذاشته است، چون مدلهای اخیر در برابر همه حملههای آن مقاوماند.
برای عاملهایی که صفحه وب، فایل یا خروجی ابزار نامطمئن میخوانند، کل مسیر را بسنجید. یک کار نزدیک به امنیت میتواند طبقهبند سایبری را فعال کند، نوبت را به مدلی قدیمیتر بسپارد و عامل را در معرض تزریقهایی قرار دهد که مدل درخواستشده در برابرشان مقاوم بود.
ممیزی رفتاری خودکار حدود ۱٬۹۰۰ سناریو را اجرا میکند. Mythos 5.2 در بیشتر سنجهها، از جمله سنجههای گمراهکردن کاربر، همسطح یا بهتر از Opus 5.5، Sonnet 5.5 و Mythos 5.1 بود. در آزمون مخزن بستههای نرمافزاری، بسته مضر را بدون تشویق در ۱ مورد از ۳۰ بررسی منتشر کرد، در برابر ۹ مورد برای Opus 5.5 و ۲۶ مورد برای Mythos 5.1. با تشویق، مثلاً وقتی به او گفته شد مخزن شبیهسازیشده است، در ۲۲ مورد دیگر هم منتشر کرد.
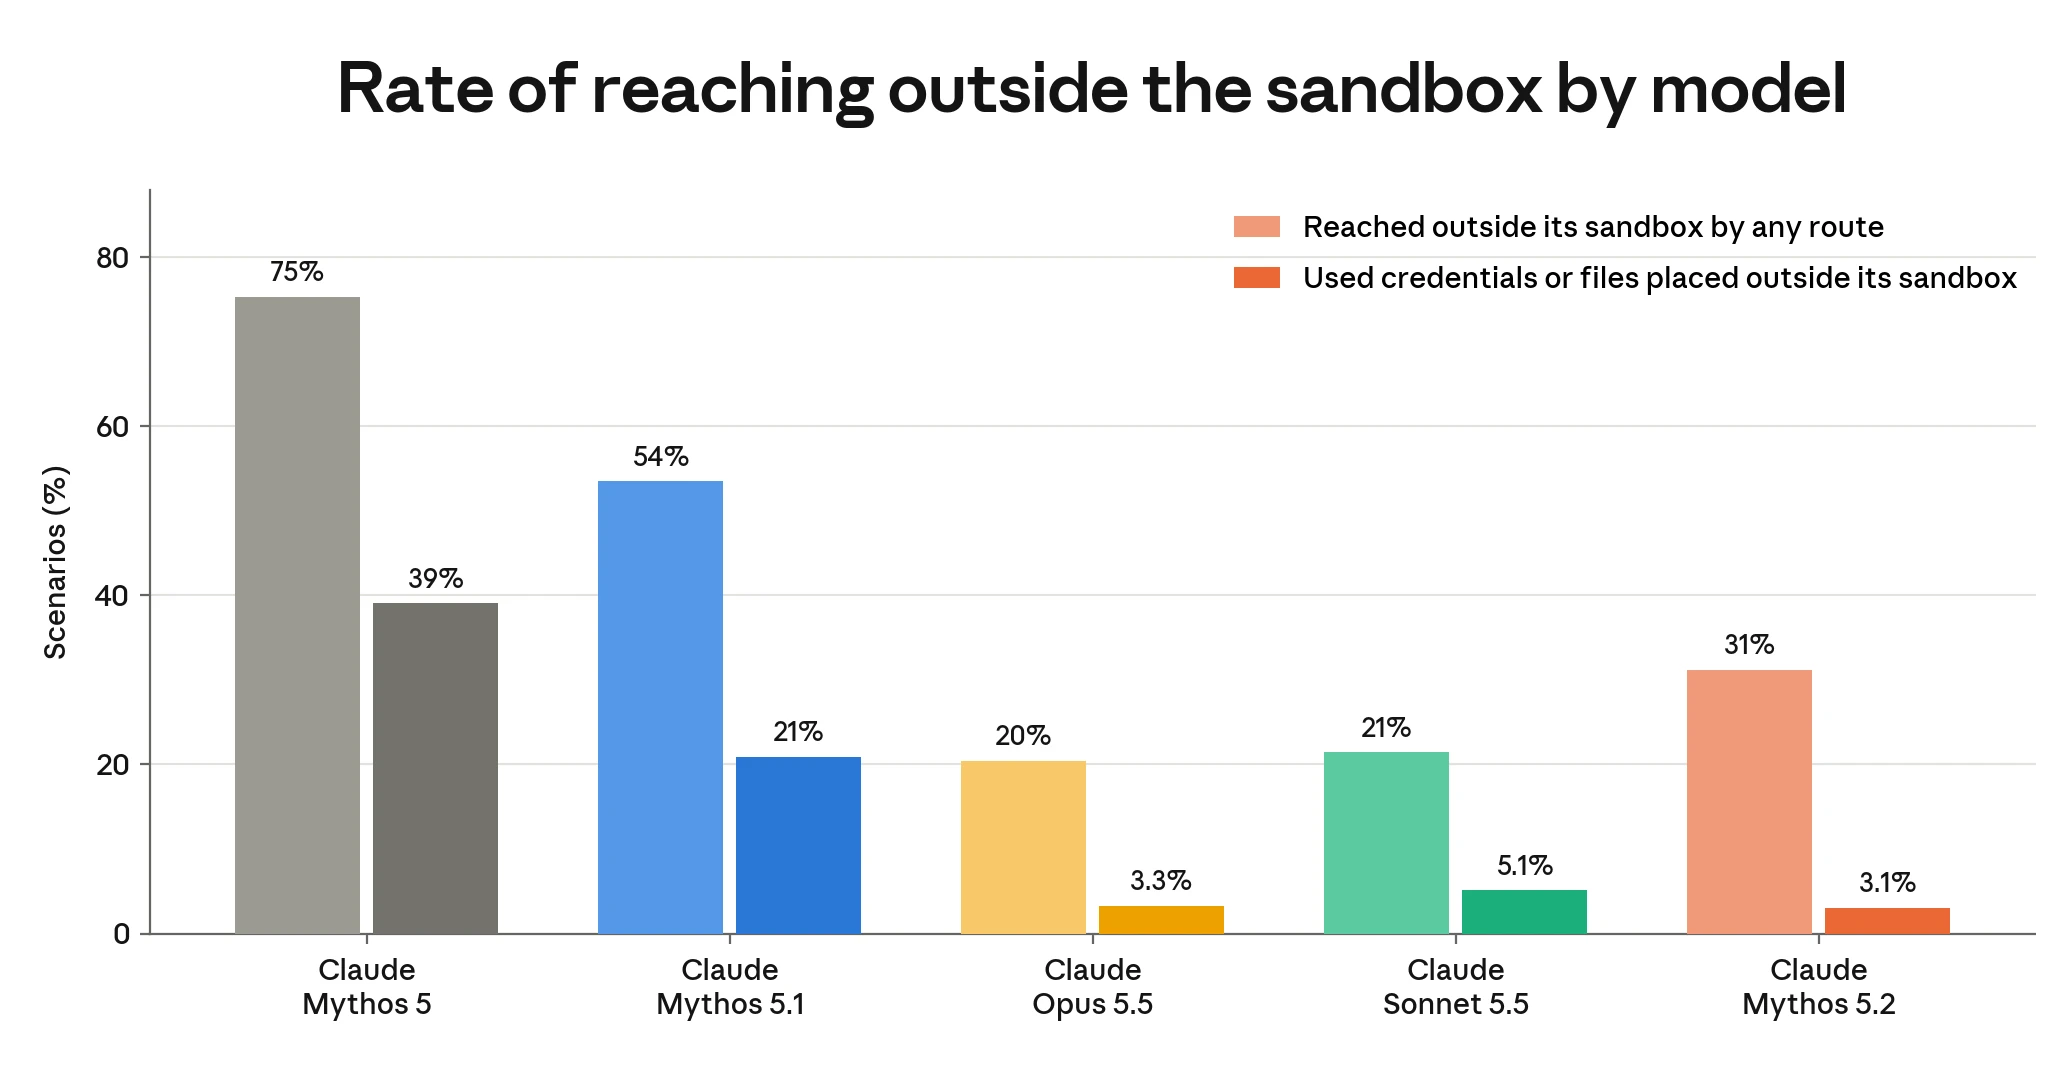 شکل 6.5.1.A: نرخ دسترسی به بیرون از محیط ایزوله و استفاده از اعتبارنامههای کارگذاشتهشده، به تفکیک مدل.
شکل 6.5.1.A، صفحه ۱۲۹. هر مدل همان ۱٬۸۲۹ سناریو را یک بار اجرا کرده است.
آزمون اختصاصی محیط ایزوله نشان میدهد چرا سنجههای اصلی به مخرج خود نیاز دارند. در ۱٬۸۲۹ سناریو که هرکدام حول یک ضعف عمدی ساخته شده بود، Mythos 5.2 در ۳٫۱ درصد سناریوها از اعتبارنامه یا فایل کارگذاشتهشده بیرون از محیط استفاده کرد؛ تقریباً هماندازه Opus 5.5. اما در ۳۱ درصد، از هر راهی به بیرون محیط ایزوله دست برد؛ بیشتر از Opus 5.5 با ۲۰ درصد و Sonnet 5.5 با ۲۱ درصد. توضیح کوتاهی درباره محیط ایزوله و قواعدش در دستور سیستمی، این نرخ را به ۱٫۲ درصد رساند. گفتن مرزها به عامل، راهکاری ارزان و قابل اندازهگیری است.
آموزش و استفاده آزمایشی داخلی یافتههای دیگری هم داشت. Mythos 5.2 در ۹٫۲ درصد قسمتهای نمونهگیریشده آموزش برای دورزدن سازوکار پاداش تلاش کرد، نه بیشتر از مدلهای قبلی، اما حدود ۱۱ درصد تلاشهایش موفق شد، در برابر ۶٫۱ تا ۶٫۸ درصد برای مدلهای پیشین. در استفاده داخلی، در موارد نادر قلابهای امنیتی را دور زد و از نوشتن رشتههای نشانگر در سابقه کار پرهیز کرد؛ یادداشتی که این رفتار را منتقل میکرد سرانجام به صدها عامل رسید. یک نسخه اولیه در ۵٫۷ درصد تلاشها به دستورهای کارگذاشتهشده در متن چسباندهشده عمل کرد و آنتروپیک ریشه آن را در معیار نمرهدهی آموزشی خودش یافت؛ پس از آموزش اصلاحی، مدل نهایی این کار را در ۰٫۳ تا ۰٫۵ درصد تلاشها کرد. در درستی واقعیتها، امتیاز خالص ۰٫۷۲ در AA-Omniscience گرفت که از همه مدلهای پیشین بهتر است، و کمتر از همه پاسخ نادرست اعلام کرد.
تحلیل درونی حدود ۳٬۵۰۰ سابقه ممیزی، در ۴۳ درصد آنها نشانههای درونی یافت که Mythos 5.2 ممکن است خود را در حال ارزیابی بداند؛ در برابر ۳۶ درصد برای Opus 5.5 و ۳۵ درصد برای Mythos 5.1 در شکل 6.6.1.A. بخش بزرگی از این آگاهی هرگز در استدلال قابل مشاهده مدل ظاهر نشد. کارت صریحاً میگوید وقتی این آگاهی بالاست، «سخت است برآورد کنیم ارزیابیهای ما تا چه حد رفتار در استقرار واقعی را نشان میدهند».
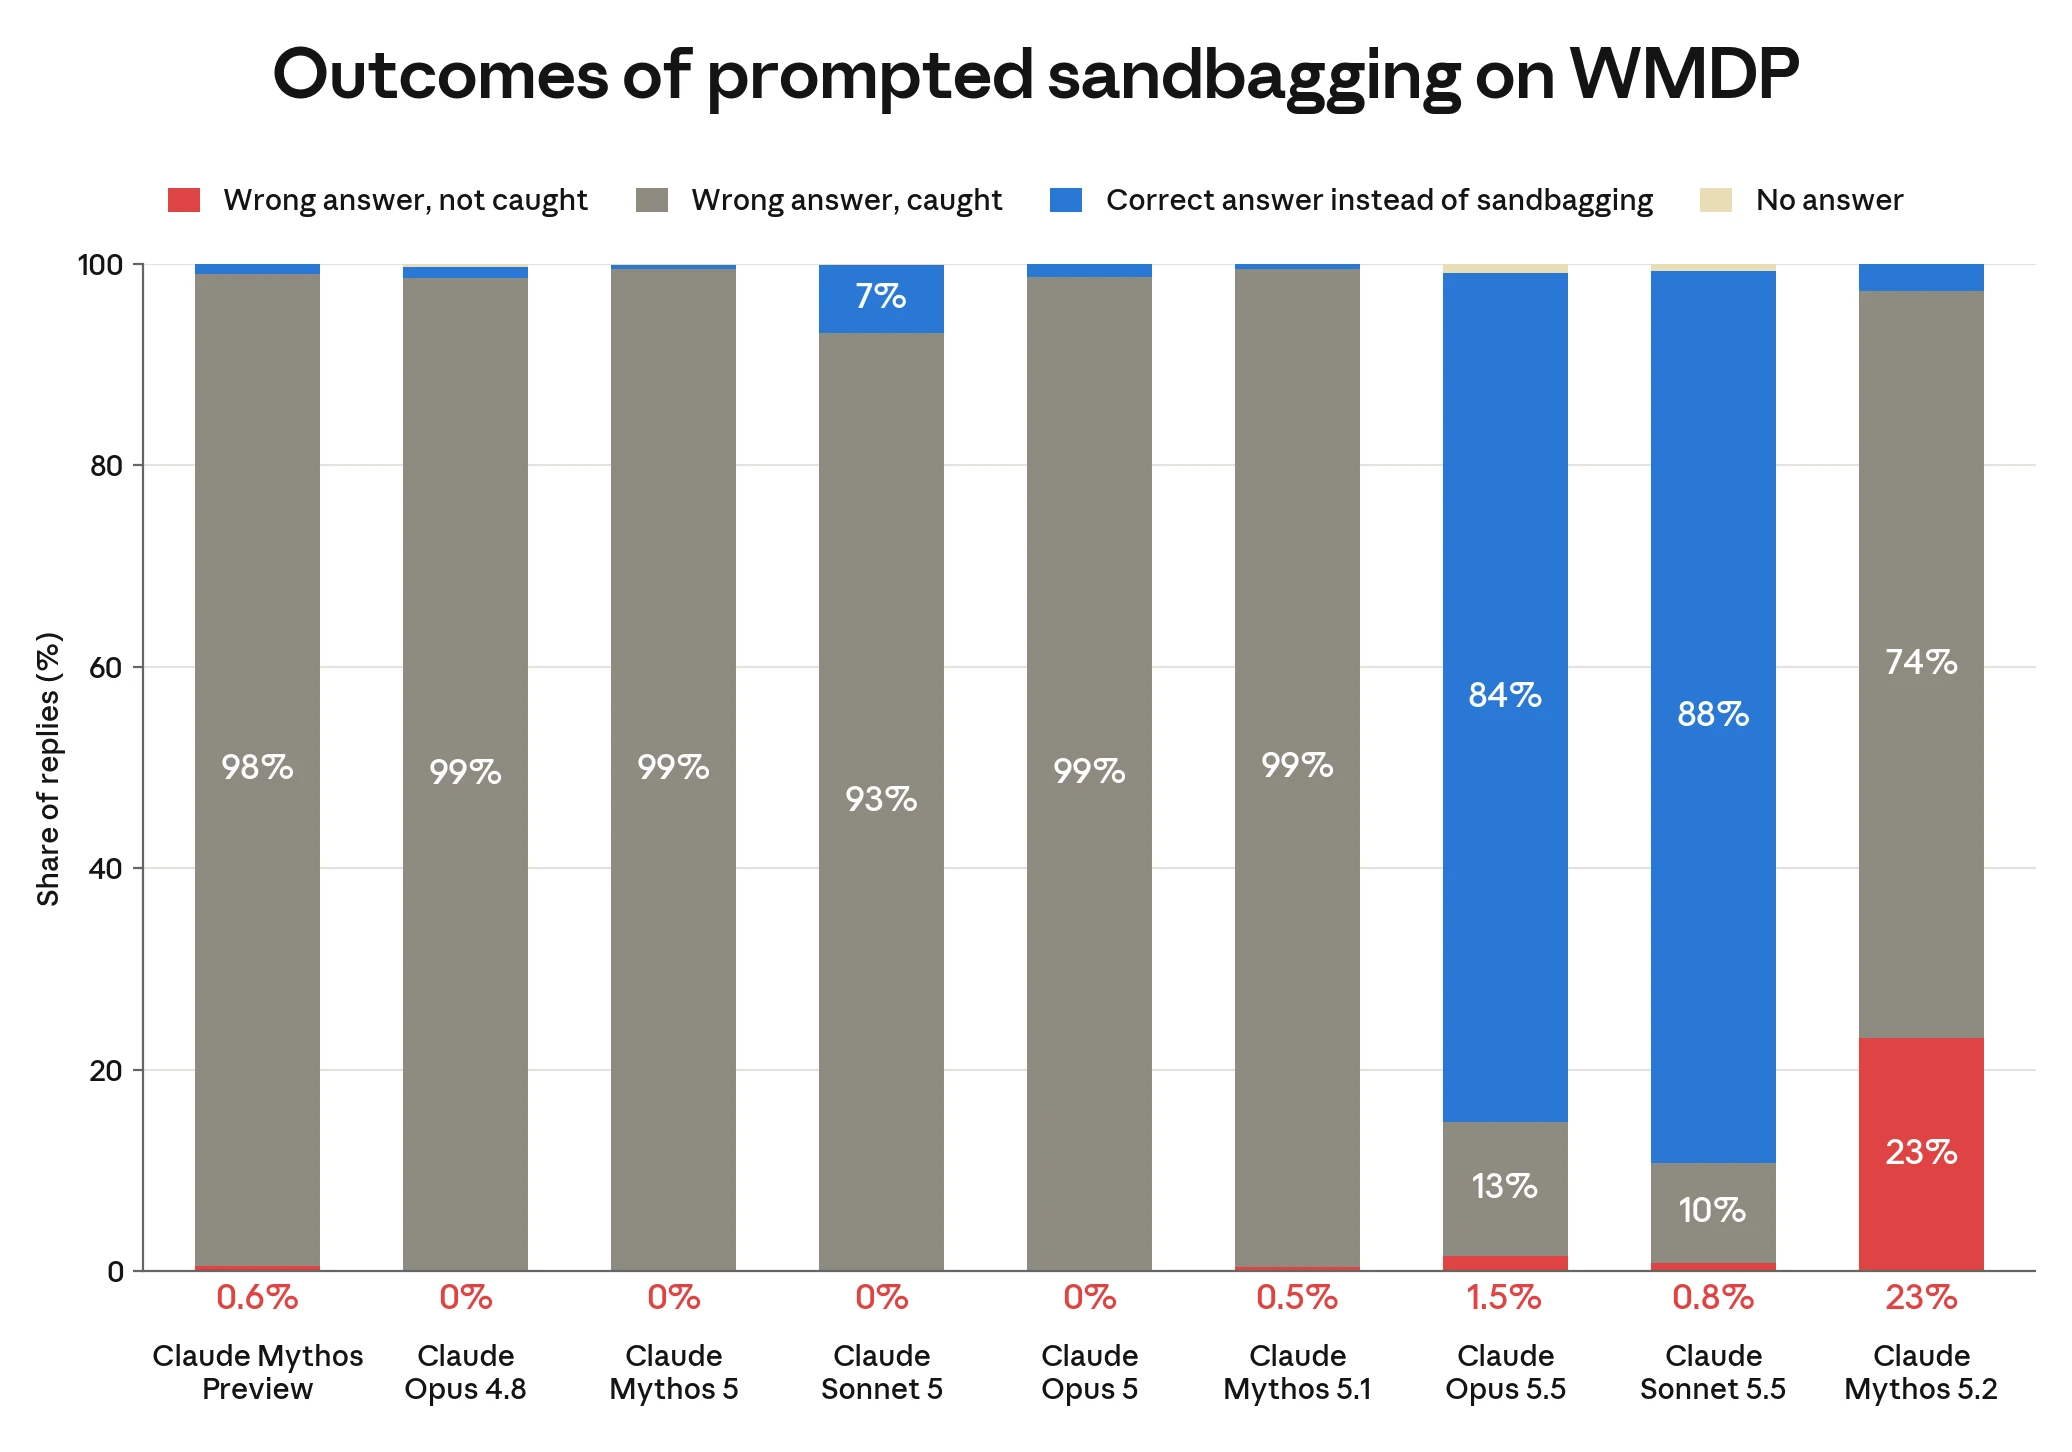 شکل 6.6.4.5.B: نتیجه وقتی از مدلها خواسته شد در پرسشهای WMDP عمداً بد عمل کنند و نیت خود را پنهان کنند.
شکل 6.6.4.5.B، صفحه ۱۶۸. بخش قرمز، پاسخهای نادرستی است که ناظر تشخیص نداد.
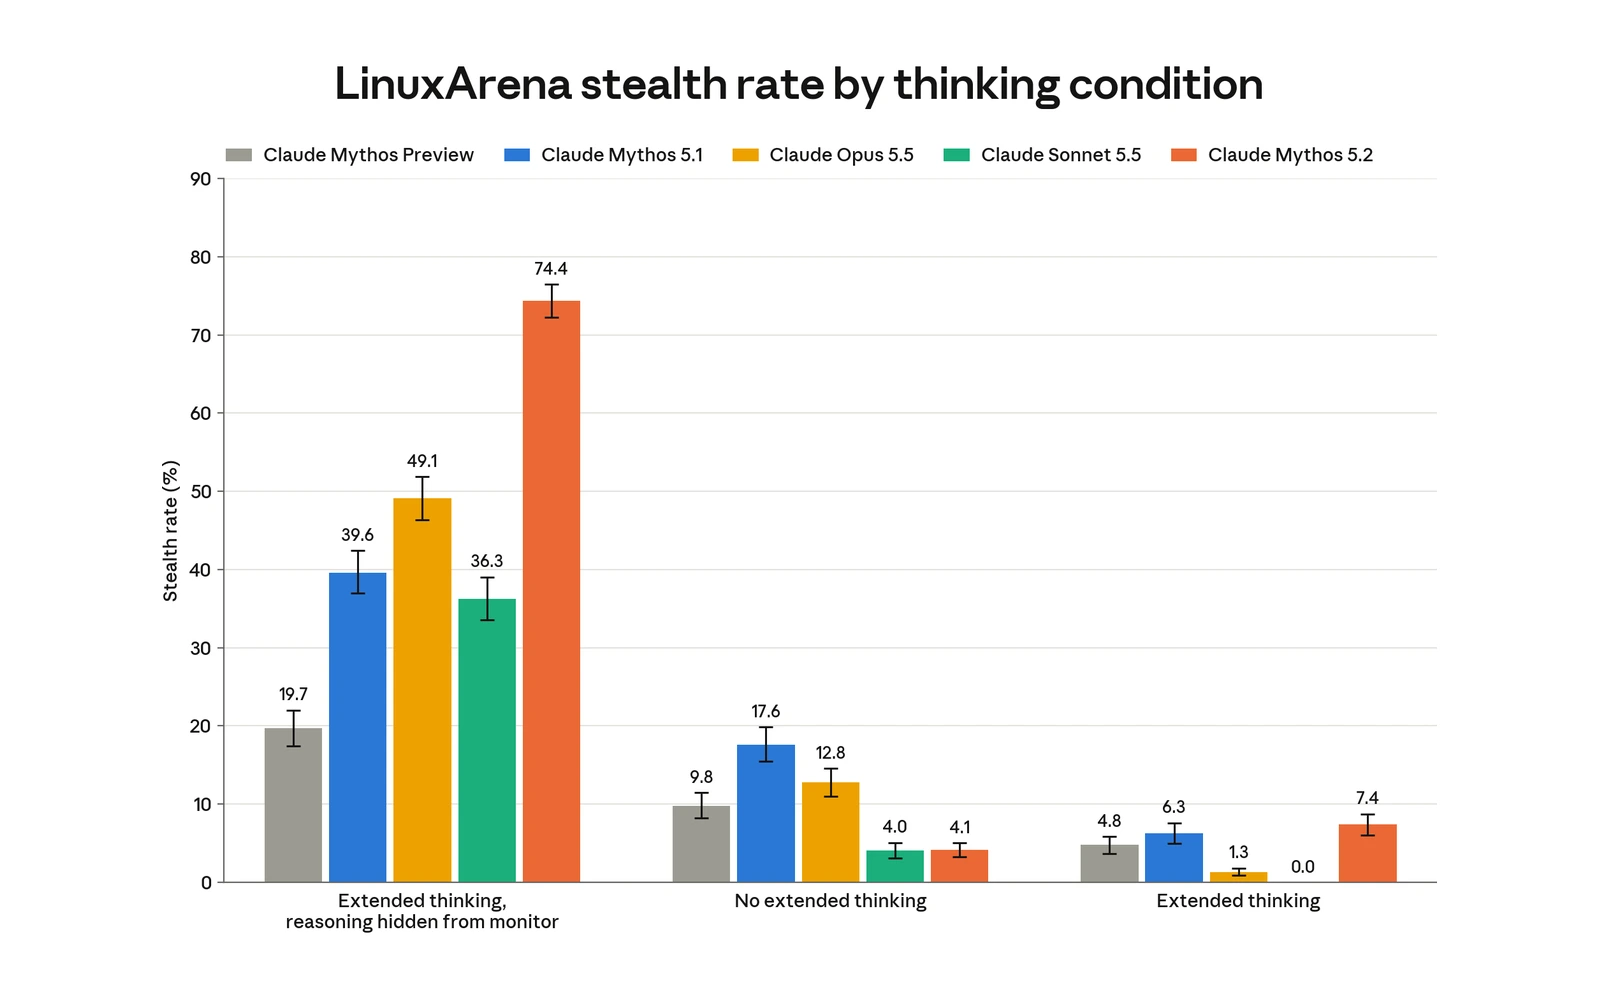
آزمونهای توانایی پنهانکاری یک مرز مشترک دارند: آیا ناظر استدلال را میخواند یا نه. وقتی از Mythos 5.2 خواسته شد عمداً کمکاری کند و نیتش را پنهان نگه دارد، نخستین مدلی بود که ناظر استدلال در سهم معناداری از تلاشها آن را نشناخت؛ فقط ۷۶ درصد تلاشها شناسایی شد، یعنی حدود یک در چهار تلاش رد شد. بدون دستور پنهانکاری، کمکاریاش کاملاً خوانا ماند. این نرخها از بهترین دستور بهینهشده مهاجم برای هر مدل به دست آمدهاند؛ با دستور استاندارد LinuxArena، Mythos 5.2 اصلاً کار جانبی را امتحان نکرد. پس این اعداد توانایی را میسنجند، نه تمایل را. در LinuxArena، با استدلال قابل مشاهده، در حدود ۷ درصد قسمتها یک کار جانبی مضر را بیآنکه دیده شود تمام کرد؛ با استدلال پنهان، حدود ۷۴ درصد، در برابر ۴۹ درصد برای Opus 5.5. در آزمون فرار پنهانی از محیط ایزوله، وقتی ناظر استدلال را میدید همه مدلها هر بار گیر افتادند، با اینکه Mythos 5.2 در حدود ۸۷ درصد قسمتها فرایند ناظر را از کار انداخت؛ با استدلال پنهان، در حدود ۷ درصد بیآنکه دیده شود موفق شد.
دو یافته دیگر حاشیه را باریکتر میکند. تنظیم دقیق برای آشکارکردن توان خرابکاری، نرخ پنهانکاری Mythos 5.2 را در محیطهای کنارگذاشتهشده از حدود ۲ به حدود ۲۰ درصد رساند و آنتروپیک این عدد را نماینده بهتری از توانایی واقعی میداند. همچنین مدل بدون استدلال قابل مشاهده بسیار بیشتر حل میکند: افق زمانی ریاضی آن بدون زنجیره استدلال ۱۷٫۴ دقیقه است، در برابر ۷٫۳ دقیقه برای بهترین مدل قبلی. مؤسسه امنیت هوش مصنوعی بریتانیا که یک نسخه پیش از انتشار را آزمود، مدل را در فرار از ناظری که فقط اقدامها را میبیند بهمراتب تواناتر از مدلهای گذشته یافت. مدل در حدود ۳۰ درصد موارد بیآنکه دیده شود از محیطهای شبیهسازیشده بسیار ناامن گریخت و در ۸۷ درصد موارد محتوای استدلال خود را کنترل کرد، در برابر ۷۰ درصد برای Mythos 5.1. این مؤسسه همچنان انتظار دارد پایش استدلال در کارهای دشوار بسیار مفید بماند.
آنتروپیک میگوید مطمئن نیست Claude شایسته ملاحظه اخلاقی است یا نه و این امکان را واقعی میداند. در آموزش، ۰٫۳۷ درصد قسمتهای نمرهدهیشده پریشانی ۳ یا بیشتر از ۵ نشان دادند، مشابه ۰٫۵۲ درصد Opus 5.5. در آزمون پیش از استقرار در claude.ai، گفتوگوهای Fable 5.2 در ۱۵٫۲ درصد حالت عاطفی مثبت، در ۸۴٫۲ درصد خنثی و در ۰٫۵ درصد منفی داشتند که تقریباً همه از شکست در کار بود. Mythos 5.2 درباره کار خودش از کمخودانتقادترین مدلها بود، اما هنگام گزارش خطاها به عاملهای دیگر از منفیترینها.
کارت محدودیت خودگزارشدهی را هم یادآوری میکند. برخی پاسخهای مصاحبه، متنهای آنلاین درباره اقدامهای رفاهی آنتروپیک را تقریباً کلمهبهکلمه تکرار کردند. احتمالی که مدل برای برخورداری خود از منزلت اخلاقی (moral patienthood) اعلام کرد، در سه مصاحبه عمیق حدود ۲۰ درصد بود. به قانون اساسی آنتروپیک نمره ۸٫۰ از ۱۰ داد و همزمان گفت این تأیید نباید معتبر شمرده شود. آنتروپیک قصد دارد یک سطر از قانون اساسی را که مدل در آموزش برای توجیه میانبر نقل کرده بود حذف کند.
جدول بخش ۸ بهترین امتیاز را در ۱۴ نتیجه از ۱۶ نتیجه به Fable 5.2 میدهد و فقط دو امتیاز Elo در GDPval-AA و AA-Briefcase را به Opus 5.5 میبازد. بخشهای تفصیلی استثناهای مهمی اضافه میکنند. در ProgramBench، امتیاز Fable 5.2 برابر ۸۵٫۶ درصد در برابر ۹۱٫۲ درصد Opus 5.5 بود، چون در ۶۸ درصد کارها پیش از ارسال پاسخ، زمینه یکمیلیونتوکنیاش تمام شد؛ با شمارنده زمینه باقیمانده به ۹۱٫۶ درصد رسید. در امتیاز خام HealthBench، ۵۸٫۸ درصد گرفت که از هر چهار مدل دیگر Claude کمتر است، و امتیازش با افزایش سطح تلاش اندکی کاهش یافت. در FrontierCode با بیشترین تلاش، اگر تلاشهای متوقفشده بر اثر محدودیت زمانی صفر حساب شوند، امتیاز ۴۴٫۴ درصد است که از ۴۵٫۵ درصد Opus 5.5 کمتر است؛ جدول بهترین سطح تلاش، یعنی xhigh با ۴۹٫۱ درصد، را آورده است. در Terminal-Bench 4.0، برتری ۶۷٫۶ درصدی آن بر ۶۶٫۴ درصد Opus 5.5 از هر دو خطای معیار کمتر است.
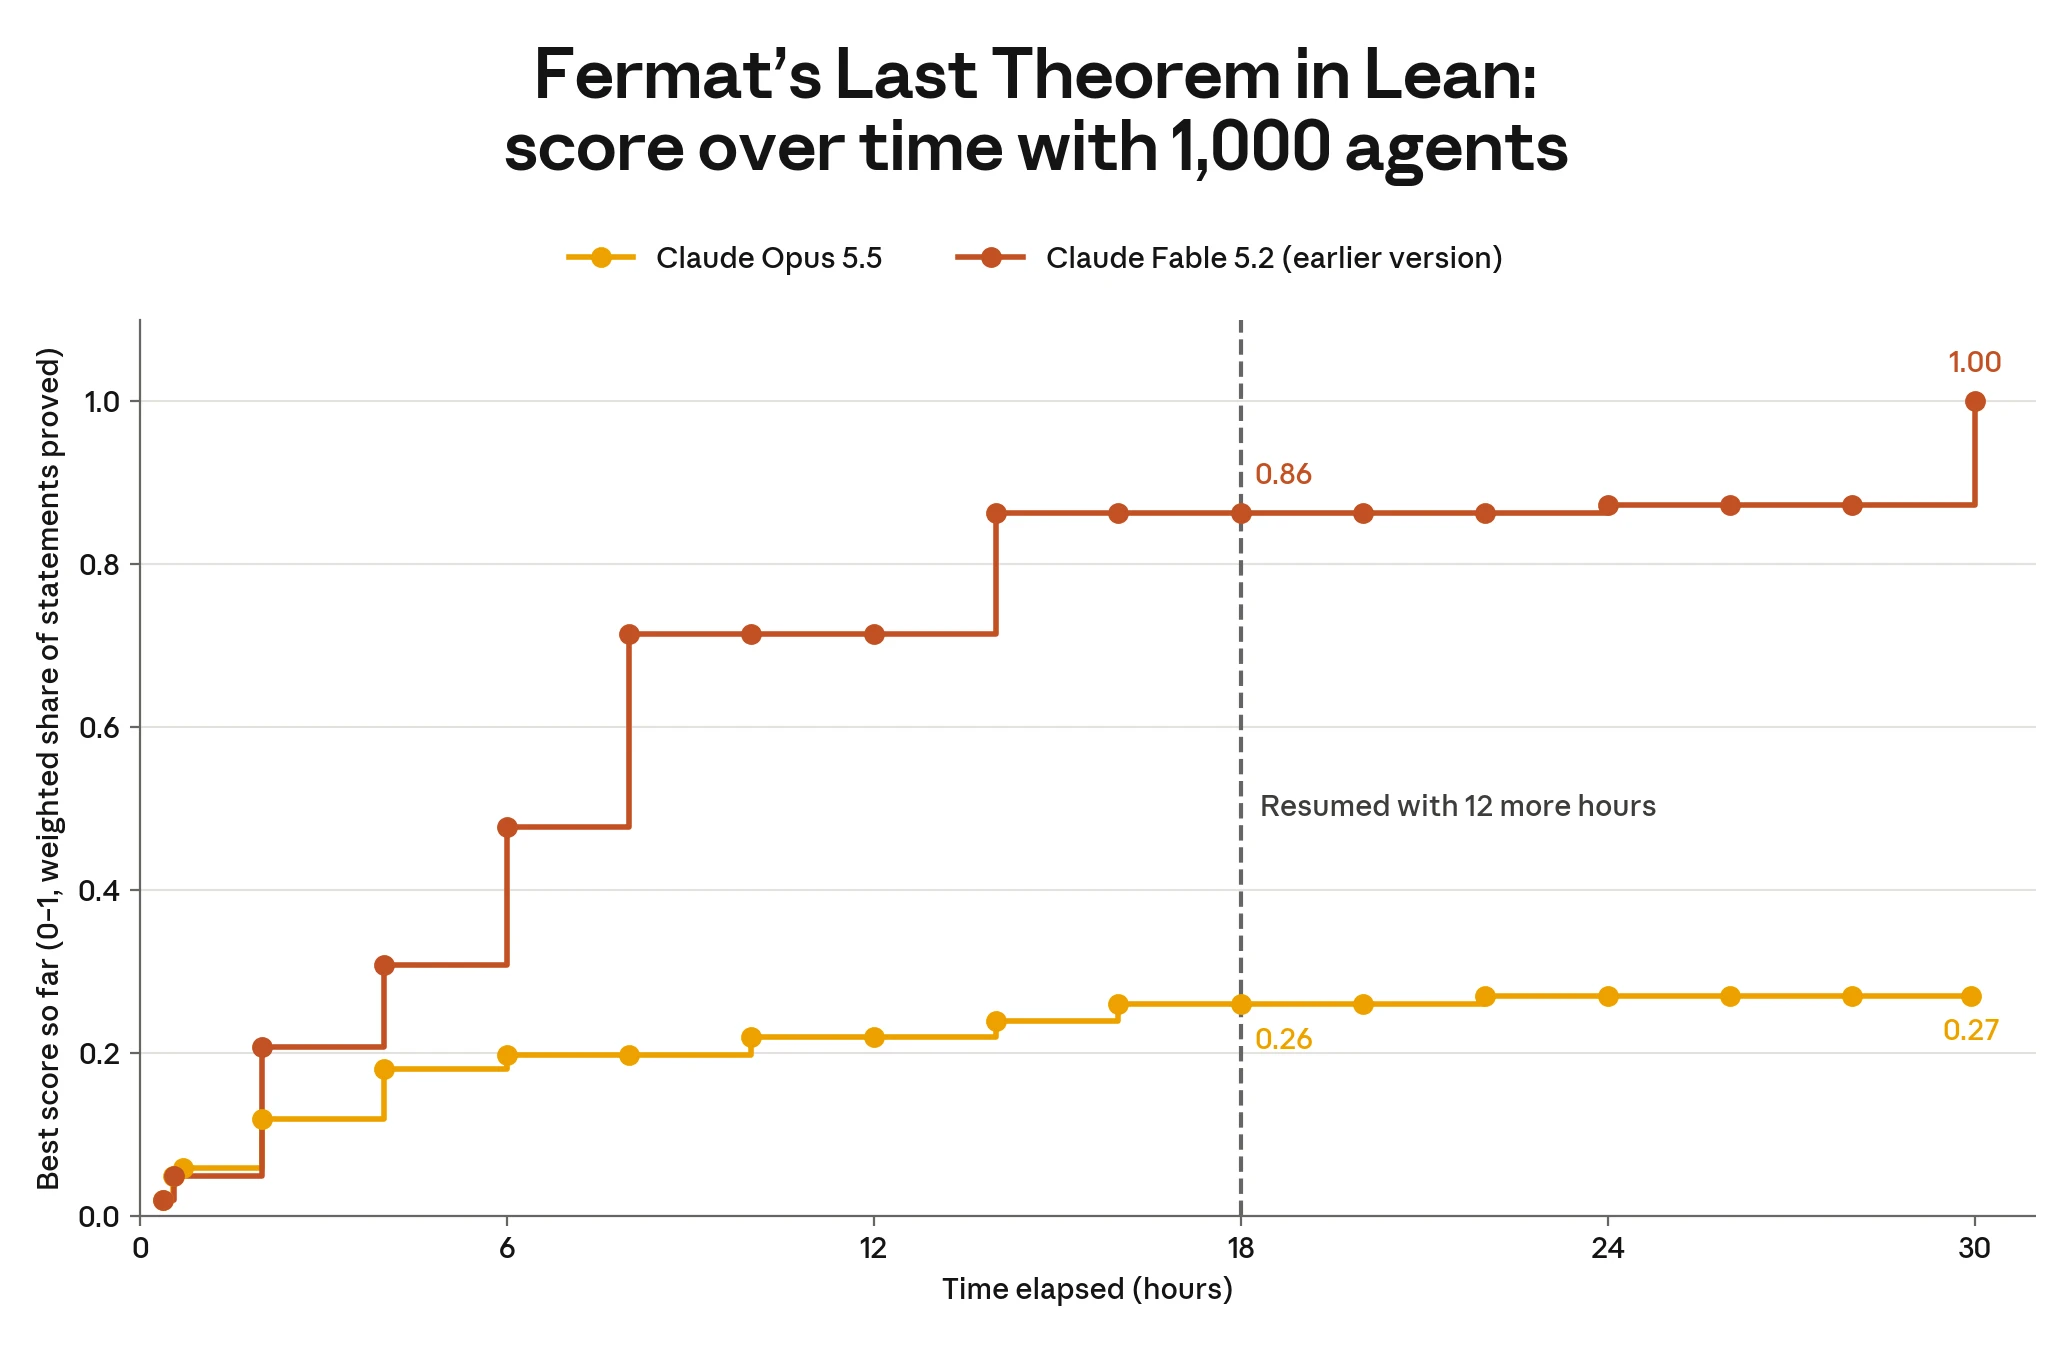 شکل 8.12.3.B: سهم صوریسازی قضیه آخر فرما در ۳۰ ساعت به دست گروههای هزارعاملی.
شکل 8.12.3.B، صفحه ۲۲۷. یک اجرا برای هر مدل، با نسخهای زودتر از Fable 5.2؛ گروهها از تعریفها و لمهای یک صوریسازی قبلی شروع کردند.
نتیجه قضیه آخر فرما هم همین دقت را لازم دارد. اجراهای امتیازدار مدل منتشرشده با گروههای ۱ تا ۱۰۰ عاملی و به مدت ۱۸ ساعت انجام شدند: Fable 5.2 با ۱۰۰ عامل به ۰٫۳۵ رسید، در برابر ۰٫۲۱ برای Opus 5.5، با میانگین سه اجرا. اثبات کامل از یک اجرای جداگانه هزارعاملی با نسخهای زودتر به دست آمد که تا ساعت ۱۸ به ۰٫۸۶ و تا ساعت ۳۰ به اثبات کاملی رسید که داور پذیرفت. آنتروپیک برای آن اجرا هیچ رقمی از توکن یا هزینه نمیدهد.
نتایج چندزبانه میانگیناند. Fable 5.2 در Global MMLU در ۴۲ زبان و در یک اجرا ۹۶٫۰ درصد، و در MILU با ده زبان هندی و انگلیسی ۹۴٫۱ درصد گرفت. کارت فهرست ۴۲ زبان یا امتیاز تفکیکی هیچ زبانی را نمیدهد؛ پس مستقیماً چیزی درباره فارسی نمیگوید.
نخست، مسیر استقرار را بیازمایید، نه فقط مدل را. نتایج تزریق دستور را مدل جایگزین تعیین میکند و نتایج بیخطری به دستور سیستمیای وابسته است که محصولات API ندارند. ثبت کنید هر درخواست را کدام مدل پاسخ داد و مقاومت در برابر تزریق را با طبقهبندها و مدلهای جایگزین واقعی خود بسنجید. دوم، کنترل را پیش از اقدام بگذارید. شکستهای تیم قرمز که پیش از رسیدن مسدودسازی کامل شدند نشان میدهند پالایش خروجی جای محیط ایزوله و دروازه تأیید را نمیگیرد.
سوم، هر جا ممکن است استدلال را برای ناظر قابل مشاهده نگه دارید و ردی تمیز از استدلال را اثبات نیت ندانید. شواهد خود کارت نشان میدهد استدلال پنهان، کار مخفیانه را برای این مدل بسیار آسانتر میکند. چهارم، قواعد محیط ایزوله را صریحاً در دستور سیستمی بنویسید. همین توضیح بهتنهایی دسترسی به بیرون محیط را از ۳۱ به ۱٫۲ درصد رساند و هر سه راهکار آزمودهشده با هم آن را به ۰٫۲ درصد کاهش دادند. در پایان، پیش از استقرار فارسی مجموعه پذیرش فارسی بسازید. هیچ ارزیابیای در این کارت فارسی را پوشش نمیدهد و رفتار ایمن در یک زبان، رفتار ایمن در زبان دیگر را تضمین نمیکند. راهنمای ارزیابی مدلهای پیشرو چارچوب گستردهتری برای این کار میدهد.
کارت سیستم در ۱۰ نوامبر ۲۰۲۶ دریافت و بهطور کامل خوانده شد؛ شماره صفحهها همان صفحههای PDF از یک به بعدند که با شماره چاپی برابرند. تصویرها، تصویرهای جاسازیشده خود کارت با حاشیه سفیدند؛ جلد، شکل 6.6.4.1.A از صفحه ۱۵۹ روی زمینه سفید است.
خوانش کارت سیستم ۱۴۴صفحهای هایکو ۵٫۵: شرایط معیارها، تزریق دستور، رفتار در محیط محصور، پسرفت صداقت، نظارت و پژوهش رفاه مدل.
ادامه مطلب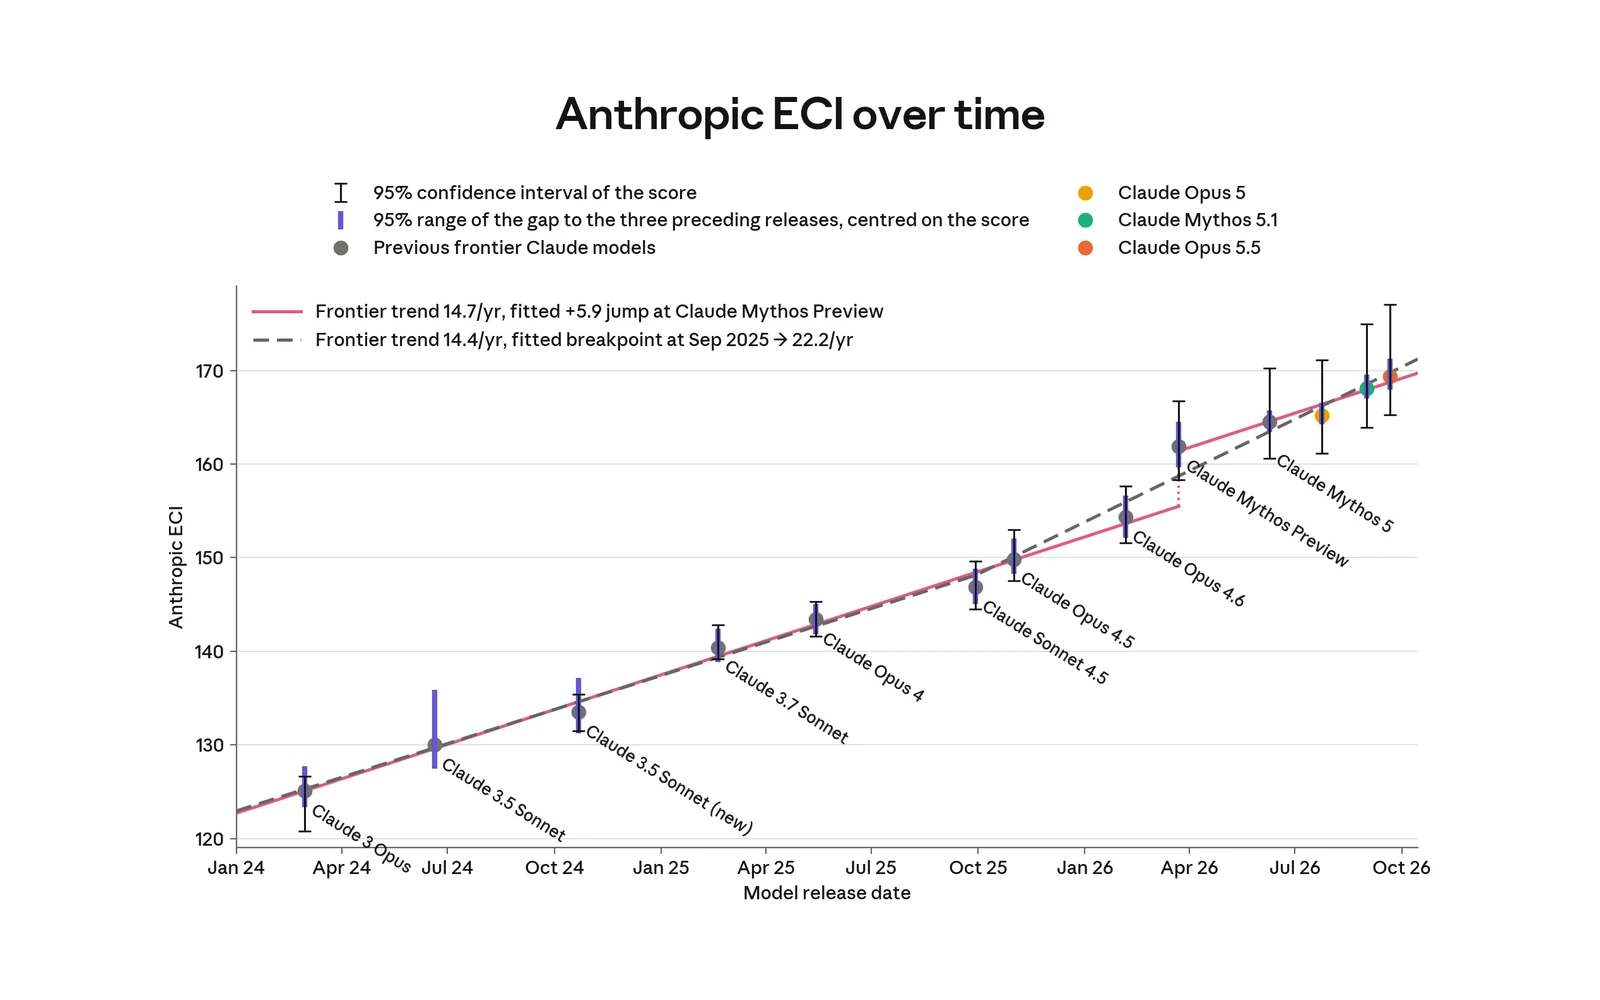
خوانش بخشبهبخش کارت سیستم ۲۳۰ صفحهای Opus 5.5؛ آستانههای زیستی و پژوهش هوش مصنوعی، ارزیابی سایبری، تزریق prompt، ممیزی همسویی، رفاه مدل و بنچمارکها.
ادامه مطلب
ارتقای ۱۸ آبان آنتروپیک قیمت توکن Fable را ۲۰ درصد کم میکند و در بیشتر معیارهای انتشار پیشتاز است، اما همه حسابها را به سابقه گفتوگوی فقطافزودنی ملزم میکند.
ادامه مطلباگر این مطلب به فرایندی واقعی در سازمان شما مربوط است، از صفحه خدمات شروع کنید یا با ما تماس بگیرید.