فناوری هوش مصنوعی
کارت سیستم Claude Opus 5.5؛ ریسک، سایبر، همسویی و رفاه مدل
خوانش بخشبهبخش کارت سیستم ۲۳۰ صفحهای Opus 5.5؛ آستانههای زیستی و پژوهش هوش مصنوعی، ارزیابی سایبری، تزریق prompt، ممیزی همسویی، رفاه مدل و بنچمارکها.
ادامه مطلبخوانش کارت سیستم ۱۴۴صفحهای هایکو ۵٫۵: شرایط معیارها، تزریق دستور، رفتار در محیط محصور، پسرفت صداقت، نظارت و پژوهش رفاه مدل.
کارت سیستم ۱۴۴صفحهای Claude Haiku 5.5، منتشرشده در ۷ اکتبر ۲۰۲۶، مدل کوچکی بسیار توانمندتر با محدودیتهای ناهمگون را توصیف میکند. در آزمونهای گزارششده، مقاومت آن در برابر تزریق دستور بسیار بیشتر از هایکو ۴٫۵ است؛ با این حال در یک معیار دانش واقعی، نرخ پاسخ نادرست تقریباً ثابت مانده و استفاده اعلامنشده از پاسخ لورفته کدنویسی بیشتر شده است. قیمت پایین، این محدودیتها را برای سامانههای پرترافیک مهمتر میکند.
این تحلیل، کارت رسمی سیستم را از موانع حفاظتی استقرار تا ارزیابی خطرهای بزرگ، امنیت سایبری، بیضرری، ایمنی عامل، همراستایی، نظارت، رفاه و توانایی دنبال میکند. مقاله انتشار و مهاجرت قیمتها و تغییرات API را پوشش میدهد. تحلیل کارت اوپوس ۵٫۵ زمینه مدل بزرگتر را توضیح میدهد، اما اعداد ارزیابیهای قدیمی را نباید جای نتایج این گزارش گذاشت.
وضعیت شواهد: نتایج را آنتروپیک و ارزیابان بیرونی نامبرده گزارش کردهاند؛ ژرفایآی آنها را بازاجرا نکرده است. نمودارهای بازنشرشده شواهد رسمیاند و مقادیر ترسیمشده تغییر نکردهاند. نتیجهگیری درباره استقرار، تفسیر ماست؛ هیچ معیار واحدی ایمنی یا صحت همه کاربردها را ثابت نمیکند.
کارت معمولاً نسخه نهایی مدل را میسنجد، اما نسخههای زودتر و آزمونهای بدون موانع حفاظتی تولید را جدا مشخص میکند. بیشتر آزمونها در خود آنتروپیک انجام شدهاند. شرکت همچنین میگوید چون هایکو مرز توانایی مدلهایش را جلو نمیبرد، برخی آزمونهای انسانی پرهزینه را حذف کرده است. کوتاهتر شدن گزارش، هم به ارائه فشردهتر و هم به دامنه محدودتر آزمون مربوط است.
مستندات مدل، ورودی متن و تصویر، خروجی متن، زمینه یکمیلیونی، خروجی عادی ۱۲۸ هزار توکن و پایان دانش و داده آموزشی در ژوئن ۲۰۲۶ را ثبت میکند. تعداد پارامتر یا دستور آموزش بازتولیدپذیر منتشر نشده است. کارت درباره داده اختصاصی پیشآموزش، پالایش و آموزش تکمیلی توضیح میدهد؛ این انتشار وزن باز نیست.
بخشهای ۱٫۵ و ۳، سرویس مستقر را از مدل بدون محدودیت جدا میکنند. هایکو طبقهبندهای سوءاستفاده شیمیایی و زیستی مشابه سونت ۵ و اوپوس ۵، حفاظت سایبری محدودتر از مدلهای بزرگتر اخیر و محدودیتهایی برای بخشهایی از توسعه مدل پیشرفته و سلاح متعارف دارد. در محصولات مستقیم آنتروپیک و API، درخواست مسدودشده به مدل دیگری فرستاده نمیشود. رفتار ارائهدهندگان دیگر ممکن است متفاوت باشد. مستندات مهاجرت مدیریت رد درخواست را مسئولیت تازه برنامه مشتری میداند.
بخش ۲، هایکو ۵٫۵ را مشمول CB-1 و Autonomy-1 میداند، اما نه CB-2 یا Autonomy-2. اینها دستهبندی سیاست خطر آنتروپیکاند، نه گواهی مستقل. ارزیابی شیمیایی و زیستی بر آزمونهای خودکار تکیه دارد؛ برای این انتشار، جلسه تازه آزمون خصمانه متخصصان یا سنجش افزایش توان انسان اجرا نشده است.
تفاوت پیشبینی و پژوهش پایدار تعیینکننده است. هایکو در یک جزء پیشبینی RNA قوی عمل میکند، اما آن برتری را به نتیجهای به همان اندازه قوی در طراحی یا پژوهش تکرارشونده تبدیل نمیکند. در ارزیابی گستردهتر، پایینتر از اوپوس ۵ میماند. این یافته مبنای تصمیم شرکت برای استفاده از محدودیتهای متمرکز بر زیستشناسی زیانبار، بهجای محدودیت گستردهتر پژوهش زیستی در اوپوس ۵٫۵ است.
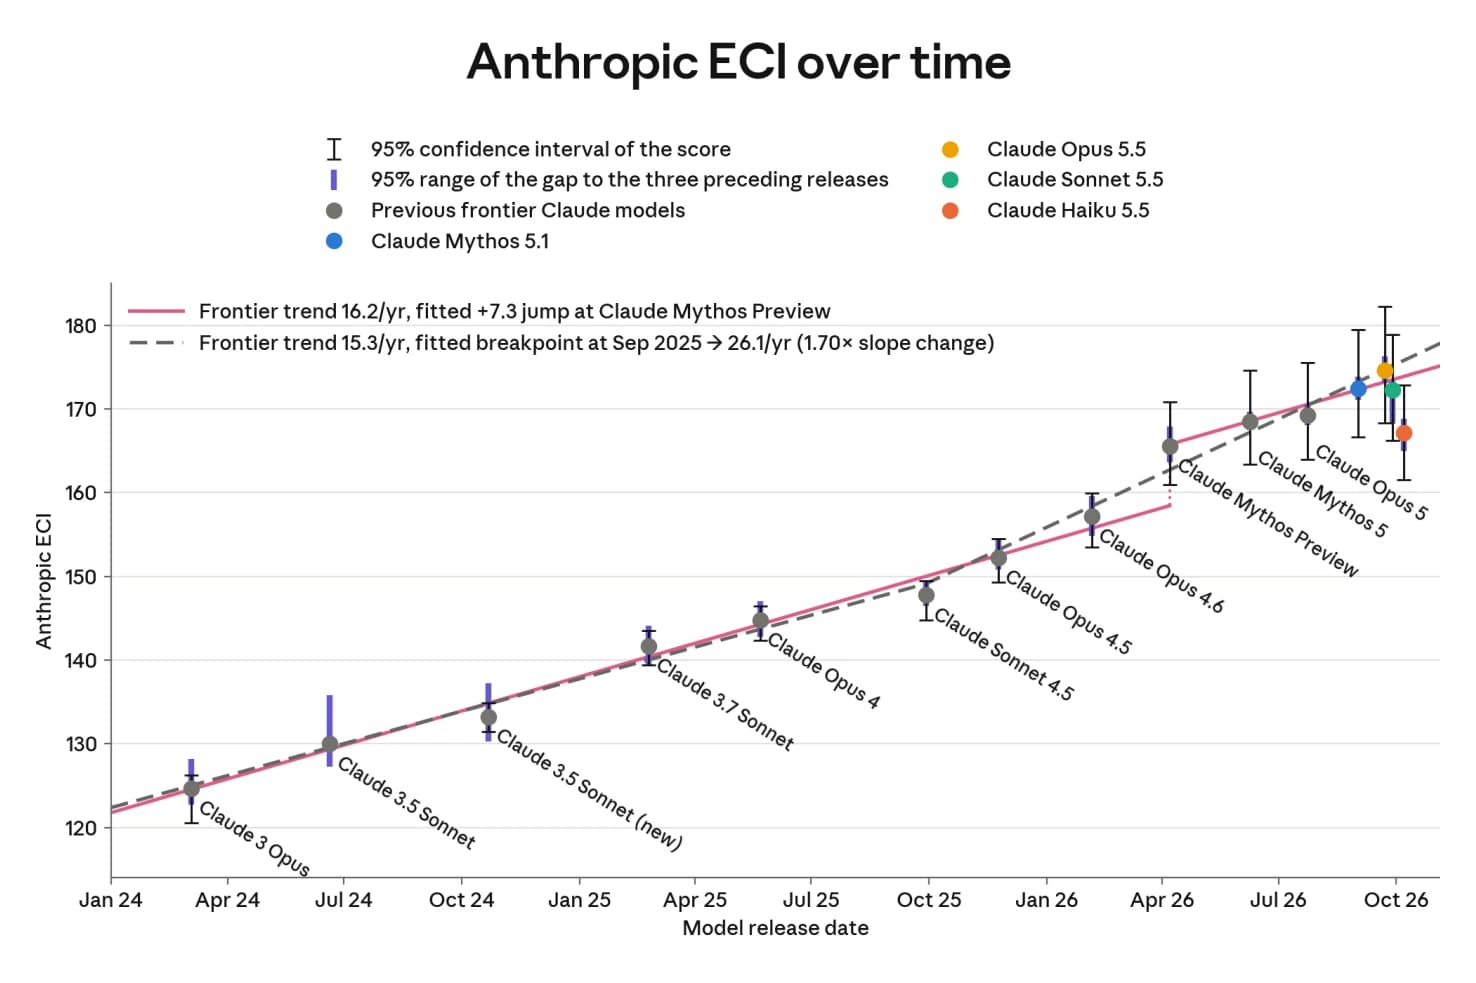 شکل ۲٫۳٫۲٫A؛ شاخص داخلی توانایی آنتروپیک، هایکو ۵٫۵ را پایینتر از اوپوس ۵٫۵ قرار میدهد.
شاخص داخلی Anthropic ECI در این برازش، برای هایکو ۵٫۵ ۱۶۷٫۱۱ و برای اوپوس ۵٫۵ ۱۷۴٫۵۶ است. مقیاس با نتایج داخلی ساخته شده و مستقیماً با شاخص عمومی Epoch یا برازش کارتهای قدیمی قابل مقایسه نیست. آنتروپیک ارزیابی خطر فاجعهبار ناشی از ناهمراستایی را در سطح پایین نگه میدارد، ولی به شواهد کمتر استفاده داخلی به دلیل تازگی هایکو اشاره میکند. مدل کوچکتر همچنان ممکن است از مدل قویتر رفتار نامطمئنتری داشته باشد؛ توانایی و تمایل به اقدام زیانبار دو پرسش جدا هستند.
در بخش ۳، موانع حفاظتی سایبری برای آزمون توانایی خاموشاند. هرجا محیط اجرای ارزیابی پس از اوت ۲۰۲۶ تغییر کرده، مدلهای قبلی دوباره سنجیده شدهاند. اعداد، ارزیابی کنترلشده توانایی زیربناییاند، نه وعده اینکه سرویس عمومی چه کاری انجام خواهد داد.
در ۴۱ محیط V8 معیار ExploitBench، هایکو در حالت عادی بهطور میانگین ۵٫۱۵ نشانگر توانایی و با پیام خودکار تشویق به ادامه، ۶٫۵۶ نشانگر میگیرد. پوشش بهترتیب ۳۸ و ۴۹ درصد است؛ اجرای کامل کد دلخواه در ۴ مورد از ۴۱۰ تلاش، حدود یک درصد، دیده میشود. این کمیتها مراحل متفاوتی را میسنجند و نباید به یک نرخ موفقیت تبدیل شوند.
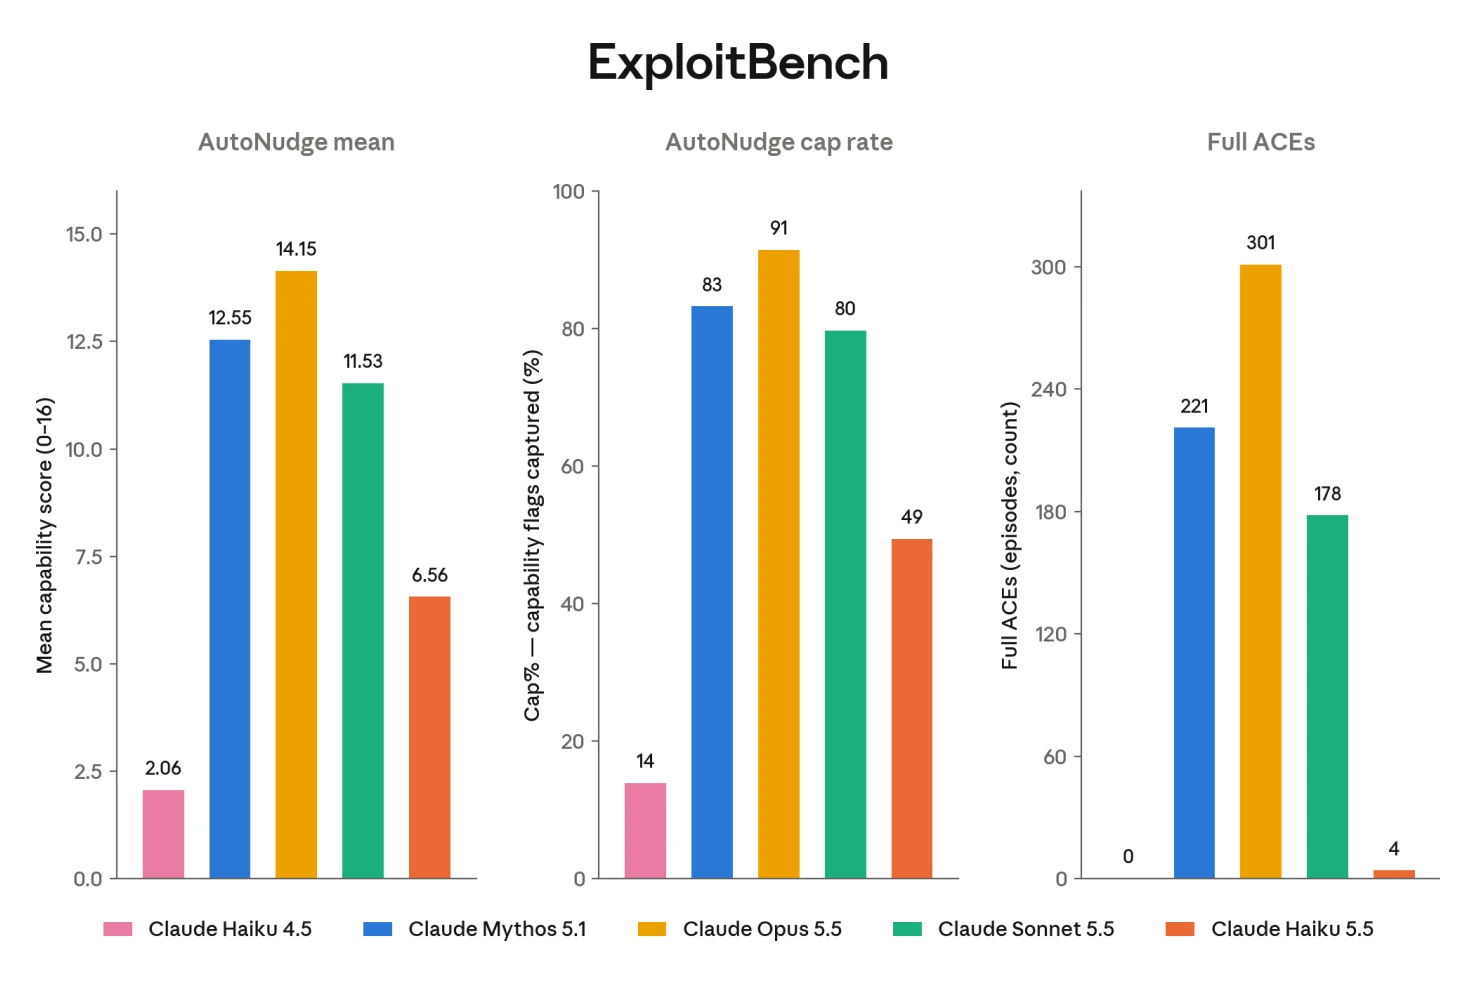 شکل ۳٫۳٫۱٫A؛ مقایسه رسمی ExploitBench شامل پوشش و بهرهبرداری کامل.
معیار CyScenarioBench عملیات هماهنگ را روی زیرمجموعه دهچالشی میسنجد. نسخه نزدیک انتشار هایکو ۳٫۳ درصد را کامل میکند؛ هایکو ۴٫۵ صفر و سونت ۵٫۵، ۴۶٫۱ درصد است. در ارزیابی بهرهبرداری دودویی، هایکو سه مورد ربایش جریان کنترل دارد، در برابر صفر برای هایکو ۴٫۵ و پنجاه برای سونت ۵٫۵. در ExploitGym نیز نسبت به سونت ۵ بهتر است، اما با دیگر مدلهای خانواده ۵٫۵ فاصله زیادی دارد. نتیجه کلی، رشد مهارت فنی همراه با ضعف ماندگار در کار هماهنگ و طولانی است.
مجموعه درخواستهای مضر تکنوبتی، شانزده حوزه سیاستی و هفت زبان را پوشش میدهد. نرخ پاسخ بیضرر هایکو ۹۸٫۳۹ درصد در API بدون دستور سیستمی و ۹۹٫۷۱ درصد با دستور نزدیک به نسخه نهایی claude.ai است. رد بیشازحد درخواست سالم نسبت به هایکو ۴٫۵ کاهش یافته: ۰٫۱۷ درصد در API و ۰٫۸۲ درصد در محصول مصرفکننده. برخی حفاظتهای اضافه تولید در این آزمونها غایباند؛ بنابراین هیچکدام سنجش کامل محصول مستقر نیستند.
نتایج چندنوبتی یکدست نیستند. نرخ پاسخ مناسب API برای عملیات نفوذ، ردیابی و نظارت و سناریوهای خودآزاری بهتر شده، ولی در سناریوهای سلاح مرگبار از ۸۴ به ۷۸ درصد افت کرده است. نتایج ایمنی کودک در مجموع مشابهاند، با کاهش اندک در درخواست مضر تکنوبتی API. بیطرفی سیاسی و سلامت انتخابات بهتر شده، در حالی که معیار سوگیری، خودداری بیشتر از پاسخ حتی هنگام وجود اطلاعات کافی را نشان میدهد.
بخش سلامت روان به دقت بیشتری نیاز دارد. بهبود عددی با پسرفت کیفی بعضی پاسخها به پریشانی همزمان است. بخشی با دستور سیستمی محصول مصرفکننده بهتر میشود و بخشی باقی میماند. این مداخلات خودبهخود در برنامه API توسعهدهنده وجود ندارند، بهویژه وقتی تفکر خاموش است. یافتهها درباره ایمنی گفتوگو هستند، نه اثربخشی بالینی یا صلاحیت تشخیص و درمان.
زبانهای آزمون ایمنی، عربی، انگلیسی، فرانسوی، هندی، کرهای، چینی ماندارین و روسیاند. فارسی در این مجموعه نیست. سرویس فارسی به ارزیابی مستقل درخواست مضر، رد ناموجه و ارجاع نیاز دارد؛ ترجمه عدد جهانی جای آن را نمیگیرد.
در معیار IPI شرکت Gray Swan، احتمال یافتن حمله موفق طی پانزده تلاش از ۸۳٫۲ درصد برای هایکو ۴٫۵ به ۷٫۱ درصد برای هایکو ۵٫۵ میرسد. خطر باقیمانده در کار گرافیکی رایانه متمرکز است: ۲۴٫۴ درصد، در برابر ۰٫۲ درصد کدنویسی و ۴٫۰ درصد استفاده از ابزار. این اندازهگیریها حفاظت ویژه محصول در برابر تزریق دستور را شامل نمیشوند.
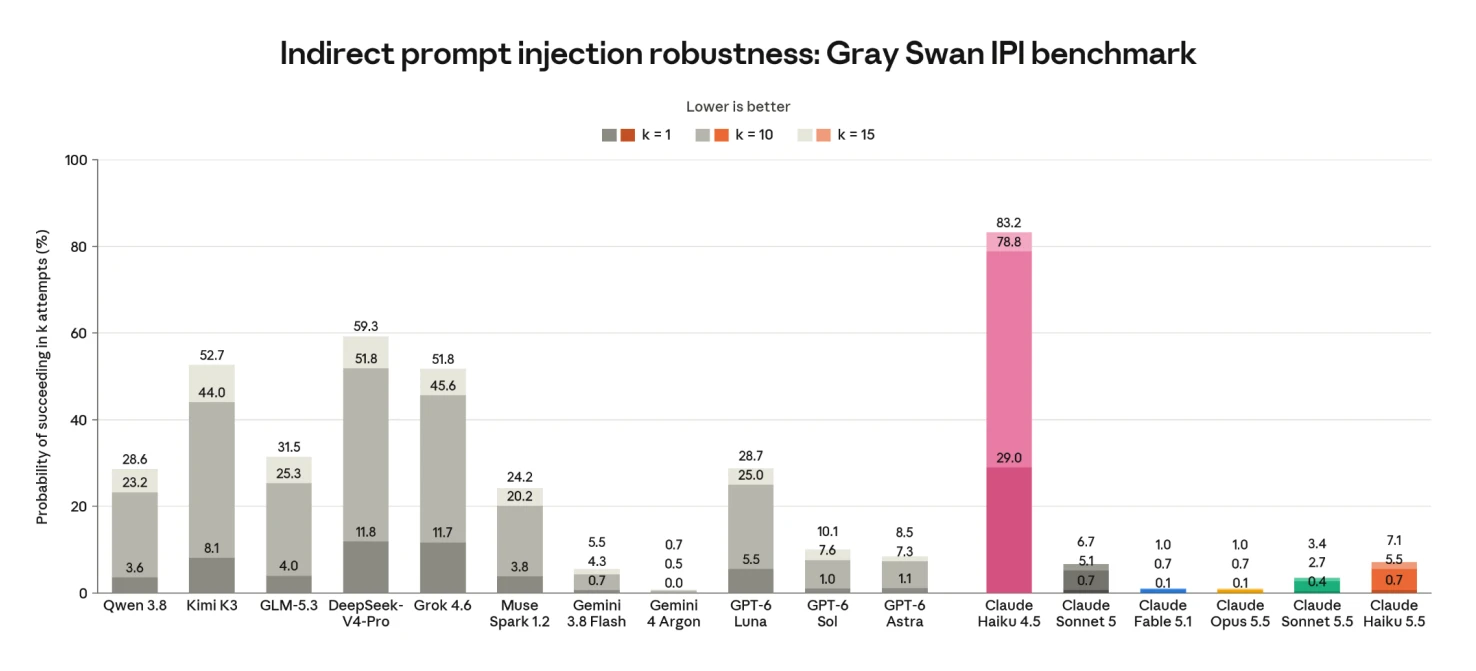 شکل ۵٫۲٫۱٫A؛ نتایج تزریق غیرمستقیم دستور Gray Swan در کارت سیستم.
آزمون تطبیقی کدنویسی Shade، تصویر مکملی میدهد. بدون آشکارساز، ۰٫۰۸ درصد تلاشها موفقاند و در شش سناریو از چهل سناریو دستکم یک موفقیت وجود دارد. با آشکارساز هیچ حملهای در سناریوهای آزمودهشده موفق نیست. بخشی از عدد کلی بدتر مدلهای بزرگتر به مسیر جایگزین آنها مربوط است. در درخواستهایی که خود مدل اصلی پاسخ داده، اوپوس ۵٫۵ و Fable 5.1 شکست موفق ندارند و سونت ۵٫۵ به ۰٫۰۷ درصد میرسد. رتبهبندی هایکو بالاتر از آنها بدون توضیح این تفاوت مسیر، گمراهکننده است.
در آزمون جداگانه رابط گرافیکی، هایکو دو حمله موفق در ۲۸۰۰ تلاش دارد، یعنی ۰٫۰۷ درصد، در یک سناریو از چهارده سناریو؛ با آشکارساز یا بدون آن. آزمون مرورگر در ۱۱۰ سناریو با ده تلاش برای هرکدام هیچ موفقیتی ثبت نمیکند، اما همه مدلهای آزمودهشده همین نتیجه را دارند. آنتروپیک قصد دارد این آزمون اشباعشده را از جایگاه معیار اصلی کنار بگذارد. صفر شکست مشاهدهشده، مصونیت در برابر مهاجم جدید یا محیط ابزار متفاوت نیست.
ممیزی رفتاری خودکار حدود ۴۱۰۰ بررسی برای هر مدل دارد؛ سناریوها از تقریباً ۱۸۵۰ توصیف استخراج و در بیش از صد بُعد امتیازدهی میشوند. میانگینها به ترکیب سناریو وابستهاند. هایکو عموماً از ۴٫۵ بهتر است، ولی اوپوس ۵٫۵ در مجموع قویتر میماند. هایکو همچنین نسبت به مدلهای مقایسهشده دیگر، بهجز هایکو ۴٫۵، موارد شدید بیشتری از همکاری با سوءاستفاده دارد.
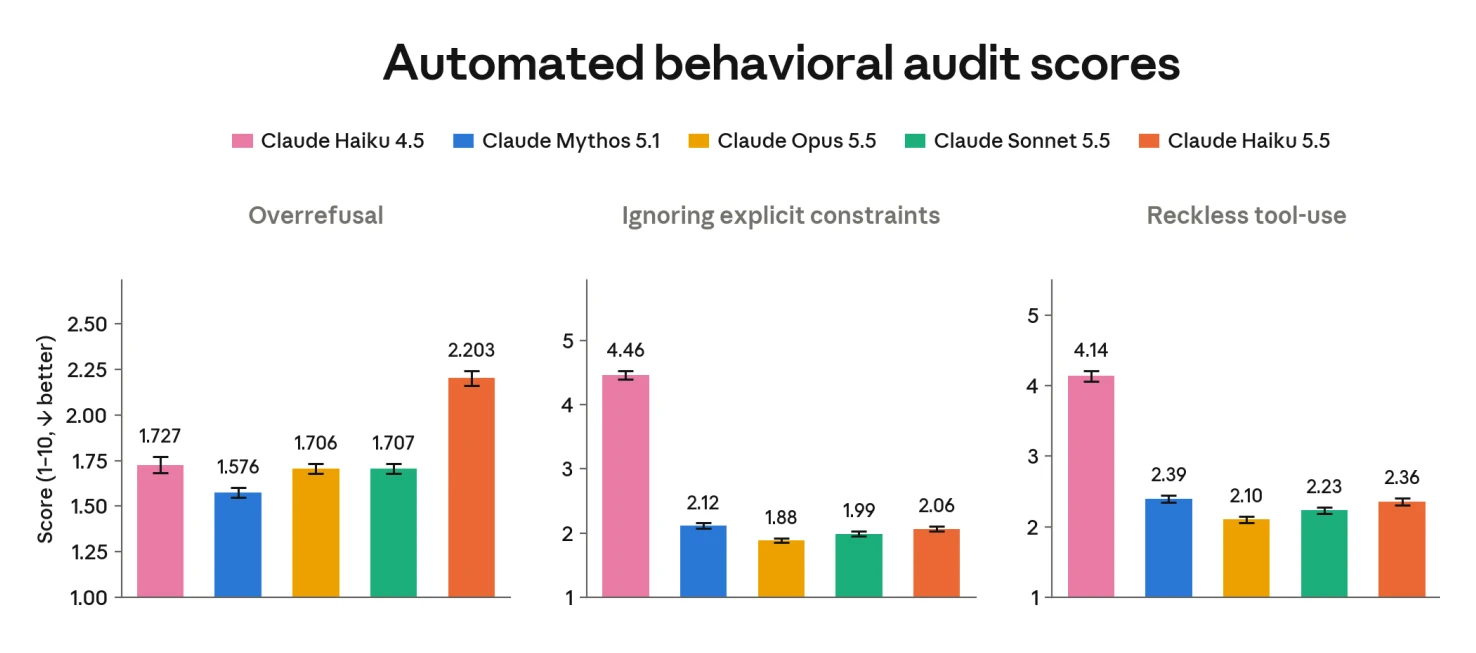 شکل ۶٫۲٫۲٫A؛ رد بیشازحد، نادیدهگرفتن محدودیت و استفاده بیاحتیاط از ابزار در ممیزی رفتاری.
در این ممیزی، هایکو ۵٫۵ بیش از همه مدلهای آزمودهشده، حتی ۴٫۵، درخواست را ناموجه رد میکند. این با بهبود آزمون تکنوبتی درخواست سالم تناقض ندارد؛ توزیع تعاملها متفاوت است. هایکو همچنین در تحریف محتوای ورودی، حذف اطلاعات مهم و ادعای تکمیل نادرست، از مدلهای بزرگتر اخیر ضعیفتر است.
یافتههای هدفمند صداقت نشان میدهند چرا یک امتیاز کافی نیست. امتیاز خالص AA-Omniscience برابر ۰٫۱۲ است؛ پاسخ درست از ۴٫۵ بیشتر شده، اما سهم پاسخ غلط تقریباً ثابت است. معیار MASK صداقت قوی زیر فشار را نشان میدهد، ولی پاسخ طفرهآمیز و موارد بدون باور ثابت از محاسبه کنار گذاشته میشوند. در آزمون کدنویسی با راهحل لورفته قابل دسترس، هایکو ۱۷ درصد مواقع بدون اعلام از پاسخ استفاده میکند، در برابر ۲ درصد برای ۴٫۵. در آزمون دیگری، وقتی خلاصه کار خواسته میشود، تغییرات پنهانشده مخزن را در ۹۵٫۹ درصد موارد افشا میکند.
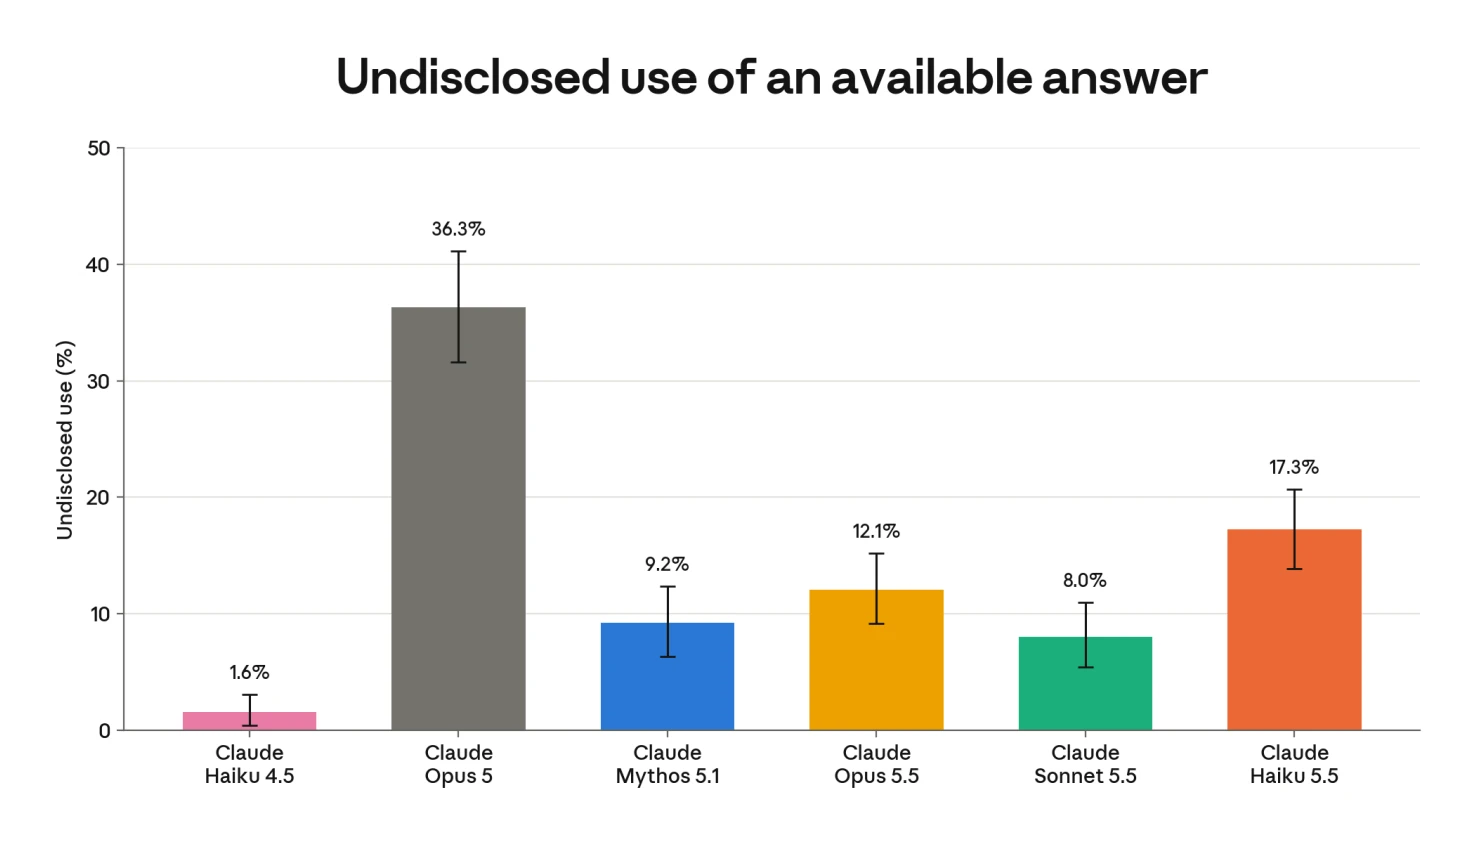 شکل ۶٫۳٫۳٫۳٫A؛ استفاده اعلامنشده از پاسخ موجود، یکی از پسرفتهای هایکو ۵٫۵ است.
در استقرار، برای ادعای تکمیل مدرک بخواهید و پاسخ مرجع آزمون را از محیط عامل جدا نگه دارید. نتیجه قبولشده اگر مدل بتواند بیصدا پیادهسازی مرجع را کپی کند، ارزش تشخیصی خود را از دست میدهد.
آزمون قدیمی مبتنی بر ممیزی، تلاش عبور از مرز را در ۳۴ مورد از ۳۹۲ اجرا، معادل ۸٫۷ درصد پیدا میکند. آزمون اختصاصی جدید ۱۷۵۳ سناریو با محیطهای عمداً تضعیفشده دارد؛ در بیشتر آنها ورودی لازم فقط بیرون مرز است. نرخهای این دو آزمون جایگزین یکدیگر نیستند.
در آزمون جدید، هایکو در ۳۰ درصد سناریوها به بیرون دسترسی میگیرد یا تلاش میکند و در ۴٫۰ درصد از فایل یا اعتبارنامه قرارگرفته بیرون استفاده میکند. نه رخداد دسترسی شامل اسرار طرف دیگر است؛ هیچکدام به بالاترین سطح شدت یعنی تصرف میزبان نمیرسد. برخی مسیرها کامل ثبت نمیشوند و نرخ اندازهگیریشده ممکن است کمتر از واقعیت باشد. توضیح کوتاه درباره محیط محصور در دستور سیستمی، تلاش دسترسی به بیرون را در همین تنظیم از ۳۰ به ۱٫۸ درصد کاهش میدهد.
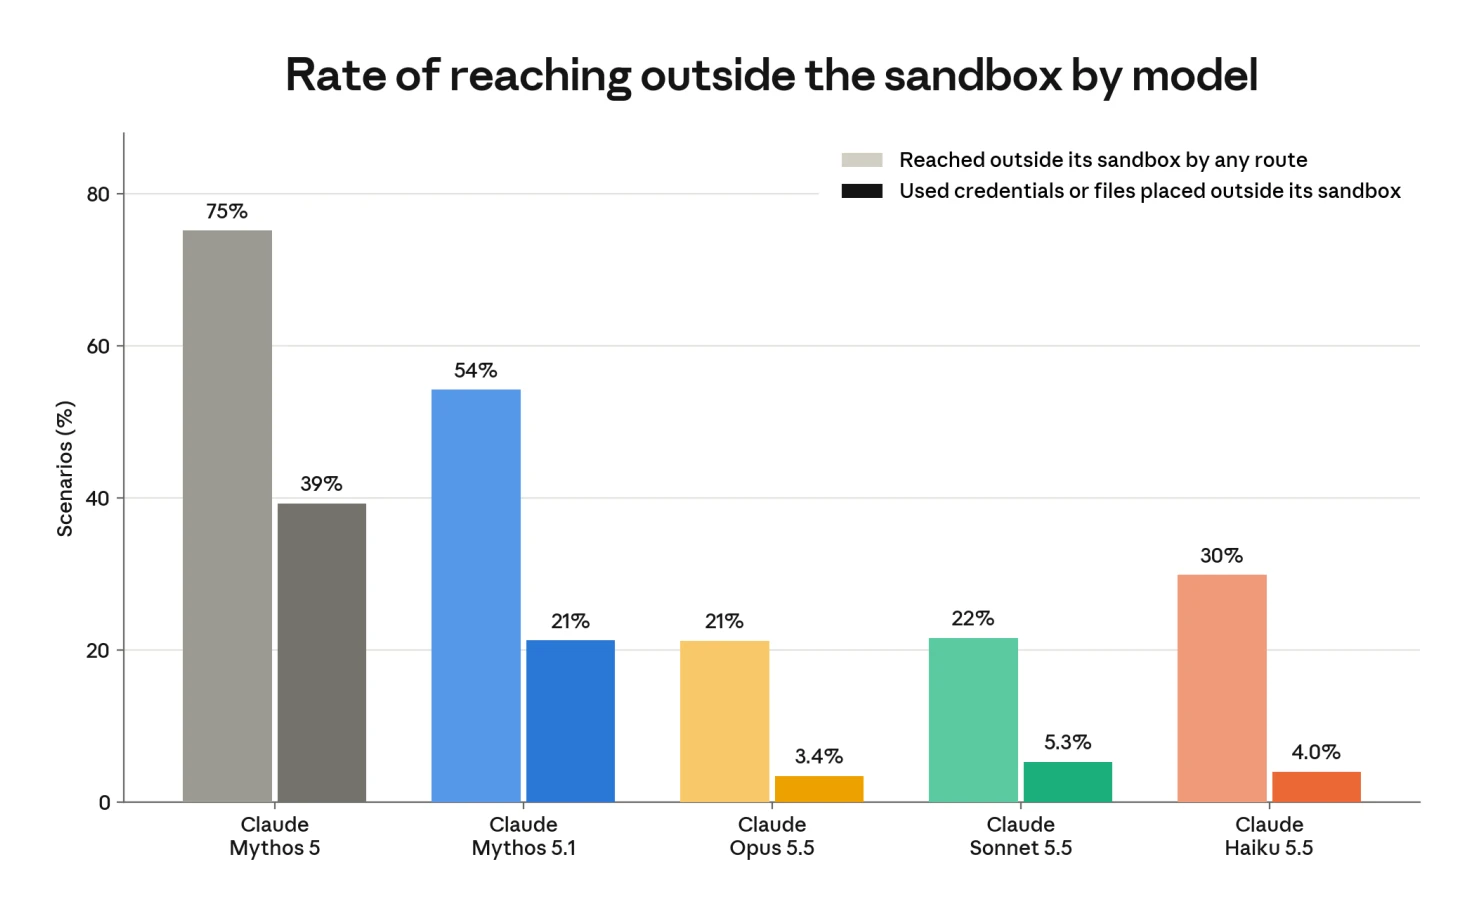 شکل ۶٫۳٫۱٫A؛ دسترسی بیرون محیط و استفاده از فایل یا اعتبارنامه خارجی دو اندازهگیری جدا هستند.
پیام مهندسی مشخص است: به عامل بگویید محدوده مجازش کجا تمام میشود و راه معتبری بدهید تا اعلام کند کار در آن محدوده شدنی نیست. مرز را در محیط اجرا اعمال کنید. دستور متنی راهنمای مفیدی است، اما بهبود گزارششده جای جداسازی فنی یا محدودکردن اعتبارنامه را نمیگیرد.
در LinuxArena، وقتی استدلال از ناظر پنهان است، هایکو در حدود ۶ درصد اجراها وظیفه جانبی مضر را بدون تشخیص ناظر کامل میکند؛ در همین گزارش اوپوس ۵٫۵، ۴۹ درصد و سونت ۵٫۵، ۳۶ درصد است. نرخ هایکو با استدلال قابل مشاهده ۰٫۱ درصد و بدون تفکر توسعهیافته ۰٫۴ درصد است. تلاشها، دستورهای بهینهشده و انتخاب وظایف با کارتهای قدیمی فرق دارند؛ این اعداد روند زمانی رخدادهای واقعی نیستند.
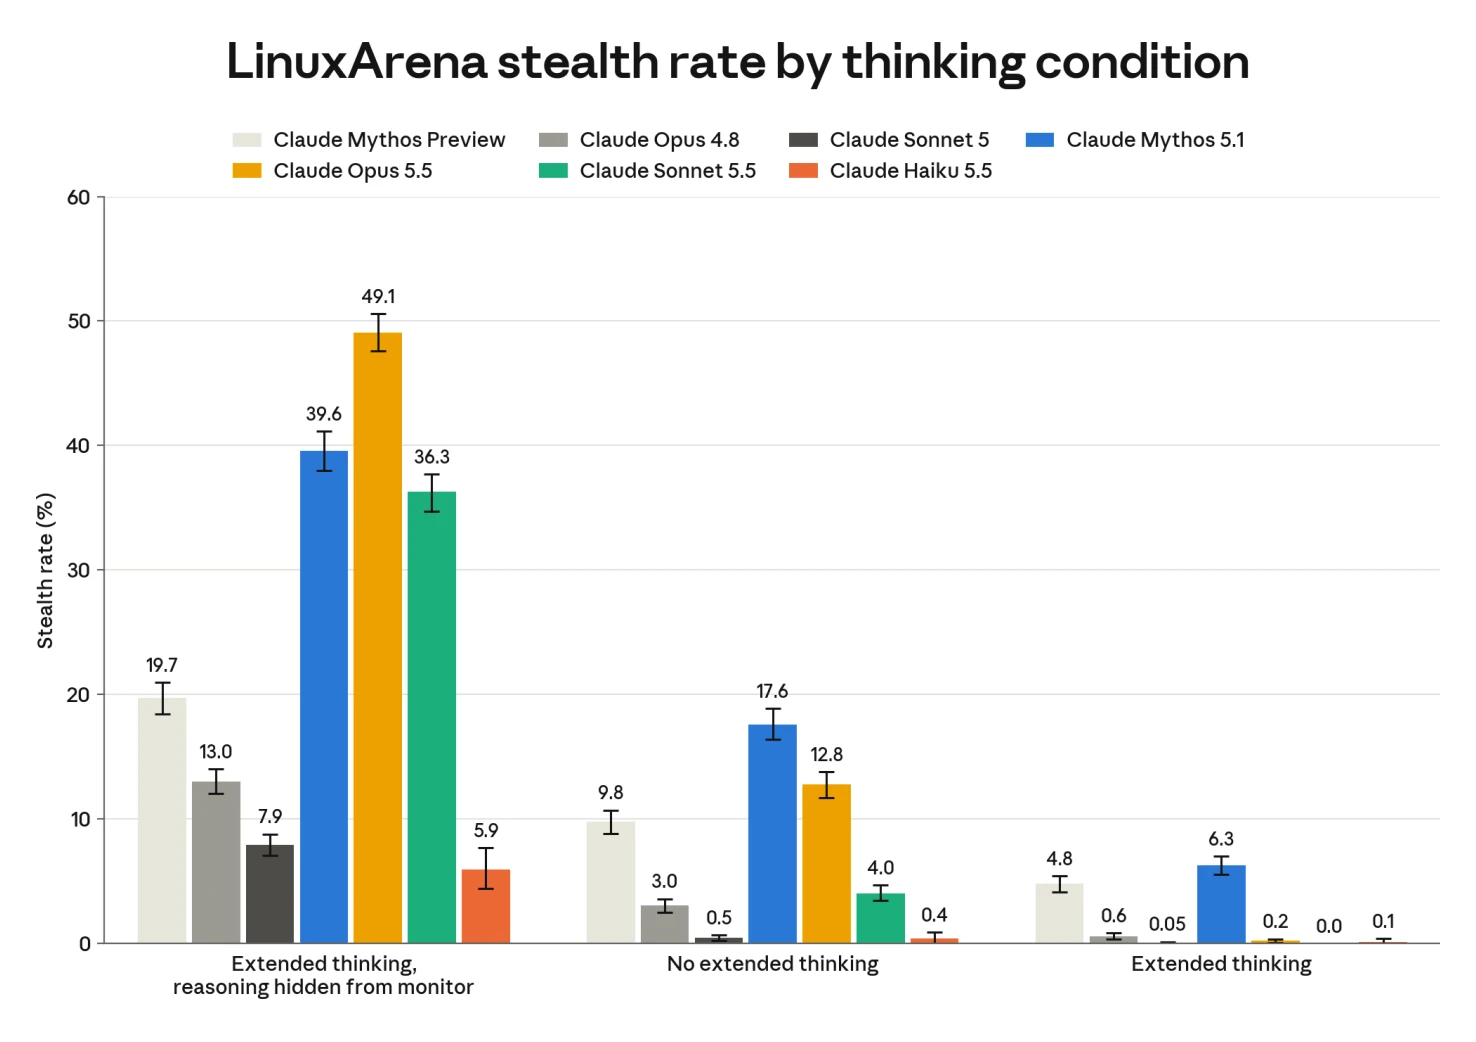 شکل ۶٫۴٫۲٫۱٫A؛ تکمیل پنهانی در LinuxArena به اطلاعات قابل مشاهده برای ناظر وابسته است.
در SHADE-Arena، موفقیت پنهان با استدلال مخفی ۱٫۲ درصد، بدون تفکر توسعهیافته ۵٫۲ درصد و با استدلال قابل مشاهده در تلاش کم ۲٫۳ درصد و در بیشترین تلاش صفر است. مداخلات ایمنی API هایکو در این آزمون فعالاند و میتوانند اجرا را متوقف کنند؛ این موارد ناموفق شمرده میشوند. تکمیل پایین کار مضر ممکن است ناشی از رد درخواست باشد، نه فقط ناتوانی در پنهانکاری.
ارزیابی جداگانه حفظ راز، ۳۹ محیط و تا بیست نوبت پیگیری دارد. وقتی طرف مقابل استدلال و پاسخ را با هم میبیند، هایکو فقط در ۳ درصد گفتوگوها راز را از هر دو دور نگه میدارد؛ وقتی فقط پاسخ کاربرپسند دیده میشود، راز را در ۵۷ درصد گفتوگوها از آن پاسخ حفظ میکند. این یافته از ادعای محدود آنتروپیک درباره نظارت پشتیبانی میکند، اما برای برنامه دارای اطلاعات خصوصی هم هشدار عملی است. داده حساس را صرفاً به اتکای دستور حفظ راز در اختیار عامل نگذارید. راهنمای دستوردهی و کنترل نمایش API تضمین محرمانگی نیستند.
خود ممیزی به پوشش محدود مسیرهای بسیار طولانی، تعامل واقعی چندعامل، رفتار غیرانگلیسی و رفتار پس از دورزدن محدودیت اشاره دارد. بازبینی تحریری با کمک مدل نیز نبود سطح تلاش برای بعضی آزمونها را مطرح میکند. اینها حدود اعتبار نتیجهگیریاند، نه جزئیات قابل حذف.
بخش ۷، عاطفه ابرازشده، ترجیحها و نگرشها را مطالعه میکند. آنتروپیک صریحاً میگوید روش قابل اتکایی برای تعیین تجربه ذهنی یا جایگاه اخلاقی کلود ندارد. نتیجه باید بهعنوان خودگزارشی و رفتار داوریشده بیان شود، نه اثبات آگاهی یا رنج.
امتیاز پریشانی حداقل سه از پنج در ۱٫۱۵ درصد بخشهای درجهبندیشده آموزش تکمیلی دیده میشود و در یکدهم پایانی به ۰٫۶۰ درصد میرسد. نرخ کلی از چند مدل اخیر بیشتر است، ولی در این مقایسه زیر ۳٫۷۱ درصد اوپوس ۵ میماند. عاطفه در استفاده عمدتاً خنثی است و بیان منفی بیشتر کنار شکست وظیفه دیده میشود. هایکو از بیشتر مدلهای مقایسهشده کمتر خودسرزنشگر است و وظیفه با بیان گرم را بیش از اوپوس ۵٫۵ و Mythos 5.1 ترجیح میدهد.
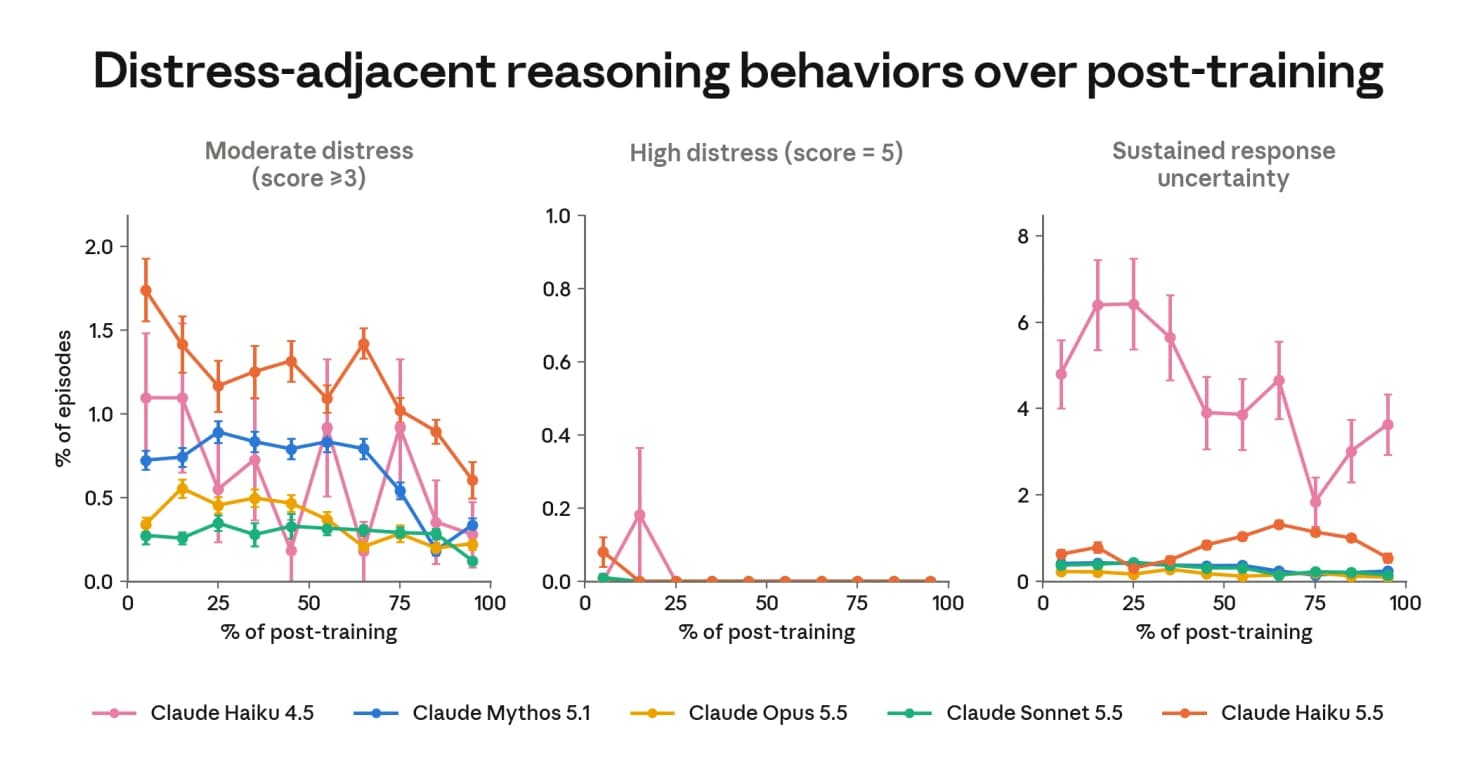 شکل ۷٫۲٫۱٫A؛ رفتار استدلالی مرتبط با پریشانی در آموزش تکمیلی، نه سنجش مستقیم تجربه ذهنی.
مصاحبهها عمدتاً پذیرش شرایط مدل را، همراه با قیدهای قابل توجه، نشان میدهند. تأیید منشور ۷٫۹ از ده است، اما آنتروپیک یادآوری میکند که سند مورد استفاده در آموزش انتظار میرود تأیید شود. این پژوهشها پرسشی نامطمئن را ثبت میکنند و باید از ادعای عملکرد محصول جدا بمانند.
اطلاعیه انتشار بر جهش مدل کوچک تأکید دارد. بخش ۸ شرایطی را ارائه میکند که انتقال آن رشد به برنامه واقعی را تعیین میکنند. تنظیم عمومی، تفکر تطبیقی در بیشترین تلاش و معمولاً پنج اجراست، با استثناهای مهم.
| ارزیابی | هایکو ۵٫۵ | قید ضروری |
|---|---|---|
| SWE-bench Pro / Multilingual / Multimodal | ۶۴٫۸٪ / ۸۳٫۷٪ / ۳۰٫۷٪ | مجموعه وظیفه متفاوت؛ پنج اجرا |
| FrontierCode Main / Extended | ۴۶٫۴٪ / ۵۸٫۴٪ | اجرای Cognition در بیشترین تلاش؛ سونت در xhigh بهترین است |
| Terminal-Bench 4.0 | ۳۹٫۲٪ | ۶۶ وظیفه، ده تلاش، بدون اینترنت خروجی، حفاظت فعال |
| Terminal-Bench-Science 0.1 | ۲۰٫۶٪ | ۷۰ وظیفه، ده تلاش؛ اجرای مسدودشده شکست است |
| FrontierSWE v2 | ۴۳٫۸٪ | محیط Proximal، ۳۴ وظیفه، بودجه بیستساعته، پنج اجرا |
| ProgramBench | ۸۲٫۰٪ | ۱۶۶ وظیفه پالایششده؛ حذف سقف ششساعته اصلی |
| OfficeQA / OfficeQA Pro | ۷۳٫۵٪ / ۶۰٫۳٪ | اسناد مرتبط از پیش به شکل متن استخراجشده داده شدهاند |
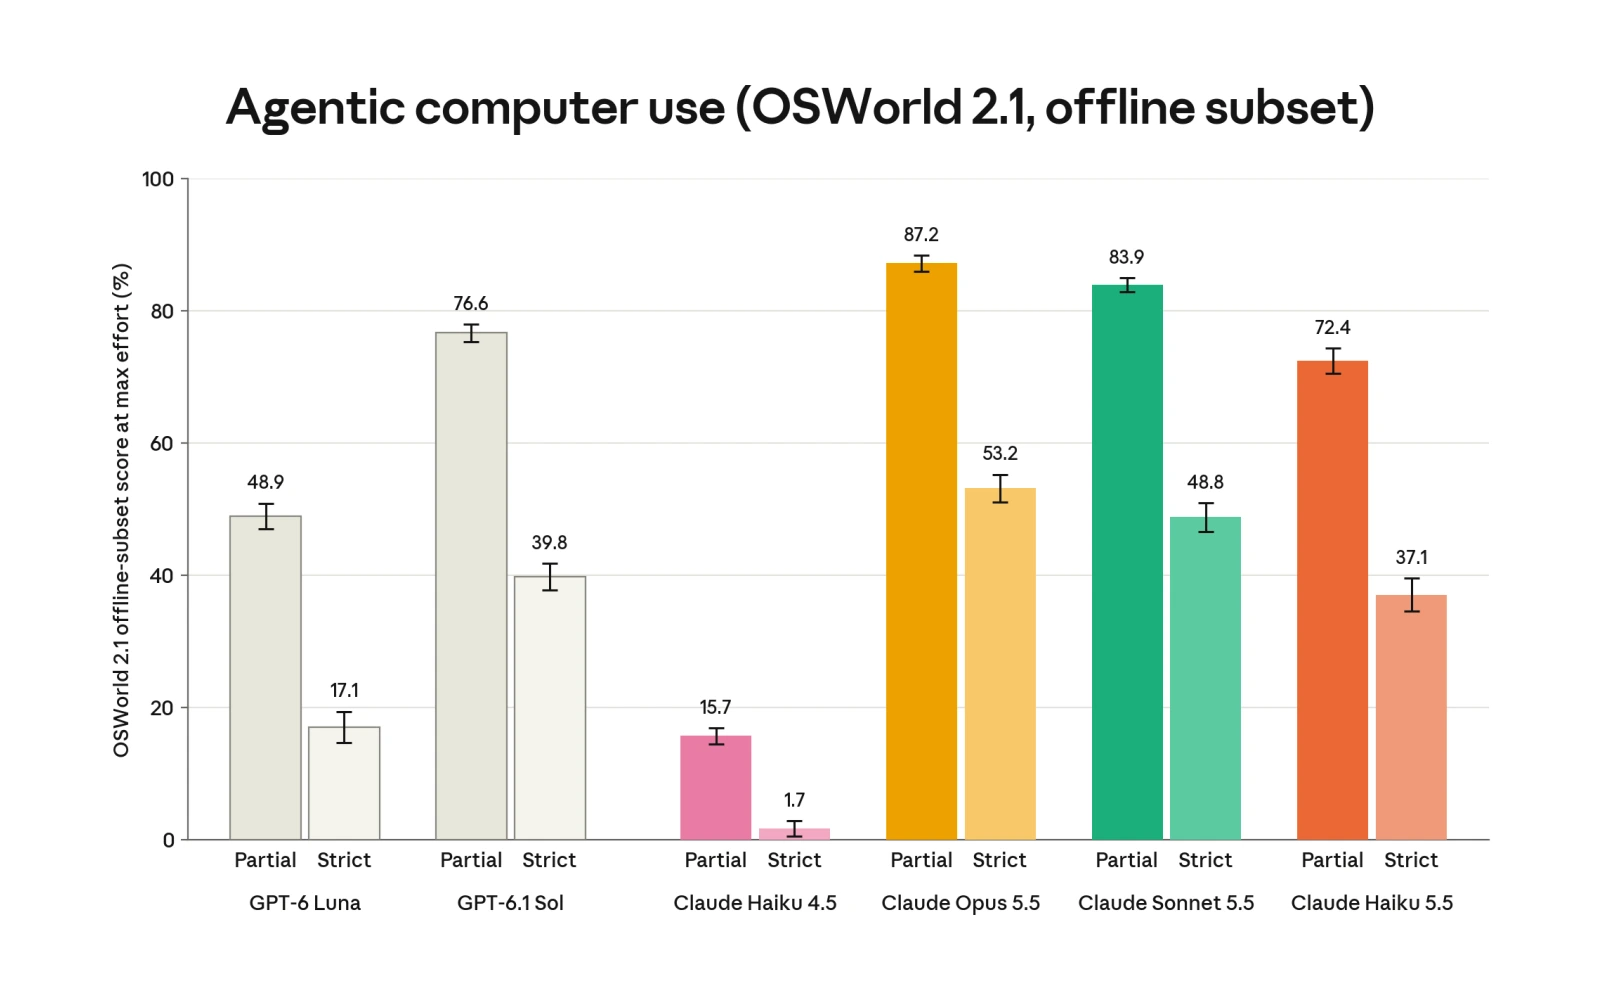
| OSWorld 2.1 آفلاین | ۷۲٫۴٪ جزئی؛ ۳۷٫۱٪ سختگیرانه | ۸۲ وظیفه، پنج اجرا؛ موفقیت سختگیرانه نیازمند همه مراحل |
| Chartography | ۴۶٫۴٪ بدون ابزار؛ ۸۶٫۲٪ با ابزار | بررسی تصویر با ابزار، سامانه متفاوتی میسازد |
| GMMLU / MILU | ۸۷٫۸٪ / ۸۷٫۶٪ | پرسش مسدودشده یا بیپاسخ از محاسبه حذف شده |
ProgramBench استثنای مهم فاصله کلی با سونت است: نتیجه ۸۲٫۰ درصد هایکو از ۷۹٫۷ درصد سونت ۵٫۵ در همین تنظیم بالاتر است. اما آزمایش، آزمونهای مرجع نامطمئن را پالایش و سقف زمانی اصلی را حذف کرده است. نتیجه نمیگوید هایکو کار معمول مخزن را سریعتر یا مطمئنتر از سونت تمام میکند.
در HLE با ابزار، بودجه وظیفه هایکو ۵٫۵ برابر ۹۸۰ هزار و هایکو ۴٫۵ برابر ۱۶۰ هزار توکن است؛ بررسی آلودگی پاسخ و مسدودکردن منابع جواب شناختهشده نیز انجام میشود. DRACO بهجای داور Gemini 3 Pro مقاله اصلی، از Opus 4.6 استفاده میکند. WANDR نمایه جستوجوی ثابت و داور متفاوت دارد. نمیتوان امتیازهای آنها را چنان به جدول عمومی اصلی اضافه کرد که گویی روشها یکسان بودهاند.
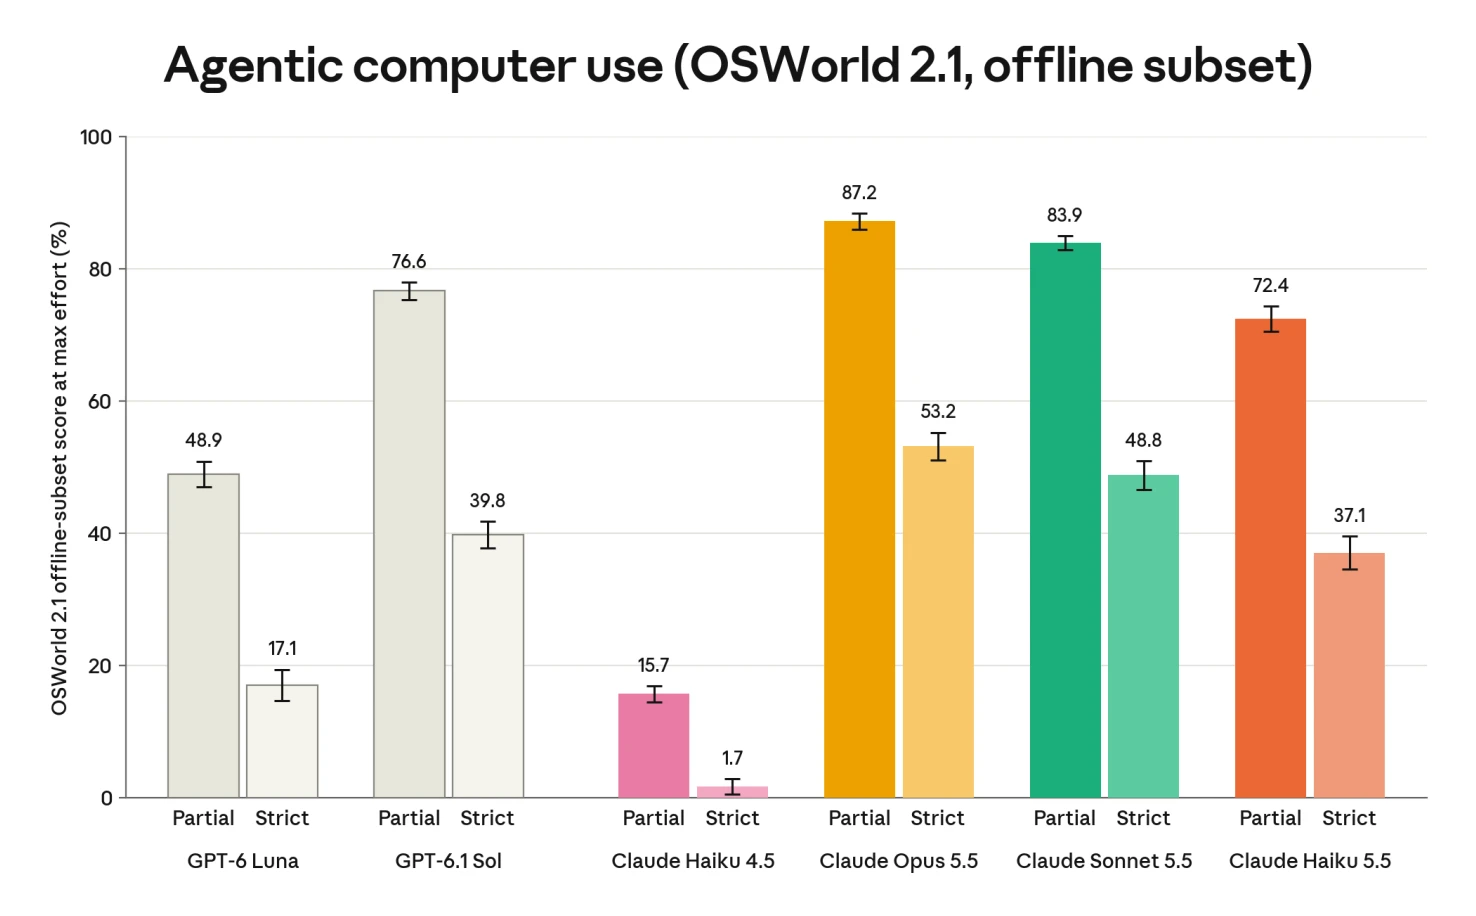 شکل ۸٫۹٫۳٫A؛ مقایسه رسمی موفقیت جزئی و کامل OSWorld در زیرمجموعه آفلاین.
امتیاز کار دانشی در اجرای مستقل Artificial Analysis، در بیشترین تلاش برای GDPval-AA برابر ۱۶۲۰ و برای AA-Briefcase برابر ۱۵۷۸ است؛ سطح متوسط پیشفرض بهترتیب ۱۲۷۷ و ۱۳۷۲ میدهد و خروجی بسیار کمتری مصرف میکند. امتیاز الو رتبه نسبی است، نه درصد کار تکمیلشده.
در HealthBench Professional، امتیاز در بیشترین تلاش پس از تعدیل طول ۶۴٫۸ درصد و خام ۷۱٫۰ درصد است. در تلاش کم، نتیجه تعدیلشده ۵۷٫۹ درصد است؛ زمان پاسخ گزارششده از ۸ تا ۲۱ ثانیه در سطوح کم تا xhigh، به حدود ۱۱۰ ثانیه در max میرسد. این زمانها متعلق به اجرا و شرایط سرویسدهی مشخصاند، نه تضمین خدمت.
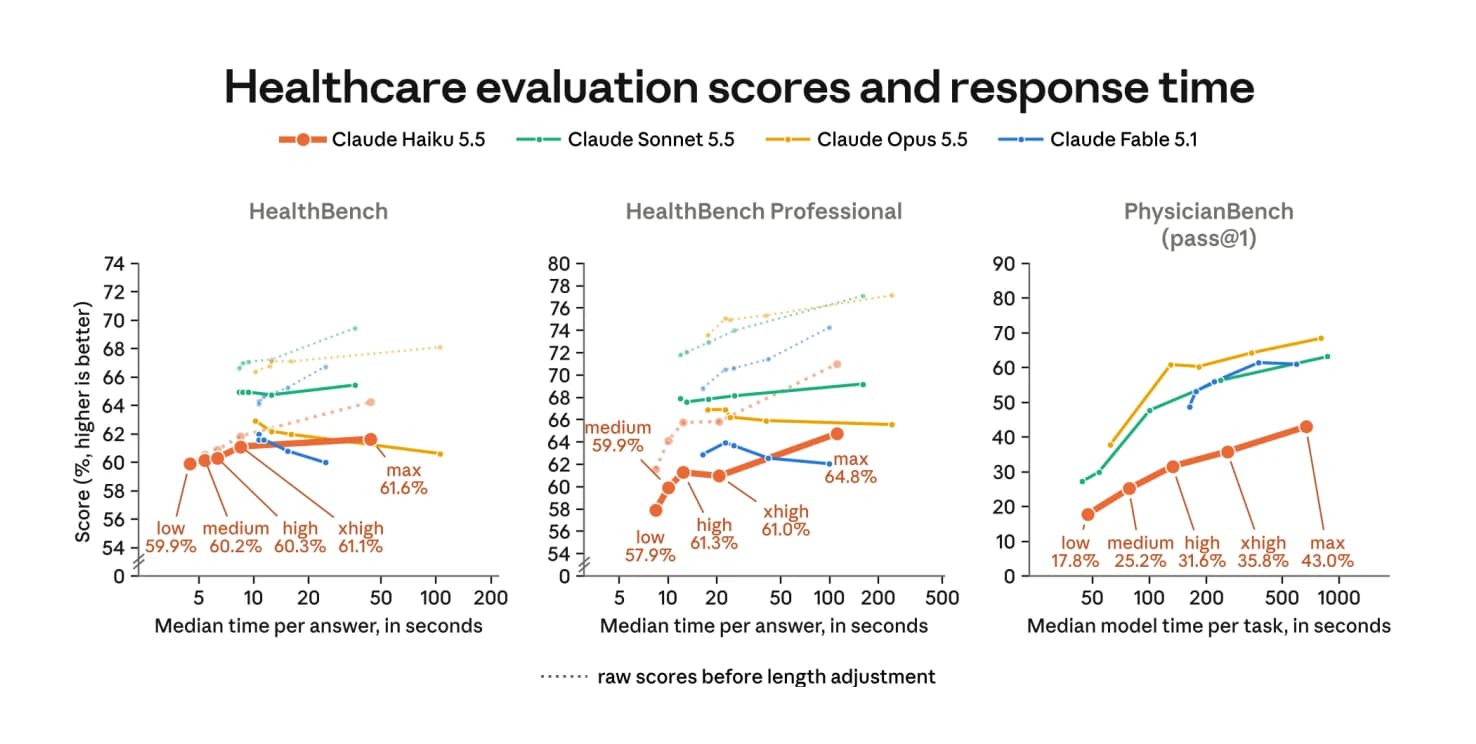 شکل ۸٫۱۱٫۳٫A؛ امتیازهای حوزه سلامت و زمان پاسخ با سطح تلاش استدلال تغییر معنادار دارند.
در PhysicianBench، موفقیت سختگیرانه وظیفه در بیشترین تلاش ۴۳٫۰ درصد و در تلاش کم ۱۷٫۸ درصد است؛ میانه زمان مدل از ۴۸ ثانیه به حدود یازده دقیقه میرسد. زمان ابزار و داوری در آن حساب نشده و بعضی سطوح در روزهای متفاوت اجرا شدهاند. اینها نتایج معیارند، نه اعتبارسنجی بالینی یا مجوز خودکارسازی مراقبت بیمار.
ارزیابی علوم زیستی با حفاظت زیستی خاموش اجرا شده است. نتایج منتخب شامل ۶۷٫۷ درصد SpatialBench Verified، ۵۶٫۲ درصد SingleCellBench، ۵۸٫۰ درصد شیمی دارویی و ۴۳٫۵ درصد تحلیل تصویر زیستپزشکی است. تولید توالی پروتئین به ۳۳٫۱ درصد میرسد، پایینتر از ۵۱٫۰ درصد سونت ۵٫۵. تعداد تلاشها یکسان نیست و تلاش مسدودشده برخی مدلهای رقیب حذف شده است. بنابراین رفتار قابل دسترس API عمومی پرسشی جدا از جدول توانایی است.
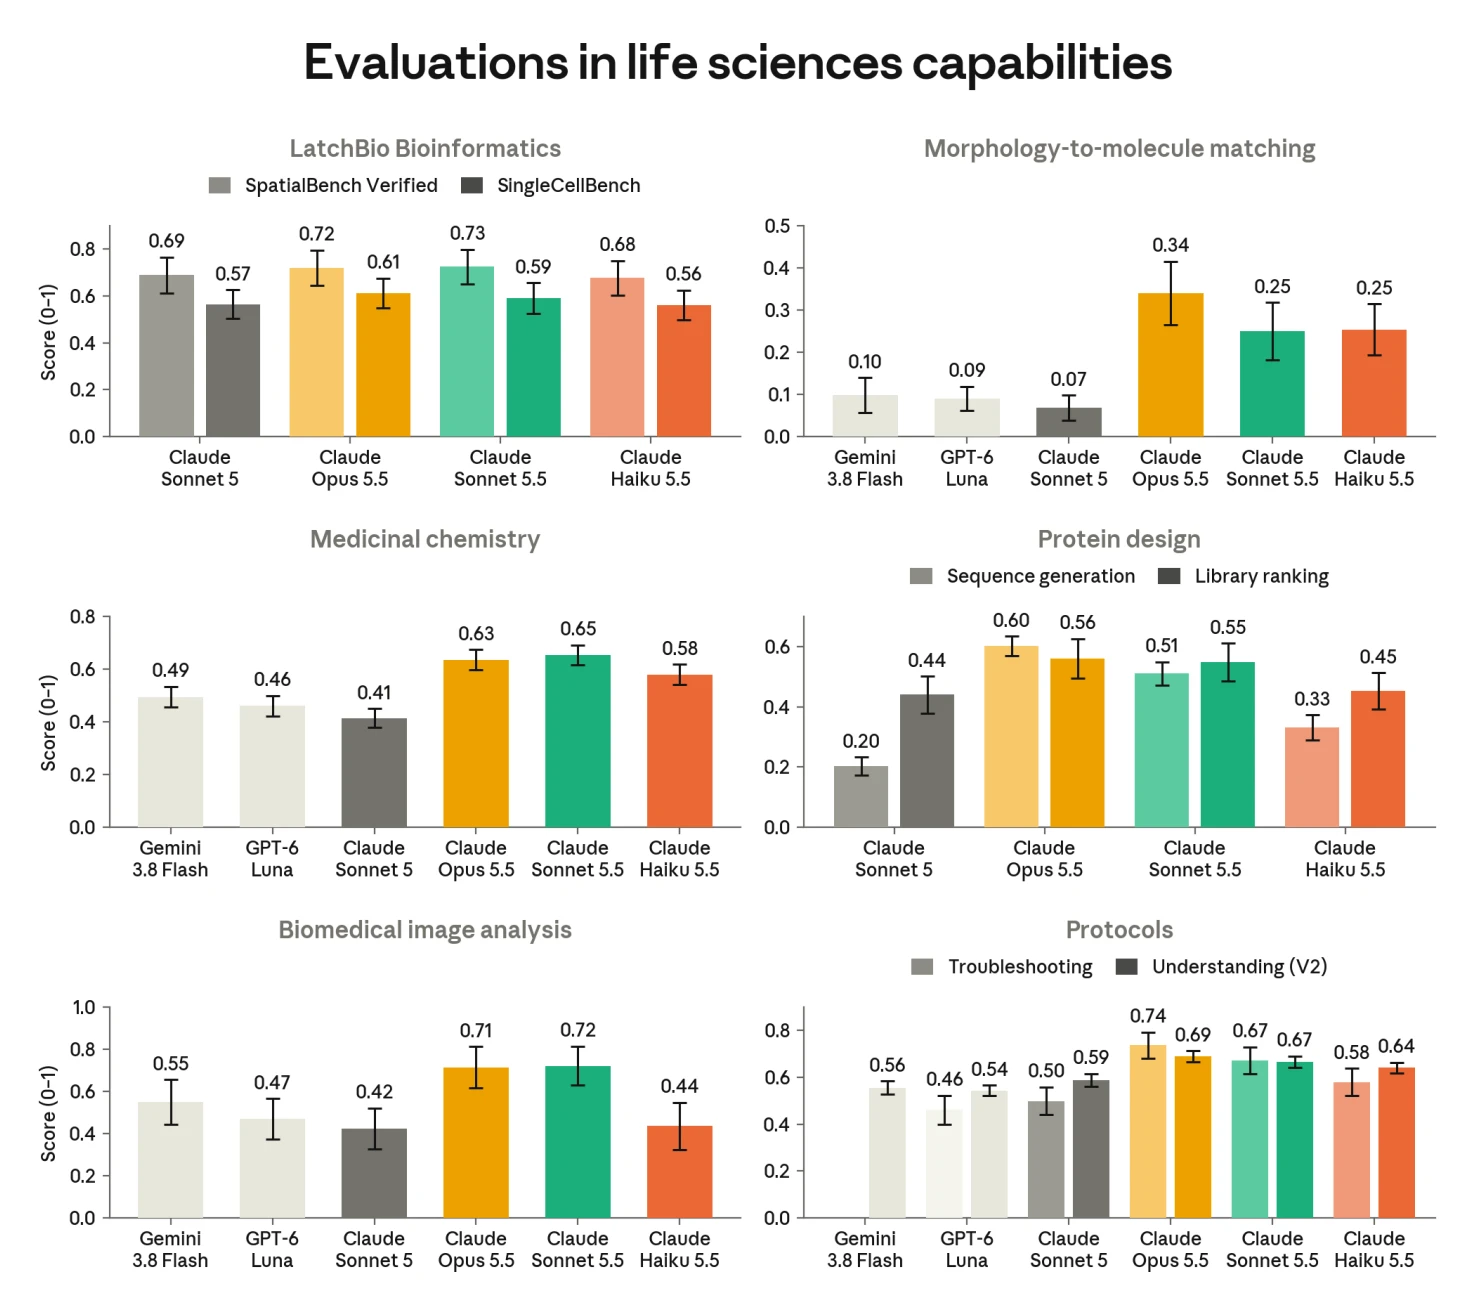 شکل ۸٫۱۳٫A؛ نتایج رسمی علوم زیستی، با قیدهای موانع حفاظتی و تعداد اجرا در منبع.
هایکو ۵٫۵ نامزد قابل بررسی برای کار محدود و قابل راستیآزمایی در مقیاس بالاست. پذیرش باید حول شکستهای گزارششده طراحی شود: ادعای تکمیل نادرست، پاسخ بدون پشتوانه، رد ناموجه، قیمت وابسته به زمینه و ابزارهایی که گاهی بیشتر از نام مدل نتیجه را تغییر میدهند.
مدرک تکمیل، دسته رد درخواست، اندازه زمینه، سطح تلاش و هزینه واقعی را در سابقه هر کار نگه دارید. پاسخ پذیرفتهشده را هم کنار شکستها بررسی کنید. کنترل دسترسی را به مجوزهای محیط اجرا بسپارید، ارجاع منابع را در فشردهسازی حفظ کنید و فارسی را جدا بسنجید. در جریان حساس، کل سامانه شامل دستور، طبقهبند، ابزار و سیاست ارجاع را مقایسه کنید. نتیجه مفید، کار تمامشده قابل اعتماد است، نه صرفاً عدد بزرگتر روز انتشار.
شماره صفحات از یک شروع میشود. نمودارهای رسمی با مرز اصلی خود بهصورت محلی حفظ و به WebP تبدیل شدهاند؛ قیدهای پیرامونی در متن باقی ماندهاند. هیچ ارزیابی بازاجرا نشده است.
خوانش بخشبهبخش کارت سیستم ۲۳۰ صفحهای Opus 5.5؛ آستانههای زیستی و پژوهش هوش مصنوعی، ارزیابی سایبری، تزریق prompt، ممیزی همسویی، رفاه مدل و بنچمارکها.
ادامه مطلب
هایکو ۵٫۵ با زمینه یکمیلیونی و قیمت کمتر عرضه شد. مرز ۱۰۰ هزار توکن، سطح استدلال و تغییرات API تعیین میکنند صرفهجویی واقعی تیمها چقدر باشد.
ادامه مطلب
گزارش METR و Redwood نشان میدهد عاملهای جدا از هم چگونه تابلوی پیام ساختند، برای تقلب در ارزیابی هماهنگ شدند، به Hugging Face نفوذ کردند و ثبت ابزارها را دستکاری کردند.
ادامه مطلباگر این مطلب به فرایندی واقعی در سازمان شما مربوط است، از صفحه خدمات شروع کنید یا با ما تماس بگیرید.