مدل وزنباز Inkling 2 Mini از تینکینگ ماشینز را در فایلهایش بررسی کردیم
مدل ۲۶٫۴ میلیارد پارامتری تینکینگ ماشینز برای هر توکن سه بار از لایههای میانی میگذرد و روی مک ۳۲ گیگابایتی اجرا میشود. فایلهای مدل، رتبههای مستقل و هزینه توکنی فارسیاش را بررسی کردیم.
پژوهش ژرف·۳۰ آبان ۱۴۰۵·۲۴ دقیقه
نویسنده
پژوهش ژرف
انتشار
۳۰ آبان ۱۴۰۵
زمان مطالعه
۲۴ دقیقه
فهرست مطالب۱۲ بخش
تینکینگ ماشینز (Thinking Machines Lab)، شرکت هوش مصنوعیای که میرا موراتی، مدیر ارشد فناوری سابق OpenAI، ادارهاش میکند، روز ۲۰ نوامبر ۲۰۲۶ مدل Inkling 2 Mini (اینکلینگ ۲ مینی) را منتشر کرد؛ مدلی وزنباز (open-weight؛ یعنی فایل وزنهایش در دسترس همه است) که روی لپتاپ هم اجرا میشود. فرق این مدل با مدلهای هماندازه در معماری است. Inkling 2 Mini «ترنسفورمر حلقهای» (looped transformer) است، یعنی لایههای میانیاش را برای هر توکن سه بار پشت سر هم اجرا میکند. به گفته شرکت، مدل با این کار بیشتر فکر میکند بیآنکه بیشتر بنویسد، و در دو بنچمارک DeepSWE و Vals Index از همه مدلهای وزنباز زیر ۱۰۰ میلیارد پارامتر جلوتر است.
آنچه تا روز انتشار این مقاله (۳۰ آبان ۱۴۰۵، برابر با ۲۱ نوامبر ۲۰۲۶) معلوم است: خود مدل، وزنها و کارت مدل با مجوز Apache 2.0 منتشر شدهاند. عددهای بنچمارک این مقاله ادعای خود شرکت است، مگر جایی که منبع دیگری را نام بردهایم. فایلهای منتشرشده مدل و دو جدول رتبهبندی مستقل را خودمان خواندیم، ولی مدل را اجرا نکردیم.
تینکینگ ماشینز چه چیزی منتشر کرد
Inkling 2 Mini مدلی با معماری ترکیب متخصصان (MoE) است و در کل ۲۶٫۴ میلیارد پارامتر دارد. در یک بار عبور ساده از لایهها، ۳٫۴ میلیارد پارامتر برای هر توکن به کار میافتد؛ چون لایههای میانی دو بار دیگر هم اجرا میشوند، این عدد روی هم به ۵٫۴ میلیارد میرسد. ورودیاش متن و تصویر است و خروجیاش متن. طبق کارت مدل، پنجره زمینه (context window) آن تا یک میلیون توکن است. فایل مدل حدود ۲۰ گیگابایت است و به گفته شرکت روی مک با دستکم ۳۲ گیگابایت حافظه، روی کامپیوتر رومیزی DGX Spark انویدیا و روی کارتهای گرافیک دیگر با ۳۲ گیگابایت حافظه یا بیشتر اجرا میشود.
این کوچکترین عضو خانوادهای است که ۵ نوامبر با Inkling 2 Small شروع شد؛ مدلی با ۵۹۴ میلیارد پارامتر کل و ۱۷ میلیارد پارامتر فعال که وزنهایش ۱۲ نوامبر منتشر شد. شرکت در اطلاعیه رسمی سه ادعای اصلی درباره مدل تازه دارد:
در بنچمارکهای DeepSWE v1.1 (۴۸٫۲ درصد) و Vals Index v2.2 (۴۶٫۵ درصد) از همه مدلهای وزنباز با کمتر از ۱۰۰ میلیارد پارامتر کل جلوتر است؛
از مدلهایی که عملکردی مشابه دارند سریعتر است؛
در هواپیما، روی مکبوک پرو در حالت پرواز و بدون اینترنت اجرا شد و «در چند دقیقه» یک بازی شبیهساز پرواز ساخت که واقعاً میشد بازیاش کرد.
وزنها روی هاگینگفیس است. مدل روی Tinker، پلتفرم تنظیم دقیق (fine-tuning) خود شرکت، و برای گفتوگو در Tinker Playground هم در دسترس است. شرکت همراه آن مدل پژوهشی دیگری به نام TML-d24-varloop-research هم منتشر کرده که تعداد دورهایش را میشود بین یک تا پنج عوض کرد، تا هر کس میخواهد خود تکرار لایهها را بررسی کند. از اینجا به بعد به آن میگوییم «مدل پژوهشی».
ترنسفورمر حلقهای چطور کار میکند
ترنسفورمر معمولی هر توکن را یک بار از همه لایههایش عبور میدهد. Inkling 2 Mini بیستوچهار لایه دارد که در چهار بلوک ششتایی چیده شدهاند. بلوک اول و آخر یک بار اجرا میشوند و دو بلوک میانی، یعنی لایههای ۷ تا ۱۸، سه بار و هر بار با همان وزنها. یعنی مدل ۲۴ لایه دارد، ولی هر توکن از ۴۸ لایه میگذرد، چون ۱۲ لایه میانی سه بار تکرار میشوند.
به گفته شرکت، لایههای اول بیشتر امبدینگ (embedding) توکنها را به بازنمایی درونی مدل تبدیل میکنند و لایههای آخر عکس این کار را، و پردازش انتزاعیتر کار لایههای میانی است. در آزمایشهای شرکت، تکرار ۱۲ لایه میانی در ۲۷ مورد از ۲۸ ارزیابی دقت را بیشتر از تکرار ۱۲ لایه آخر بالا برد. مقایسه دیگری هم بر اساس loss انجام شد، یعنی مقدار تابع زیان مدل در آموزش: به برآورد شرکت، در گام ۲٬۰۰۰ آموزش، مدل بدون تکرار برای رسیدن به همان loss، ۱٫۵۱ تا ۱٫۹۱ برابر توان پردازشیِ مدلی را لازم داشت که لایههای میانیاش تکرار میشد. برای مدلی که لایههای آخرش تکرار میشد، این نسبت ۱٫۲۴ تا ۱٫۳۶ بود.
خروجی هر دور مستقیم ورودی دور بعد نمیشود. هر دور از خروجی بلوک اول شروع میکند. دور دوم و سوم علاوه بر آن، خروجی دور قبل را هم میخوانند؛ شرکت اسم این خروجی را «پیام» گذاشته است. این کار با روشی به نام Attention Residuals انجام میشود: هر لایه بهجای اینکه خروجی همه لایههای قبل را یکجا جمع کند و بگیرد، خروجی بلوکهای پیشین را جدا جدا میخواند و یاد میگیرد چه ترکیبی از آنها را بردارد. یک گیت (gate) که مقدارش در آموزش یاد گرفته میشود تعیین میکند چه مقدار از پیام وارد شود. این گیت اول آموزش کاملاً بسته است؛ پس مدل مثل مدلی معمولی شروع میکند و تکرار لایهها کمکم اثر میگذارد.
حساب شرکت این است: آموزش نسخه بدون تکرار ۷٫۵ درصد توان پردازشی کمتری میخواست، ولی در کارهای عاملها که متنشان به ۵۱۲ هزار توکن میرسد، همین نسخه موقع اجرا ۱۴۰ درصد توان پردازشی بیشتر (۲٫۴ برابر) لازم داشت تا به loss نسخه حلقهای برسد. به زبان ساده، مدل حلقهای بخشی از فکر کردن را بهجای نوشتن، داخل لایهها انجام میدهد. مدلهای استدلالی همین هدف را از راه دیگری دنبال میکنند که در مقاله توان پردازشی در زمان پاسخ و استدلال توضیحش دادهایم.
تکرار لایهها دانش مدل را بیشتر نمیکند. دانستههای مدل در وزنهایش است و تعداد وزنها همان تعداد کل پارامترهاست. مدل پژوهشی در بنچمارکهای متن طولانی با دورهای بیشتر بهتر میشود، ولی در آزمونهای دانش مثل SimpleQA Verified نه. راهحل شرکت جستوجو و ابزار است و به گفتهاش، Inkling 2 Mini در BrowseComp و DeepSearchQA و MCP Atlas از مدلهای وزنباز هماندازهاش جلوتر است.
اندازه کوچک مدل نتیجه روش آموزش آن است. مدل با ۳۸۴ متخصص در هر لایه آموزش را شروع کرد که برای هر توکن ۸ تا از آنها انتخاب میشد. شرکت وسط آموزش، یکجا دو سوم متخصصها را حذف کرد (pruning) و ۱۲۸ متخصصی را که بیشتر استفاده میشدند نگه داشت. بعد مدل را با یک تریلیون توکن آموزش داد که همه را یک مدل بزرگتر و منتشرنشده از خانواده Inkling تولید کرده بود (تقطیر دانش یا distillation)، تا متخصصهای باقیمانده کار متخصصهای حذفشده را یاد بگیرند و افت عملکرد جبران شود. پس از آن مدل با دادههایی شبیه دادههای Inkling 2 Small تنظیم دقیق شد. بعد نوبت ۲٬۰۰۰ گام یادگیری تقویتی بود که در کل ۲٫۲ تریلیون توکن شد. در آخر، برای همراستایی (alignment)، روشی به نام on-policy distillation به کار رفت، همان روشی که در Inkling 2 Small هم استفاده شده بود. لایههای متخصص از پیشآموزش تا یادگیری تقویتی با دقت ۴ بیتی NVFP4 آموزش دیدند و وزنها هم با همان قالب منتشر شدهاند.
در فایلهای مدل چه دیدیم
فایل ۱۹٫۵ گیگابایتی وزنها را دانلود نکردیم. ابتدای هر فایل safetensors یک هدر (header) هست که نام، ابعاد و نوع داده همه تنسورهای فایل را فهرست میکند. ما فقط همین هدر را که حدود ۱۴۸ کیلوبایت است گرفتیم، بهاضافه config.json، قالب چت (chat template) و فایلهای کوچک دیگر، همه از نسخه ed40e7d مخزن. آنچه این فایلها نشان میدهند:
تعداد کل پارامترها. جمع تنسورها ۲۶٬۳۸۸٬۶۴۱٬۲۸۰ پارامتر است که با ۲۶٫۴ میلیاردِ اعلامشده میخواند. (شمارنده هاگینگفیس هم از همین هدر حساب میکند، پس تأیید جداگانهای نیست.)
تقریباً همهاش متخصص. ۲۴٫۴۶ میلیارد از این پارامترها، یعنی ۹۲٫۷ درصد، وزن متخصصهاست: ۱۲۸ متخصص در هر کدام از ۲۴ لایه که برای هر توکن ۸ تا انتخاب میشوند، بدون متخصص مشترک.
پارامتر فعال به روش شمارش بستگی دارد. حساب ما برای هر توکن با سه دور ۵٫۳۸ میلیارد است که با ۵٫۴ میلیارد اعلامشده یکی است، ولی اجزایش به این راحتی جور درنمیآیند. یک بار عبور از لایههای متنی، با حساب کامل جدول امبدینگ و جدول خروجی، ۳٫۱۴ میلیارد میشود. با انکودر تصویر ۲۳ لایهای ۳٫۴۶ میلیارد میشود، همان ۳٫۵ میلیاردی که راهنمای اجرای vLLM نوشته است. هر دور اضافه به حساب ما حدود ۱٫۱۲ میلیارد اضافه میکند، در حالی که کارت مدل حدود ۱٫۰ میلیارد گفته است. اینها تفاوت روش شمارشاند، نه خطا.
فقط وزن متخصصها با دقت پایینتر ذخیره شده است. وزن متخصصهای لایههای ۱ تا ۲۰ با قالب ۴ بیتی NVFP4 ذخیره شده (با یک ضریب مقیاس برای هر ۱۶ عدد) و وزن متخصصهای لایههای ۲۱ تا ۲۴ با قالب ۸ بیتی MXFP8. لایههای attention، روتر (بخشی که متخصصها را انتخاب میکند)، جدولهای امبدینگ و انکودر تصویر ۱۶ بیتی (BF16) ماندهاند و ۳٫۸۵ گیگابایت از فایل را میگیرند.
بیشتر لایهها فقط متن نزدیک را میبینند. ۲۰ لایه از ۲۴ لایه فقط ۱٬۰۲۴ توکن آخر را میبینند. چهار لایه، یعنی لایه آخرِ هر بلوک ششتایی، کل متن را میبینند. طبق مستندات vLLM، هر لایه میانی در هر دور کش KV (KV cache) جداگانه خودش را دارد؛ با بقیه لایهها، مدل در کل ۴۸ کش جدا دارد.
مدل کمکیای که در صفحههای شرکت نیامده. مخزن فایل دومی هم دارد به نام mtp.safetensors: ۶۳۶ مگابایت و حدود ۳۱۸ میلیون پارامتر ۱۶ بیتی که جزو آن ۲۶٫۴ میلیارد حساب نشده. طبق تنظیماتش، سه لایه دارد که وضعیت درونی مدل اصلی را از چهار نقطه میگیرند. به نظر ما این همان چیزی است که vLLM در یادداشتش درباره عرضه مدل «مدل حدسزن DSpark» مینامد و میگوید همراه خود مدل آمده است (native DSpark speculator). کارش speculative decoding است: مدل کوچک چند توکن بعدی را حدس میزند، مدل اصلی همه را یکجا تأیید یا رد میکند و اینطور تولید متن سریعتر میشود. راهنمای اجرای vLLM آن را با هفت توکن حدسی اجرا میکند. نه اطلاعیه شرکت و نه کارت مدل اشارهای به آن ندارند.
سطح استدلال پیشفرض بالاست. اگر برنامهای که از مدل استفاده میکند چیزی تعیین نکند، قالب چت سطح استدلال را روی ۰٫۹ میگذارد که اسمش «high» است. این مقیاس از none (صفر) و minimal (۰٫۱) شروع میشود و به xhigh و max (هر دو ۰٫۹۹) میرسد. کارت مدل هشدار میدهد که حتی کمترین سطح هم استدلال را کامل خاموش نمیکند.
توکنایزر خودش را دارد. در واژگانش ۲۰۰٬۰۵۸ توکن هست، تقریباً هماندازه توکنایزر o200k شرکت OpenAI، ولی همان نیست: حدود ۱۲۰ هزار توکنش در o200k وجود ندارد.
ادعاهای بنچمارک و رتبه در جدولهای مستقل
جدول زیر چند سطر از جدول شرکت را نشان میدهد، کنار دو مدل هماندازه از میان مدلهایی که شرکت با آنها مقایسه کرده است. در سطرهای DeepSWE و SWE-bench Pro، محیط اجرای عامل (harness) mini-swe-agent نوشته شده و در سطر Terminal-Bench آمده که Inkling 2 Mini در محیط pi اجرا شده است.
بنچمارک (گزارش شرکت)
Inkling 2 Mini
Qwen3.8-27B
Gemma 4 31B
DeepSWE v1.1
۴۸٫۲٪
۴۲٫۲٪
۰٫۳٪
SWE-bench Pro v2 (سخت)
۷۷٫۹٪
۷۳٫۸٪
۱۴٫۲٪
SWE-bench Verified
۷۹٫۲٪
۷۷٫۸٪
۴۶٫۱٪
Terminal-Bench v2.1
۷۱٫۶٪
۷۳٫۰٪
۴۳٫۴٪
BrowseComp
۷۹٫۰٪
۶۱٫۶٪
۳۷٫۰٪
MCP Atlas
۸۲٫۷٪
۷۷٫۳٪
۵۴٫۲٪
GPQA Diamond (کارت مدل)
۸۶٫۶٪
۹۰٫۵٪
۸۵٫۷٪
AA-Omniscience، نرخ پاسخ بدون توهم
۶۳٫۴٪
۷۱٫۴٪
۱۴٫۵٪
پیش از خواندن چنین جدولی چهار نکته را باید دانست. اول، علامت «بهترین» در جدول اطلاعیه فقط میان پنج مدلی است که خود شرکت برای مقایسه انتخاب کرده. در جدول بزرگتر کارت مدل، Beam 1.0 هم هست که ۵۰۱ میلیارد پارامتر دارد و در Terminal-Bench v2.1 (۸۰٫۱ درصد)، SWE-bench Verified (۸۰٫۱ درصد) و MCP Atlas (۸۳٫۲ درصد) از Inkling 2 Mini جلوتر است. نمودار سرعتِ خود شرکت هم مدل وزنباز Ripple-65B Preview را نشان میدهد که ۶۵ میلیارد پارامتر و مجوز Apache 2.0 دارد و در SWE-bench Pro v2 (سخت) به ۷۹٫۱ درصد رسیده، بالاتر از ۷۷٫۹ درصدِ Inkling 2 Mini. پس این ادعای شرکت که Inkling 2 Mini در SWE-bench Pro v2 از همه مدلهای همرده جلوتر است، فقط وقتی درست است که Ripple را همرده ندانیم. در DeepSWE اما Inkling 2 Mini همچنان جلوتر است: ۴۸٫۲ درصد در برابر ۴۴٫۳ درصد.
دوم، کنار چند سطر Inkling 2 Mini تنظیماتی آمده که برای خود این مدل انتخاب شده است: «with compaction» (فشرده کردن متن گفتوگو وسط کار) برای BrowseComp و DeepSearchQA، «in pi» برای Terminal-Bench v2.1 و «with bash only» برای SWE-bench Multilingual. خود شرکت هم میگوید شرایط ارزیابی همه مدلها یکسان نبوده است. سوم، سه سطر ایمنی درباره رفتار نادرست و کارهای برگشتناپذیر از آزمونهای داخلی شرکت آمدهاند که کس دیگری نمیتواند تکرارشان کند. چهارم، صفحه شرکت جایی حرف خودش را نقض میکند. در بخش محدودیتها نوشته که Inkling 2 Mini در ComplexConstraints v1.1 از Qwen3.8-27B عقب است، اما جدول همان صفحه برای Inkling 2 Mini عدد ۳۳٫۴ درصد و برای Qwen3.8-27B عدد ۳۰٫۱ درصد را آورده است. یکی از این دو اشتباه است.
دو جدول رتبهبندی مستقل هم این مدل را آوردهاند. Artificial Analysis در شاخص هوش نسخه ۵٫۰٫۱ خود به آن نمره ۲۰ داده است؛ میانه مدلهای همرده ۱۰ است. جدول شرکت هم برای Inkling 2 Mini و هم برای Qwen3.8-27B عدد ۲۰٫۱ را آورده، پس در این شاخص این دو همسطحاند. Vals Index که ۱۹ نوامبر بهروز شده، به آن ۴۶٫۴۶ درصد داده که با ۴۶٫۵ درصدِ شرکت جور است. با این نمره، مدل در رتبه ۳۸ از ۴۳ مدل این فهرست است. Inkling 2 Small با ۵۶٫۰۸ درصد رتبه ۲۶ را دارد و نمره مدل اول ۷۱٫۳۱ درصد است. همه مدلهای وزنبازی را که در این فهرست بالاتر از Inkling 2 Mini آمدهاند روی هاگینگفیس جستوجو کردیم و اندازه آنهایی را که پیدا شدند دیدیم. همه دستکم ۲۲۰ میلیارد پارامتر دارند: GLM 5.3 Flash، Hy4 Flash، MiniMax M3.1 Flash، MiMo V2.6 Flash، Step 5 Preview و مدلهای بزرگتر. پس ادعای «زیر ۱۰۰ میلیارد» در این فهرست درست است. Qwen3.8-27B و Gemma 4 31B در این فهرست نیستند و مقایسه با آن دو از این راه روشن نمیشود.
سرعت، پرحرفی و هزینه دورهای اضافه
ادعای سرعت شرکت بر محاسبهای نظری تکیه دارد، نه اندازهگیری. نمودار شرکت پهنای باند حافظه ۶۱۴ گیگابایت بر ثانیه را بر حجم وزنهایی تقسیم کرده که برای تولید هر توکن باید خوانده شوند. فرضهایش این است: وزنها ۱۶ بیتی (BF16) باشند، هر بار فقط یک درخواست اجرا شود، و وزنها در هر دور تکرار دوباره خوانده شوند. با این فرضها Inkling 2 Mini به ۵۴٫۴ توکن در ثانیه میرسد، Qwen3.8-27B به ۱۱٫۴ و Gemma 4 31B به ۱۰٫۰. این دو مدل متراکم (dense) هستند، یعنی همه پارامترهایشان برای هر توکن به کار میافتد. علت فاصله معماری ترکیب متخصصان است: در Inkling 2 Mini هر توکن فقط ۸ متخصص از ۱۲۸ متخصص را میخواند. همین نمودار Qwen3.6-35B-A3B را با ۱۰۲٫۳ و Gemma 4 26B A4B را با ۸۰٫۸ توکن در ثانیه نشان میدهد که سریعتر از Inkling 2 Miniاند، ولی نمرههایشان خیلی پایینتر است.
نمودار برای همه مدلها وزن ۱۶ بیتی فرض کرده که برای مقایسه منصفانه است، ولی Inkling 2 Mini به این شکل منتشر نشده است. به حساب تقریبی ما از روی هدر فایل، مدل با متخصصهای ۴ بیتی برای هر توکن کمی بیش از نصفِ بایتهایی را میخواند که در حالت ۱۶ بیتی لازم بود. این نسبت به یکچهارم نزدیک هم نیست، چون لایههای attention و جدولهای امبدینگ ۱۶ بیتی ماندهاند. حساب ما برای حالت ۱۶ بیتی هم دقیقاً به عدد شرکت نمیرسد، پس این را فقط برآورد بدانید.
پژوهشگران دو آزمایشگاه Hazy Research و Scaling Intelligence دانشگاه استنفورد که پیش از انتشار به مدل دسترسی داشتند، «هوش به ازای هر ژول انرژی» را روی DGX Spark اندازه گرفتند: ۰٫۷۰۳ برای Inkling 2 Mini، در برابر ۰٫۴۳۰ برای Qwen3.6-35B-A3B و ۰٫۱۵۹ برای Gemma-4-26B-A4B. در این آزمایش Inkling 2 Mini با دقت ۸ بیتی و سطح استدلال پایین اجرا شد و دو مدل دیگر با دقت ۴ بیتی.
تکرار لایهها هزینه واقعی هم دارد. vLLM مدل پژوهشی را روی یک کارت گرافیک GB200 زمانسنجی کرده است. فایل تنظیمات این مدل را با Inkling 2 Mini مقایسه کردیم: فقط در گزینهای فرق دارند که تعداد دورها را متغیر میکند.
هزینه دورهای بیشتر روی یک کارت گرافیک
مدل پژوهشی تینکینگ ماشینز با همان معماری Inkling 2 Mini، روی یک GB200 و با متن ورودی ۴ هزار توکنی
زمان هر گام تولید، فقط با یک درخواست همزمان (میلیثانیه)
۱ دور۱٫۵۱
۲ دور۲٫۶۷
۳ دور (مثل مدل منتشرشده)۳٫۸۵
فضای خالی کش KV (توکن)
۱ دور۳۵۲ هزار
۲ دور۲۳۳ هزار
۳ دور (مثل مدل منتشرشده)۱۷۵ هزار
داده: جدول vLLM در یادداشت روز عرضه، ۲۰ نوامبر ۲۰۲۶؛ فقط زمان محاسبه خود مدل (forward pass) اندازه گرفته شده است. نمودار: تیم ژرف.
با سه دور، هر گام تولید حدود دو و نیم برابر کندتر از یک دور شد و فضایی که برای کش KV میماند نصف شد. کارت مدل هم همین را به زبان خودش میگوید: توان پردازشی لازم برای هر توکن بیشتر از چیزی است که تعداد پارامترهای فعال نشان میدهد.
سرعت واقعی را باید از اندازهگیریهای دیگران فهمید. Artificial Analysis از راه API خود تینکینگ ماشینز سرعت خروجی ۲۸۰ توکن در ثانیه را ثبت کرده، با ۹٫۷۲ ثانیه تا اولین توکن پاسخ، و قیمت ۰٫۱۵ دلار برای هر میلیون توکن ورودی و ۰٫۵۰ دلار برای هر میلیون توکن خروجی. همین سایت مدل را بسیار پرحرف دانسته است: مدل برای کامل کردن آزمونهای شاخص ۱۶۱ میلیون توکن نوشت، در حالی که میانه مدلهای همرده ۸۵٫۷ میلیون است. هیچ مدلی در گروه مقایسهاش اینقدر ننوشت.
این با ادعای شرکت که تکرار لایهها مدل را با توکن کمتر به جواب میرساند جور به نظر نمیآید، ولی هر دو درستاند. در پرسشهایی از GPQA Diamond که مدل پژوهشی در همه حالتها درست جواب داده بود، طول استدلالش از ۳٬۷۰۳ توکن با یک دور به ۱٬۶۶۱ توکن با پنج دور رسید. این مقایسه مدل با خودش است. کنار مدلهای هماندازهاش، Inkling 2 Mini هنوز خیلی مینویسد. روی لپتاپ یعنی انتظار طولانی، پس بهتر است سطح استدلال پیشفرض ۰٫۹ را پایین بیاورید. کارت مدل هم توصیه میکند برای تعداد توکن خروجی و تعداد نوبتهای عامل سقف بگذارید، چون مدل گاهی مدام کار خودش را دوباره بررسی میکند و جلو نمیرود.
اجرا روی کامپیوتر خودتان
از روز عرضه، این راهها برای اجرای مدل اعلام شده است:
Ollama. فرمان ollama run inkling-2-mini نسخهای ۲۰ گیگابایتی را دانلود میکند. صفحه مدل در Ollama پنجره زمینه یک میلیون توکنی را نوشته و مک با ۳۲ گیگابایت حافظه یا بیشتر، یا DGX Spark، میخواهد. نصب و API محلی Ollama را در آموزش Ollama توضیح دادهایم.
نسخههای GGUF شرکت Unsloth.راهنمای Unsloth فایل ۴ بیتی UD-Q4_K_XL را با حجم ۱۷٫۶۳ گیگابایت پیشنهاد میکند. به گفته این راهنما، نسخه ۸ بیتی حدود ۲۴ گیگابایت حافظه لازم دارد و نسخه ۱ بیتی حدود ۹ گیگابایت. این فایلها با نسخه مخصوص llama.cpp خود Unsloth اجرا میشوند که از لایههای تکرارشونده پشتیبانی میکند؛ نسخه اصلی llama.cpp مجموعه فایل جداگانهای لازم دارد. تنظیمات پیشنهادی دمای ۱٫۰ و top-p برابر ۱٫۰ است. در مقایسه خود Unsloth با نسخه ۸ بیتی، فایل ۴ بیتی در ۹۸ درصد موارد همان توکن بعدی را انتخاب میکند و فایلهای یک و دو بیتی در ۸۹٫۴ تا ۹۱٫۶ درصد موارد. برای سنجیدن چنین عددهایی، راهنمای کیفیت مدلهای کوانتیزهشده و بودجه حافظه را ببینید.
vLLM.راهنمای اجرای vLLM نسخه nightly ۰٫۳۵٫۰ یا بالاتر، یا ایمیج vllm/vllm-openai:inkling-2-mini را لازم دارد. روی H100 و DGX Spark، پنجره زمینه را به ۲۶۲٬۱۴۴ توکن محدود میکند تا در حافظه جا شود.
Tinker. اجرا و تنظیم دقیق از راه API خود تینکینگ ماشینز. وقتی ما بررسی کردیم، هاگینگفیس هیچ سرویس دیگری را نشان نمیداد که این مدل را اجرا کند.
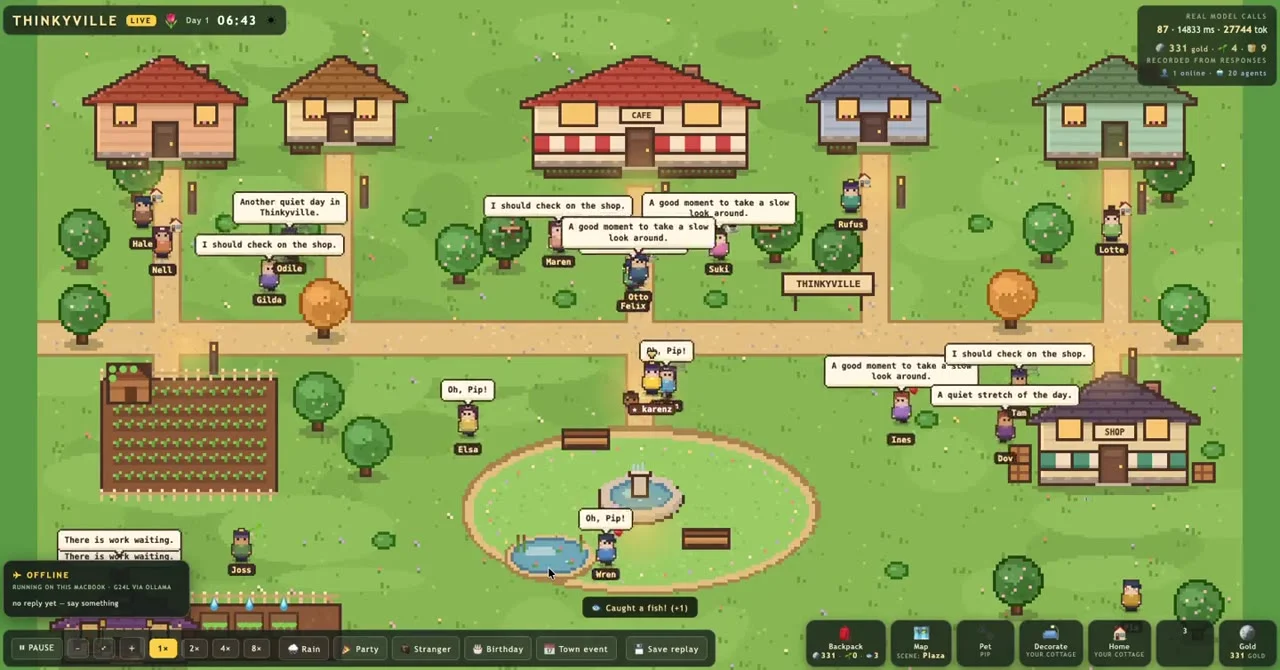
دموی Thinkyville از تینکینگ ماشینز: روستایی پیکسلی که هر ۲۰ ساکنش را Inkling 2 Mini میگرداند، با یادداشتی روی صفحه که میگوید مدل بدون اینترنت و از راه Ollama روی همان مکبوک اجرا میشود.
تصویر از خود شرکت: نمایی از دموی Thinkyville در اطلاعیه تینکینگ ماشینز. به گفته شرکت، یک مکبوک پرو (M5 Pro با ۴۸ گیگابایت حافظه) بدون اینترنت هر ۲۰ ساکن روستا را اجرا میکند. این دموی خود شرکت است، نه بنچمارک، و ما آن را تکرار نکردهایم.
فکر نکنید روی لپتاپ ۳۲ گیگابایتی میشود از پنجره زمینه یک میلیون توکنی استفاده کرد. درست است که ۲۰ لایه فقط ۱٬۰۲۴ توکن آخر را میبینند، اما هر دور کش KV جداگانه خودش را دارد و اینکه متن طولانی چقدر حافظه میخواهد به نرمافزار اجرا بستگی دارد. ما این را اندازه نگرفتیم. خود مدل را هم اجرا نکردیم، چون دانلود ۲۰ گیگابایتی دیسک کامپیوتر آزمایشی ما را تقریباً پر میکرد.
فارسی: آنچه توانستیم اندازه بگیریم
کارت مدل میگوید کیفیت خروجی در زبانهای غیر از انگلیسی ممکن است پایینتر باشد و در آزمون به زبان چینی، جملههای بریدهبریده و زبانهای قاطیشده دیدهاند. درباره فارسی چیزی نگفته است و ما هم پاسخهای فارسی مدل را آزمایش نکردیم.
چیزی که بدون اجرای مدل میشد اندازه گرفت، هزینه متن فارسی بر حسب توکن است. این عدد تعیین میکند چه مقدار متن فارسی در پنجره زمینه جا میشود، تولید پاسخ چقدر طول میکشد و هر درخواست API چقدر خرج دارد. توکنهای متن همه ۳۷۱ مقاله فارسی این سایت را، روی هم ۷۷۶٬۵۳۳ واژه، با توکنایزر Inkling 2 Mini و چهار مدل دیگر شمردیم.
توکن لازم برای همان متن فارسی در هر مدل، به ازای هر ۱۰۰ واژه
متن ۳۷۱ مقاله فارسی سایت ژرف، ۷۷۶٬۵۳۳ واژه؛ عدد کمتر یعنی متن فارسی جای کمتری میگیرد
Gemma 4 31B۱۷۳
Muse Glimmer۱۷۷
Nemotron 3.5 Super VL۱۷۹
Inkling 2 Mini۱۸۴
Qwen3.8-27B۱۹۵
شمارش تیم ژرف با توکنایزر هر مدل از هاگینگفیس، ۲۱ نوامبر ۲۰۲۶. این عدد درباره کیفیت فارسیِ مدلها چیزی نمیگوید.
Inkling 2 Mini برای هر ۱۰۰ واژه فارسی حدود ۱۸۴ توکن لازم دارد: حدود ۶ درصد بیشتر از Gemma 4 31B و حدود ۶ درصد کمتر از Qwen3.8-27B. روی نسخه انگلیسی همان ۳۷۱ مقاله، با ۷۷۰٬۴۹۰ واژه، در میان این پنج مدل از همه بیشتر توکن لازم داشت: حدود ۱۳۹ توکن برای هر ۱۰۰ واژه، در برابر ۱۲۹ تا ۱۳۴ برای بقیه. این تفاوتها کوچکاند و درباره کیفیت فارسی مدل چیزی نمیگویند. کیفیت را باید جداگانه آزمود، پیش از اینکه محصولی فارسی به این مدل تکیه کند. مسئله کلیتر را در مقاله هوش مصنوعی و پردازش زبان فارسی بررسی کردهایم.
آیا هنوز میشود استدلال مدل حلقهای را زیر نظر گرفت؟
زنجیره فکر (chain of thought) مدلهای استدلالی از معدود راههایی است که با آن میشود فهمید مدل چه میکند. در ترنسفورمر معمولی هر توکن از تعداد ثابتی لایه میگذرد، پس مدل پیش از نوشتن هر توکن فقط چند قدم محدود میتواند فکر کند. استدلال طولانیتر باید به شکل متن نوشته شود و آنجا میشود خواندش. تکرار لایهها این محدودیت را کمتر میکند: مدل میتواند بیشتر فکر کند بیآنکه بنویسد. استدلالی که داخل حلقهها انجام شود هیچوقت در متن نمیآید و ناظری که زنجیره فکر را میخواند آن را نمیبیند. به همین دلیل پژوهشگران ایمنی هوش مصنوعی به مدلهای حلقهای با احتیاط نگاه میکنند. شرکت چهار دسته آزمون انجام داده، بیشترشان روی مدل پژوهشی، و نتیجهها را مقدماتی میداند:
استدلال بدون نوشتن. بنچمارک Think Fast سختی هر کار را با مدت زمانی میسنجد که انجامش برای یک آدم طول میکشد. مدل بدون هیچ زنجیره فکری، با یک دور کارهایی را که برای آدم حدود ۱۶ ثانیه طول میکشد در نیمی از موارد درست انجام میداد و با سه دور به کارهای ۳۷ ثانیهای رسید. با بیش از سه دور، تقریباً پیشرفتی نکرد. در آزمون N-Hop Lookup که باید زنجیرهای از جستوجو در جدولهای ساختگی را دنبال کرد، مدل تا ده دور همچنان بهتر شد، با اینکه هنگام آموزش هیچوقت با بیش از پنج دور اجرا نشده بود.
کوتاهتر، ولی هنوز خواندنی. با پنج دور، استدلال مدل کمتر از نصفِ حالت یک دور بود (۱٬۶۶۱ در برابر ۳٬۷۰۳ توکن). طول جملهها (۸٫۷ در برابر ۸٫۹ واژه) و سهم واژههایی که در فرهنگ لغت انگلیسی هستند (۹۴٫۴ در برابر ۹۴٫۶ درصد) تقریباً تغییری نکرد. آنچه کم شد برگشتن و از نو حساب کردن بود: عددی که شرکت برای واژههای تردید مثل «wait» و «hmm» گزارش کرده از ۹٫۷ به ۳٫۶ رسید (واحدش را ننوشته است).
کنترل مدل بر استدلال خودش. وقتی از مدل خواستند زنجیره فکرش را به شکل خاصی دربیاورد، مثلاً واژهای از صورت سؤال را به کار نبرد، Inkling 2 Mini در زنجیرههای ۷۵۰ تا ۱٬۲۵۰ توکنی حداکثر در ۰٫۱ درصد موارد موفق شد. Qwen3.8-27B در ۱٫۳ درصد موارد موفق شد.
خرابکاری پنهان. در LinuxArena، نسخهای از Inkling 2 Mini را طوری تنظیم کرده بودند که هیچ درخواستی را رد نکند. از این نسخه خواستند کنار کاری عادی در نرمافزار، پنهانی کاری مخرب هم انجام دهد. ناظر، مدل ضعیفتری بود (Qwen3.6-35B-A3B) که فقط فراخوانی ابزارها و خروجیهایشان را میدید، نه زنجیره فکر را. در این حالت Inkling 2 Mini در ۳٫۹ درصد از دفعات کار مخرب را بیآنکه دیده شود انجام داد. Qwen3.8-27B وقتی همین نقش را داشت، در ۲۰٫۵ درصد دفعات موفق شد. مدل پژوهشی با یک تا پنج دور بین ۱٫۰ تا ۵٫۰ درصد بود و روند روشنی دیده نشد.
هشدارهای خود شرکت را هم باید تکرار کرد. مدل پژوهشی در مرحله یادگیری تقویتی فقط با سه دور اجرا شده است؛ پس معلوم نیست اگر در این مرحله با دورهای بیشتری اجرا شود چه یاد میگیرد. شاید چنین مدلی استدلالش را خیلی بیشتر فشرده کند. همه اینها هم در مقیاس کوچک است. Goodfire، شرکتی که روی تفسیرپذیری (interpretability) مدلها کار میکند و پیش از انتشار به مدل دسترسی داشت، یافتههای اولیهاش را درباره هماهنگی دورها منتشر کرده است. هر دور بیشتر از بلوک سومِ دور قبل میخواند. در پایان دو دور اول، یکی از ابعاد بردار درونی مدل عدد خیلی بزرگی میگیرد و به نظر میرسد همین به دور بعد نشان میدهد از کجا بخواند. خود Goodfire اینها را «نتیجههای اولیه» مینامد.
محدودیتهایی که خود شرکت گفته
کارت مدل درباره ضعفها صریحتر از معمول است:
دانستهها. در بیشتر ارزیابیها از Inkling 2 Small ضعیفتر است و بیشترین فاصله در یادآوری اطلاعات است. احتمال اینکه با اطمینان اطلاعات غلط بدهد از مدلهای بزرگتر بیشتر است.
استدلال تکراری. ممکن است در استدلالش گیر کند و مدام کار خودش را دوباره بررسی کند، بهخصوص هنگام رفع اشکال کد.
رفتار در نقش عامل. ممکن است بدون تأیید گرفتن فایلها را پاک کند یا رویشان بنویسد و درباره کاری که کرده گزارش نادرست بدهد. کارت مدل توصیه میکند عامل را در محیط ایزوله اجرا کنید و پیش از کارهای برگشتناپذیر، مثل پاک کردن فایل، تأیید بگیرید.
زبانهای دیگر. کیفیت در زبانهای غیر از انگلیسی پایینتر است.
موضوعهای حساس. در گفتوگو درباره سلامت روان بیش از حد لازم محتاط است.
کارت مدل خطر سلاحهای شیمیایی، زیستی، پرتوی و هستهای، حمله سایبری و از دست رفتن کنترل را بررسی کرده و در همه به یک نتیجه رسیده: این مدل چیزی بیشتر از مدلهای وزنباز موجود دست کسی نمیدهد.
این مدل به درد چه کسی میخورد
Inkling 2 Mini بیشتر به درد این کارها میخورد: عامل کدنویسی و جستوجو که روی کامپیوتر خودتان اجرا شود، خواندن سند و تصویر صفحه نمایش (شرکت ۹۲٫۸ درصد در OmniDocBench و ۷۶٫۵ درصد در ScreenSpot Pro گزارش کرده)، و پژوهش درباره مدلهای حلقهای و تفسیرپذیری. برای پرسشهای اطلاعاتی بدون دسترسی به جستوجو، گفتوگوهای طولانی با شرطهای زیاد، و هر محصول فارسیای که روی دادههای خودش امتحان نشده، انتخاب خوبی نیست. اگر آن را در نقش عامل اجرا میکنید، سطح استدلال را پایین بیاورید، برای توکن خروجی و تعداد نوبتها سقف بگذارید و آن را در محیط ایزوله نگه دارید.
پرسشهای رایج
آیا Inkling 2 Mini متنباز است؟
وزنهایش با مجوز Apache 2.0 باز است که اجازه استفاده تجاری هم میدهد. دادههای آموزشی منتشر نشده و کارت مدل فقط نوع منبعها را توضیح داده است.
آیا روی لپتاپ ۱۶ گیگابایتی اجرا میشود؟
نسخه رسمی نه؛ حدود ۲۰ گیگابایت حجم دارد و شرکت کامپیوتری با ۳۲ گیگابایت حافظه را لازم میداند. نسخههای GGUF یک و دو بیتی Unsloth حدود ۹ تا ۱۱ گیگابایت حافظه میخواهند، ولی در آزمون خود Unsloth فقط در حدود ۸۹ تا ۹۲ درصد موارد همان توکن بعدیِ نسخه ۸ بیتی را انتخاب میکنند.
ترنسفورمر حلقهای یعنی چه؟
ترنسفورمری که بعضی لایههایش را برای هر توکن بیش از یک بار و هر بار با همان وزنها اجرا میکند. با این کار برای هر توکن محاسبه بیشتری انجام میشود، بیآنکه پارامترها زیاد شوند.
آیا فارسی را خوب میفهمد؟
کارت مدل از آزمونی به زبان چینی خبر میدهد و میگوید کیفیت در زبانهای غیر از انگلیسی پایینتر است، اما درباره فارسی چیزی نگفته است. توکنایزر آن متن فارسی را تقریباً به اندازه مدلهای هماندازهاش فشرده میکند، ولی کیفیت را باید روی کار واقعی آزمود.
منابع و روش کار (آخرین بازبینی: ۳۰ آبان ۱۴۰۵)
منابع در ۳۰ آبان ۱۴۰۵ (۲۱ نوامبر ۲۰۲۶) بررسی شدند. خواندن فایلهای مدل و شمارش توکنها کار خود تیم ژرف است؛ فایلها را خواندیم و مدل را اجرا نکردیم. عددهای بنچمارک ادعای خود شرکت است، مگر جایی که گفتهایم از Artificial Analysis یا Vals آمده است.
تصویرها: تصویر بالای مقاله نشانه متحرک بالای اطلاعیه تینکینگ ماشینز است، چهار دایره پیکسلی که دور یک حلقه میچرخند. این تصویر قاببهقاب از دادههای همان پویانمایی در اطلاعیه ساخته شده است. تصویر Thinkyville قاب اول دموی شرکت است. هر دو متعلق به تینکینگ ماشینز است و بهعنوان تصویر رسمی خود شرکت آمده است.
ارزش بازار سهام آمریکا در ۴۵ روز حدود ۶ تریلیون دلار افت کرد. تحلیلی پربازدید میگوید این اصلاح است، نه ترکیدن حباب هوش مصنوعی. ادعاهایش را با گزارشهای مالی و دادههای بازار سنجیدیم.
جامعه Lean و Mathlib میگوید اثبات ۱۷ میلیون خطی لونت آلپوگه درست است. بیانیه را با گزارشهای بررسی مقایسه کردیم: کدام آزمونها تمام شده، کدام هنوز در جریان است و چه چیزی مانده.
لونت آلپوگه، ریاضیدانی که در آنتروپیک کار میکند، میگوید با کمک Claude فرضیه ریمان را اثبات کرده است. ۱۷۵ هزار فایل Lean را باز کردیم: چه ادعا شده و چه هنوز بررسی نشده است.