اگر میخواهید ایجنت برنامهنویسیای مثل Qwen Code یا OpenCode را روی مدلی اجرا کنید که وزنهایش را خودتان در اختیار دارید، امروز سه خانواده بیش از بقیه مطرحاند: Qwen3.8 از تیم Qwen، GLM-5.2 از Z.ai و DeepSeek-V4. وزن هر سه منتشر شده است، اما اندازه، مجوز و سختافزار لازمشان تفاوت زیادی دارد؛ از مدلی که روی دو کارت گرافیک خانگی اجرا میشود تا مدلی که چند ترابایت حجم دارد. این راهنما به یک پرسش عملی جواب میدهد: روی سرور خودتان کدام را اجرا کنید و چطور.
همه اندازهها، مجوزها و طول پنجره متنی در ۶ مهر ۱۴۰۵ (۲۸ سپتامبر ۲۰۲۶) از کارت رسمی هر مدل در Hugging Face، مخزن رسمی GLM و صفحه تغییرات رسمی API دیپسیک خوانده شدهاند. از مرداد تا امروز هر سه خانواده نسخه تازه گرفتهاند، یعنی GLM-5.3 و DeepSeek-V4.1-Flash؛ این نسخهها را هم در جای خودشان آوردهایم.
 تصویر رسمی DeepSeek
تصویر رسمی مستندات API دیپسیک.
مدل با ایجنت فرق دارد
مدل زبانی فقط متن و درخواست فراخوانی ابزار تولید میکند. ایجنتی مثل Qwen Code، OpenCode یا Hermes Agent تعیین میکند مدل کدام فایلها را ببیند، کدام فرمان را اجرا کند، پیش از چه کارهایی اجازه بگیرد و وقتی گفتوگو طولانی شد، چه چیزی را خلاصه کند.
به همین دلیل یک مدل ممکن است در یک ایجنت عالی کار کند و در دیگری ضعیف. تفاوت معمولاً از اینجاها میآید: شکل تعریف ابزارها و درخواستهای سیستمی ایجنت، اینکه ایجنت حالت استدلال مدل را درست پشتیبانی میکند یا نه، نحوه مدیریت پنجره متنی و تنظیمات سرور مدل. پس هر مدلی را در همان ایجنتی بسنجید که قرار است تیم با آن کار کند.
پاسخ کوتاه: روی سرور خودتان کدام مدل؟
اگر فقط یک جمله میخواهید: با Qwen/Qwen3.8-27B شروع کنید. جزئیات بر اساس سختافزاری که دارید:
- یک سرور با یک یا دو کارت گرافیک:
Qwen/Qwen3.8-27B. مدلی متراکم با ۲۷ میلیارد پارامتر، مجوز Apache 2.0 و پنجره متنی ۲۶۲ هزار توکنی که تصویر و ویدئو را هم میفهمد. نسخه آن در Ollama حدود ۱۸ گیگابایت است و دستورالعمل رسمی vLLM نسخه فشردهشده آن را روی دو کارت RTX 5090 آزموده است.
- یک سرور قوی با چند کارت گرافیک مرکز داده:
deepseek-ai/DeepSeek-V4-Flash-0731. مدلی با ۲۸۴ میلیارد پارامتر که در هر توکن فقط ۱۳ میلیارد آن فعال میشود، با پنجره یک میلیون توکنی و مجوز MIT. فایلهای وزن آن حدود ۱۶۷ گیگابایت است و کارت مدل، فرمان اجرایش را برای یک سرور با چهار کارت GB300 آورده است.
- خوشه چندسروری: GLM-5.2 یا GLM-5.3 با ۷۴۴ میلیارد پارامتر، یا بزرگترین عضو خانواده Qwen3.8 با ۲٫۴ هزار میلیارد پارامتر. اینها برای تیمی مناسباند که زیرساخت مرکز داده دارد.
اگر هیچ سختافزاری ندارید، راه دیگر سرویسی است که یکی از همین مدلها را با رابط سازگار با OpenAI ارائه میدهد؛ سرویسی را انتخاب کنید که درباره محل و مدت نگهداری داده شما پاسخ مکتوب بدهد. هر گزینهای انتخاب کنید، تصمیم نهایی را آزمون روی مخزن خودتان میگیرد، نه جدول بنچمارک.
جدول مقایسه مدلهای باز
این جدول فقط مدلهایی را آورده است که وزنشان برای اجرا روی سرور شخصی منتشر شده است. «فعال» یعنی تعداد پارامترهایی که در پردازش هر توکن به کار میروند و حجم وزنها جمع فایلهای مدل در Hugging Face در روز بازبینی است.
| مدل | کل پارامتر و بخش فعال | مجوز | پنجره متنی | حجم وزنها | ورودی |
|---|
Qwen/Qwen3.8-27B | ۲۷ میلیارد، متراکم | Apache 2.0 | ۲۶۲ هزار توکن، قابل افزایش تا حدود یک میلیون | حدود ۵۶ گیگابایت (نسخه FP8 حدود ۳۱) | متن، تصویر، ویدئو |
Qwen/Qwen3.8-2.4T-A95B | ۲٫۴ هزار میلیارد، ۹۵ میلیارد فعال | Qwen3.8-Max License | ۲۶۲ هزار توکن، قابل افزایش | حدود ۲٬۵۰۰ گیگابایت در نسخه FP8 | فقط متن |
zai-org/GLM-5.2 | ۷۴۴ میلیارد، ۴۰ میلیارد فعال | MIT | یک میلیون توکن | حدود ۷۵۶ گیگابایت در نسخه FP8 | متن |
deepseek-ai/DeepSeek-V4-Flash-0731 | ۲۸۴ میلیارد، ۱۳ میلیارد فعال | MIT | یک میلیون توکن | حدود ۱۶۷ گیگابایت | متن |
deepseek-ai/DeepSeek-V4.1-Flash | ۵۵۲ میلیارد، ۸ میلیارد فعال هنگام خواندن ورودی و ۱۶ میلیارد هنگام تولید | MIT | یک میلیون توکن | حدود ۵۱۰ گیگابایت | متن، تصویر |
عددهای بنچمارک را عمداً در جدول نیاوردهایم. هر سازنده مدل خودش را با ایجنت و تنظیمات متفاوتی سنجیده است و این عددها را نمیشود کنار هم گذاشت.
Qwen3.8: از مدل ۲۷ میلیاردی تا ۲٫۴ هزار میلیاردی
تیم Qwen از مرداد ۱۴۰۵ چند مدل از خانواده Qwen3.8 را روی Hugging Face منتشر کرده است و آن را توانمندترین نسل مدلهای باز Qwen تا امروز میداند. طبق کارت رسمی Qwen3.8-27B، این مدل بهطور پیشفرض با حالت استدلال کار میکند و عمق استدلال با پارامتر reasoning_effort در سه سطح xhigh (پیشفرض)، medium و low تنظیم میشود. کارت مدل برای حالت استدلال این تنظیم نمونهبرداری را پیشنهاد میکند: temperature=1.0، top_p=0.95 و top_k=20. همچنین هشدار میدهد که در کارهای چندمرحلهای ایجنت، پایین آوردن سطح استدلال همیشه کار را سریعتر تمام نمیکند، چون ممکن است به تلاشهای تکراری بیشتری برسد.
برای استفاده تجاری، به مجوز هر عضو این خانواده جداگانه نگاه کنید:
Qwen/Qwen3.8-27B با Apache 2.0 منتشر شده است و محدودیت خاصی برای استفاده تجاری ندارد.Qwen/Qwen3.8-2.4T-A95B مجوز جداگانهای به نام Qwen3.8-Max دارد. اگر شرکت شما سرویس ارائه مدل یا دستیار هوشمند برنامهنویسی و کار اداری بفروشد و درآمدش در ۱۲ ماه از ۵۰ میلیون دلار بگذرد، باید مجوز جداگانه بگیرد. این مدل فقط متن میپذیرد و حالت استدلالش را نمیشود خاموش کرد.Qwen/Qwen3.8-Flash-Next پیشنمایش آزمایشی معماری نسل بعدی است: ۱۲۵ میلیارد پارامتر که ۶ میلیارد آن فعال است، بهعلاوه ۵۱ میلیارد پارامتر جاسازی. مجوز آن Qwen Community License 1.0 است و سختگیرانهتر است: شرکتی که سرویس ارائه مدل یا دستیار هوشمند برنامهنویسی و کار اداری دارد، برای هر استفاده تجاری باید مجوز جداگانه بگیرد، مگر اینکه استفاده کاملاً داخلی باشد و مدل یا خروجیاش در اختیار هیچ شخص ثالثی قرار نگیرد.
اگر میخواهید روی مدلهای Qwen محصولی بسازید و به مشتری بفروشید، این تفاوت مجوزها مهمتر از چند درصد اختلاف در بنچمارک است.
 تصویر رسمی مستندات Qwen Code
.
GLM-5.2 و GLM-5.3
Z.ai مدل GLM-5.2 را در ۲۶ خرداد ۱۴۰۵ (۱۶ ژوئن ۲۰۲۶) معرفی کرد و در اطلاعیه رسمی GLM-5.2 آن را مدل اصلی خود برای کارهای طولانی و چندمرحلهای مینامد. طبق کارت رسمی GLM-5.2، مدل پنجره متنی یک میلیون توکنی پایداری دارد، سطحهای مختلف تلاش برای برنامهنویسی را پشتیبانی میکند و با مجوز MIT منتشر شده است. جدول مدلها در مخزن رسمی GLM اندازه آن را ۷۴۴ میلیارد پارامتر با ۴۰ میلیارد پارامتر فعال ثبت کرده است. برای اجرا، کارت مدل SGLang از نسخه 0.5.13.post1، vLLM از نسخه 0.23.0 و KTransformers را فهرست کرده است.
در شهریور ۱۴۰۵ نسخه GLM-5.3 منتشر شد. به گفته سازنده، همان مدل پایه GLM-5.2 است و همه پیشرفتش از آموزش پس از پیشآموزش آمده است؛ Z.ai میگوید در آزمون داخلی برنامهنویسی خودش ۵۰ درصد از GLM-5.2 بهتر عمل کرده است. مجوز GLM-5.3 دیگر MIT خالص نیست: شرکتی که سرویس ارائه مدل دارد و درآمد سالانهاش از ۱۰ میلیارد دلار بیشتر است، پیش از استفاده تجاری باید بازبینی امنیتی Z.ai را بگذراند. برای تقریباً همه شرکتها این شرط عملاً اعمال نمیشود. نسخه سبکتر GLM-5.3-Flash هم با ۳۲۰ میلیارد پارامتر و ۱۸ میلیارد پارامتر فعال و مجوز MIT منتشر شده است.
یک نکته برای کسانی که با Ollama کار میکنند: صفحه GLM-5.2 در Ollama فقط برچسب glm-5.2:cloud دارد، یعنی مدل روی سرورهای Ollama اجرا میشود و نه روی سرور شما. این مسیر، اجرای مدل روی سرور شخصی حساب نمیشود.
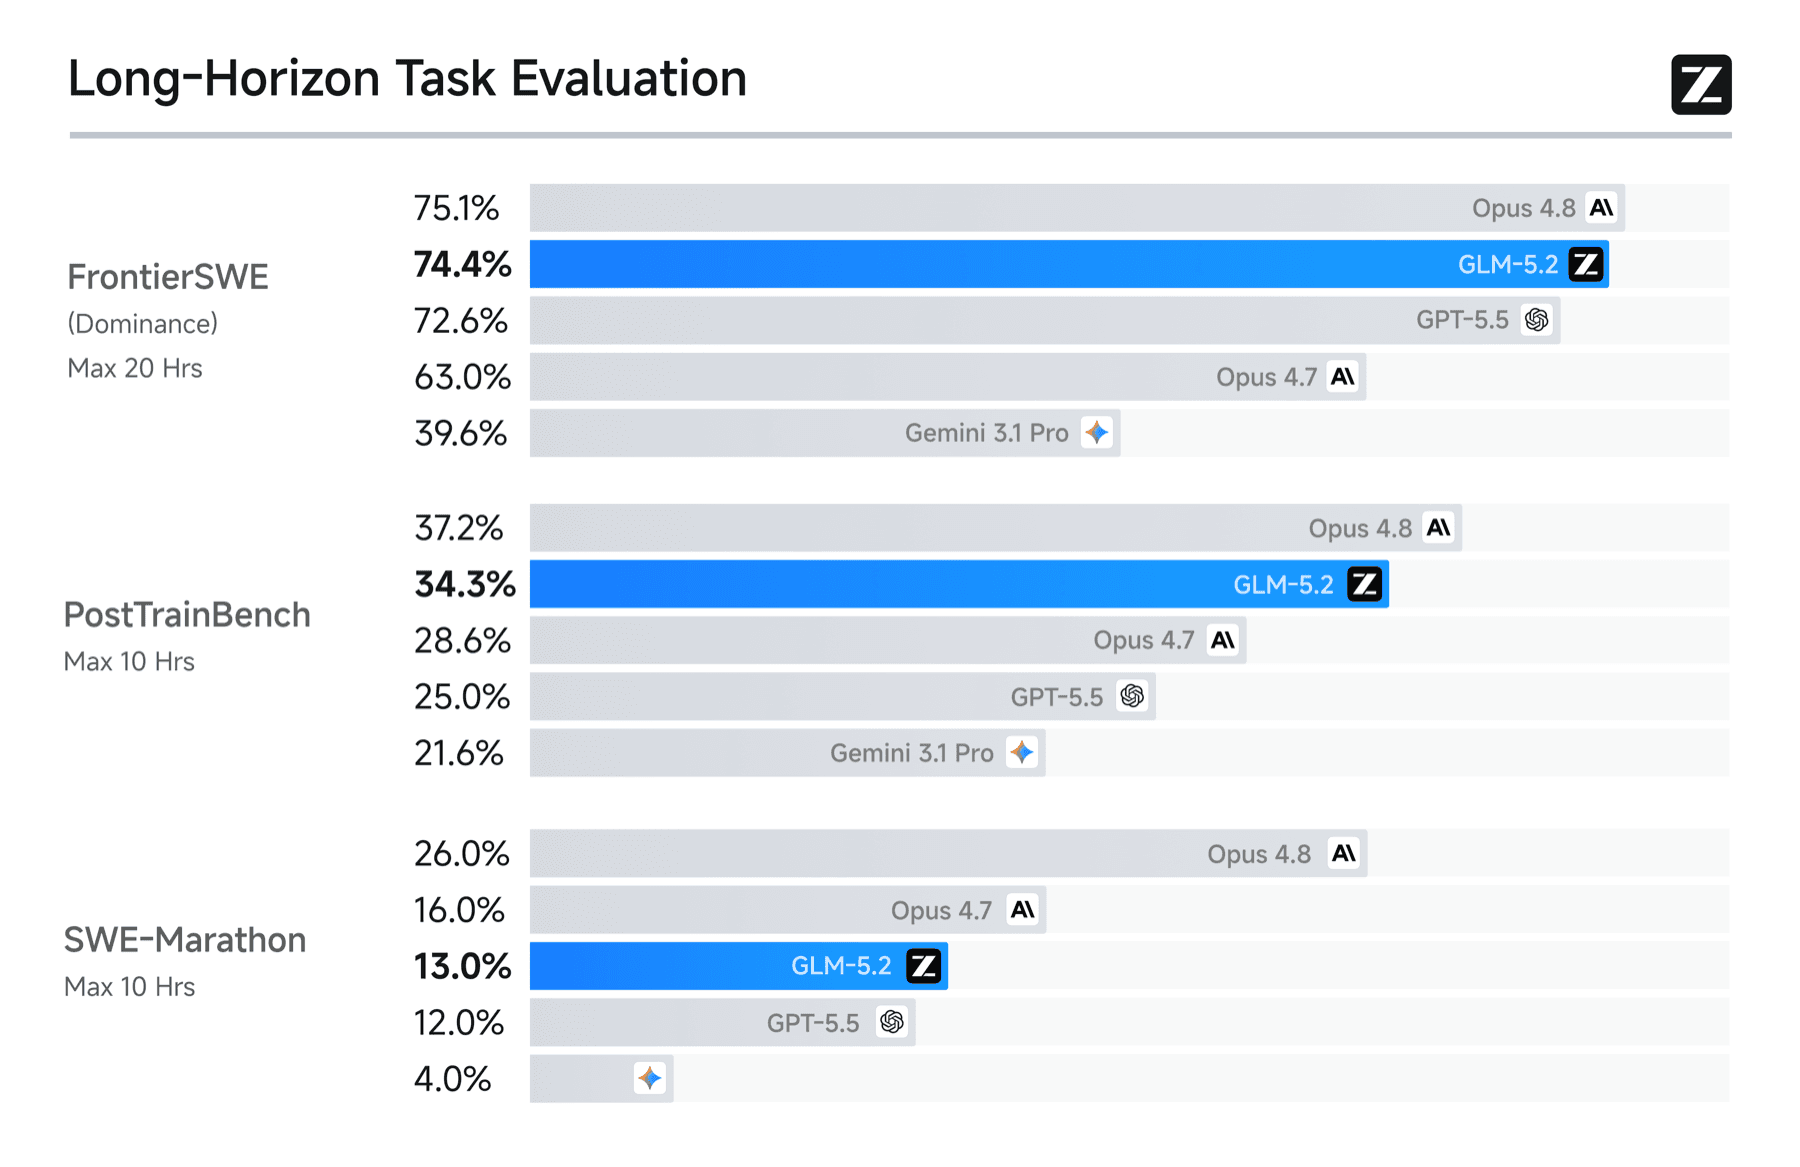 نمودار رسمی GLM-5.2 برای کارهای طولانی
نمودار رسمی Z.ai در معرفی GLM-5.2. عددها را سازنده گزارش کرده است و نتیجه مخزن شما را تضمین نمیکنند.
DeepSeek-V4 و DeepSeek-V4.1-Flash
دیپسیک در اردیبهشت ۱۴۰۵ (آوریل ۲۰۲۶) پیشنمایش خانواده V4 را منتشر کرد: V4-Pro با ۱٫۶ هزار میلیارد پارامتر و V4-Flash با ۲۸۴ میلیارد پارامتر، هر دو با پنجره یک میلیون توکنی و مجوز MIT. طبق کارت رسمی DeepSeek-V4-Flash-0731، این نسخه انتشار رسمی V4-Flash است و جای پیشنمایش را گرفته است؛ دیپسیک میگوید در آزمونهای فهرستشده خودش از پیشنمایش V4-Pro هم بهتر است. این نسخه قالب گفتوگوی آماده Jinja ندارد و بهجایش اسکریپتهای رمزگذاری پیام را در پوشه encoding گذاشته است، پس برای اجرا به دستورالعمل vLLM تکیه کنید. نمونهای که خود کارت مدل برای یک سرور با چهار کارت GB300 آورده، این است:
# From the DeepSeek-V4-Flash-0731 model card: one node with 4x GB300
vllm serve deepseek-ai/DeepSeek-V4-Flash-0731 \
  --trust-remote-code --kv-cache-dtype fp8 --block-size 256 \
  --data-parallel-size 4 --enable-expert-parallel \
  --moe-backend deep_gemm_mega_moe \
  --attention-config '{"use_fp4_indexer_cache": true}' \
  --speculative-config '{"method":"dspark","num_speculative_tokens":7,"draft_sample_method":"greedy"}'
در ۱۹ شهریور ۱۴۰۵ (۱۰ سپتامبر ۲۰۲۶) DeepSeek-V4.1-Flash منتشر شد. معماری آن تازه است، ۵۵۲ میلیارد پارامتر اصلی دارد، هنگام خواندن ورودی ۸ و هنگام تولید پاسخ ۱۶ میلیارد پارامتر فعال میکند، تصویر را هم بهطور بومی میفهمد و باز هم مجوز MIT دارد. سطح استدلال آن بهجای چند گزینه ثابت، عددی بین ۱ تا ۱۰۰ است. حجم وزنهایش حدود ۵۱۰ گیگابایت است، پس از V4-Flash-0731 سختافزار بیشتری میخواهد. معرفی کاملتر آن را در مقاله DeepSeek-V4.1-Flash نوشتهایم.
اگر با API دیپسیک هم کار کردهاید، به نام مدلها دقت کنید. طبق صفحه تغییرات API دیپسیک، نام تازه deepseek-flash است و deepseek-v4-flash فقط موقتاً به V4.1-Flash هدایت میشود. صفحه deepseek-v4-flash در Ollama هم اعلام کرده است که این مدل از ۳ مهر ۱۴۰۵ (۲۵ سپتامبر ۲۰۲۶) بازنشسته شده است.
چطور مدل را روی سرور خودتان اجرا کنید
دو راه اصلی وجود دارد و هر دو در نهایت یک رابط سازگار با OpenAI در اختیار ایجنت میگذارند.
Ollama برای شروع و آزمایش روی یک سرور. طبق صفحه Qwen3.8 در Ollama، یک فرمان کافی است:
ollama run qwen3.8
رابط سازگار با OpenAI در این حالت روی http://localhost:11434/v1 است. این راه برای آزمایش و استفاده یک یا چند نفر مناسب است.
vLLM برای تیم. وقتی چند نفر همزمان از مدل استفاده میکنند، vLLM یا SGLang انتخاب بهتری است. دستورالعمل رسمی vLLM برای Qwen3.8-27B این فرمان را روی دو کارت RTX 5090 و با پنجره کامل ۲۶۲ هزار توکنی آزموده است. وزنهای این نمونه نسخه فشردهشدهای است که Unsloth ساخته و حدود ۲۳ گیگابایت حجم دارد:
# Verified in the vLLM recipe on 2x RTX 5090 (tensor parallel across two cards)
vllm serve unsloth/Qwen3.8-27B-NVFP4 \
  --tensor-parallel-size 2 \
  --max-model-len 262144 \
  --kv-cache-dtype fp8 \
  --reasoning-parser qwen3 \
  --enable-auto-tool-choice --tool-call-parser qwen3_xml
دو پرچم آخر فراخوانی ابزار را روشن میکنند و ایجنت برنامهنویسی بدون آنها نمیتواند فایل بخواند یا فرمان اجرا کند. همین دستورالعمل میگوید روی یک کارت RTX 5090 فقط با پنجره ۳۲ هزار توکنی و پرچم --enforce-eager جا میشود. رابط vLLM بهطور معمول روی درگاه ۸۰۰۰ است و ایجنت باید به http://<server>:8000/v1 وصل شود.
اتصال ایجنت. برای Qwen Code، مدل را در بخش modelProviders با نوع openai تعریف کنید؛ طبق صفحه ارائهدهندگان مدل در Qwen Code، مقدار id باید همان نامی باشد که سرور مدل با آن شناخته میشود. در مثال بالا این نام unsloth/Qwen3.8-27B-NVFP4 است. فایل تنظیمات کامل و توضیح هر بخش را در آموزش Qwen Code آوردهایم.
سرور خودتان یا API میزبانیشده؟
وقتی مدل روی سرور خودتان اجرا میشود، کد و داده شما از شبکه سازمان بیرون نمیرود، نسخه دقیق مدل و زمان عوض کردنش را خودتان تعیین میکنید و در مصرف زیاد و پیوسته، بهجای پرداخت برای هر توکن، هزینه سختافزار را میپردازید. پیش از استفاده تجاری، متن مجوز همان نسخهای را که دانلود کردهاید با مشاور حقوقی مرور کنید؛ همانطور که دیدید، مجوز اعضای یک خانواده میتواند با هم فرق داشته باشد.
سرویسهای میزبانیشده همین سازندگان، یعنی سرویس ابری Qwen، API سکوی Z.ai و API دیپسیک، سریعترین راه برای امتحان یک مدلاند، اما کد شما به سرورهای آنها فرستاده میشود و شرایط و سیاست نگهداری داده خودشان حاکم است. پیش از اینکه مخزن واقعی را به آنها وصل کنید، این شرایط را بخوانید. برچسبهای cloud در Ollama هم مدل را روی سرورهای Ollama اجرا میکنند و جایگزین اجرای شخصی نیستند.
ارزیابی منصفانه روی مخزن خودتان
بهجای یک پرسش آزمایشی، چند کار واقعی از مخزن خودتان انتخاب کنید و هر مدل را با همانها بسنجید:
- شناخت کد: مسیر یک درخواست را از ورودی تا پایگاه داده، با ذکر فایلها و بدون هیچ ویرایشی توضیح دهد.
- رفع باگ: یک خطای شناختهشده را بازتولید کند، برایش تست بنویسد و کوچکترین اصلاح را انجام دهد.
- بازبینی: در یک تغییر آماده، مشکلی را که عمداً گذاشتهاید پیدا کند.
- کار طولانی: یک بازنویسی چندمرحلهای را با سقف زمان و توکن مشخص تمام کند.
- ادامه پس از قطع: بعد از خطای یک ابزار یا خلاصهشدن گفتوگو، کار را درست ادامه دهد.
برای اینکه مقایسه منصفانه باشد، این موارد را برای همه مدلها یکسان نگه دارید: نسخه مخزن و ایجنت، فایل دستورکار پروژه، حالت مجوز، سطح استدلال، طول پنجره متنی روی سرور، و سقف زمان و نوبت. هر آزمون را بیش از یک بار اجرا کنید، چون نتیجه ایجنتها از اجرایی به اجرای دیگر فرق میکند. آنچه را میسنجید هم از پیش بنویسید: درصد کارهایی که بدون اصلاح پذیرفته شدند، تعداد اصلاحیههای بازبین، فایلهایی که بیجهت تغییر کردند، زمان کل و مصرف توکن.
خطاهای رایج در انتخاب و اجرای مدل
یکی گرفتن وزن باز با مجوز آزاد: اینکه وزن مدلی قابل دانلود است به این معنا نیست که برای هر کار تجاری آزاد است. مجوز هر نسخه را جدا بخوانید.
اجرای سرور بدون فراخوانی ابزار: اگر vLLM را بدون پرچمهای فراخوانی ابزار اجرا کنید، مدل در گفتوگوی ساده خوب جواب میدهد، اما ایجنت نمیتواند با آن کار کند.
اعتماد به عدد پنجره متنی: پشتیبانی از یک میلیون توکن یعنی سقف ممکن، نه اینکه روی سختافزار شما جا شود یا فرستادن کل مخزن در هر درخواست نتیجه را بهتر کند. طول پنجره را متناسب با حافظه کارت گرافیک تنظیم کنید.
برداشتن برچسب cloud بهجای مدل محلی: در Ollama، برچسبهای cloud روی سرورهای Ollama اجرا میشوند. اگر هدف اجرای شخصی است، فقط برچسبهایی را بردارید که حجم و فایل دانلودی دارند.
قبول بنچمارک سازنده بهجای آزمون خودتان: عددهای کارت مدل برای کوتاه کردن فهرست گزینهها مفیدند، اما آماده بودن برای تیم را آزمون روی مخزن خودتان تعیین میکند.
راهاندازی مدل باز برای تیم برنامهنویسی
انتخاب مدل فقط نیمی از کار است. پیش از اینکه ایجنت برنامهنویسی با مدل شخصی در اختیار تیم قرار بگیرد، این تصمیمها را بگیرید:
- مجوز مدل: نسخه دقیق مدل و متن مجوزش را ثبت کنید و مطمئن شوید با کاربرد سازمانتان جور است؛
- ظرفیت سرور: تعداد کاربران همزمان و طول پنجره متنی لازم را برآورد کنید و سختافزار را بر همان اساس انتخاب کنید؛
- یک نشانی واحد برای مدل: سرور مدل پشت یک رابط داخلی با احراز هویت و ثبت درخواستها قرار بگیرد تا عوض کردن مدل فقط با تغییر تنظیمات ممکن باشد؛
- دستورکار و مجوزهای مشترک: یک
QWEN.md یا AGENTS.md در git و قانونهای مجوز یکسان برای همه؛
- قانون بازبینی: هیچ تغییری بدون بازبینی انسانی ادغام نشود؛
- سقف هزینه ماهانه به تومان: اجاره یا استهلاک سرور، برق و نگهداری را حساب کنید و با هزینه API میزبانیشده مقایسه کنید؛
- سنجش پیش و پس: زمان و کیفیت چند کار تکراری تیم را پیش و پس از راهاندازی اندازه بگیرید.
اگر میخواهید مدل مناسب تیم برنامهنویسی سازمانتان را انتخاب کنید، آن را روی سرور خودتان راهاندازی کنید و با قواعد روشن دسترسی و بازبینی به ایجنتهایی مثل Qwen Code وصل کنید، با ما صحبت کنید: تماس تلفنی با ۰۹۰۱ ۵۵۵ ۵۶۵۱ یا پیام در واتساپ. جزئیات این خدمت را در صفحه هوش مصنوعی محلی روی سرور سازمان هم میتوانید ببینید.
یادداشت منابع (بازبینیشده در ۶ مهر ۱۴۰۵ / ۲۰۲۶-۰۹-۲۸)
اندازهها، مجوزها، طول پنجره متنی و فرمانهای این راهنما در تاریخ بالا با این صفحههای رسمی تطبیق داده شد. حجم وزنها از فهرست فایلهای هر مدل در Hugging Face در همان روز جمع زده شده است.